ChartCoder
ChartCoder: Advancing Multimodal Large Language Model for Chart-to-Code Generation
Authors: Xuanle Zhao, Xianzhen Luo, Qi Shi, Chi Chen, Shuo Wang, Wanxiang Che, Zhiyuan Liu, Maosong Sun (Tsinghua University, Harbin Institute of Technology) — arXiv 2501.06598, ACL 2025.
차트→코드(chart-to-code) 논문임. 차트 이미지를 matplotlib 코드로 복원하는 첫 전용(dedicated) MLLM으로, 앞서 본 MSRL의 직계 선행 연구임(1저자 Xuanle Zhao 공통). MSRL이 “차트→코드 SFT를 데이터로 아무리 키워도 정체된다”를 진단하고 RL로 넘었다면, ChartCoder는 바로 그 정체 지점에 놓인 SFT+데이터 접근의 완성형임 — 코드 LLM을 언어 백본으로 깔아 실행 가능성을 높이고(DeepSeek Coder), 대규모·다양성 차트-코드 데이터(Chart2Code-160k)를 만들고, 생성을 단계별로 쪼개는 Snippet-of-Thought(SoT)로 핵심 정보를 강조함. 평가의 “렌더 후 원본과 비교”(render-and-compare) 철학은 MOCR의 ISVGEN·MSRL의 시각 보상과 같은 뿌리고, GPT-4o가 데이터를 만들고 평가까지 하는 자기 순환의 그림자도 함께 짊어짐.
1. 문제 정의
핵심 문제
차트 이미지를 그 차트를 재현하는 실행 가능한 코드(matplotlib) 로 변환하는 것이 핵심 문제임.
차트를 자연어로 설명하는 방식(chart-to-text)은 차트에 담긴 조밀한 정보를 다 담지 못해 손실적(lossy) 임. 반면 차트를 코드로 파싱하면 데이터·구조·스타일을 그대로 담는 무손실(lossless) 표현이 되어, 차트 이해와 재활용에 더 유리함. 그런데 기존 오픈소스 MLLM은 차트 이해(ChartQA)에는 강해도 차트→코드에는 약함.
기존 연구의 한계
기존 접근이 부딪힌 벽은 둘임.
1) 코드 생성 정렬 부재 → 낮은 실행률·부실한 복원 오픈소스 MLLM은 코드 생성 task에 잘 정렬돼 있지 않아, 차트를 코드로 옮길 때 실행 가능한 코드를 잘 못 만들고 세부(차트 유형·좌표·데이터)를 놓침. 근본 원인은 백본에 있음 — 일반 LLM은 사전학습 코퍼스에서 코드 비중이 낮아 코딩 능력 자체가 제한됨. 논문 Figure 1은 InternVL2-8B가 박스플롯을 코드로 옮길 때 차트 유형 오류·좌표 크기 불일치를 내는 사례를 보임.
2) 대규모·다양성 차트-코드 데이터의 부재 차트 이해 데이터는 많지만 차트→코드 전용 데이터는 규모가 작아 SFT를 지탱하기 어려움. 차트→코드 데이터는 차트 이해 데이터와 성격이 다름: (1) 일대일 대응 — 한 차트에서 여러 QA를 뽑는 이해 데이터와 달리 (차트, 코드)가 1:1이라 많은 차트 이미지가 필요, (2) 다양성이 차트 유형·구조에 있음 — 지시문이 아니라 차트 종류·구조에서 다양성이 나옴, (3) 문법 제약 — 출력 코드가 실행 가능해야 함.
정리하면 코드 LLM 백본으로 실행 가능성을 확보하고, 대규모·다양성 차트-코드 데이터로 SFT를 지탱하며, 핵심 정보를 강조하는 학습 신호를 갖춘 전용 차트→코드 MLLM이 없던 게 미해결 과제임.
2. 제안 방법: ChartCoder
코드 LLM을 언어 백본으로 쓴 첫 전용 차트→코드 MLLM에, 자체 구축한 대규모 데이터(Chart2Code-160k)와 단계별 생성 기법(SoT)을 얹은 구성임.
2.1 핵심 아이디어
차트→코드를 “코드 생성” task로 제대로 정렬한다 — 코드 LLM을 백본으로 깔아 실행 가능성을 확보하고, 코드를 먼저 생성·실행해 대규모 데이터를 만들고, 생성을 단계별로 쪼개 핵심 정보를 강조한다.
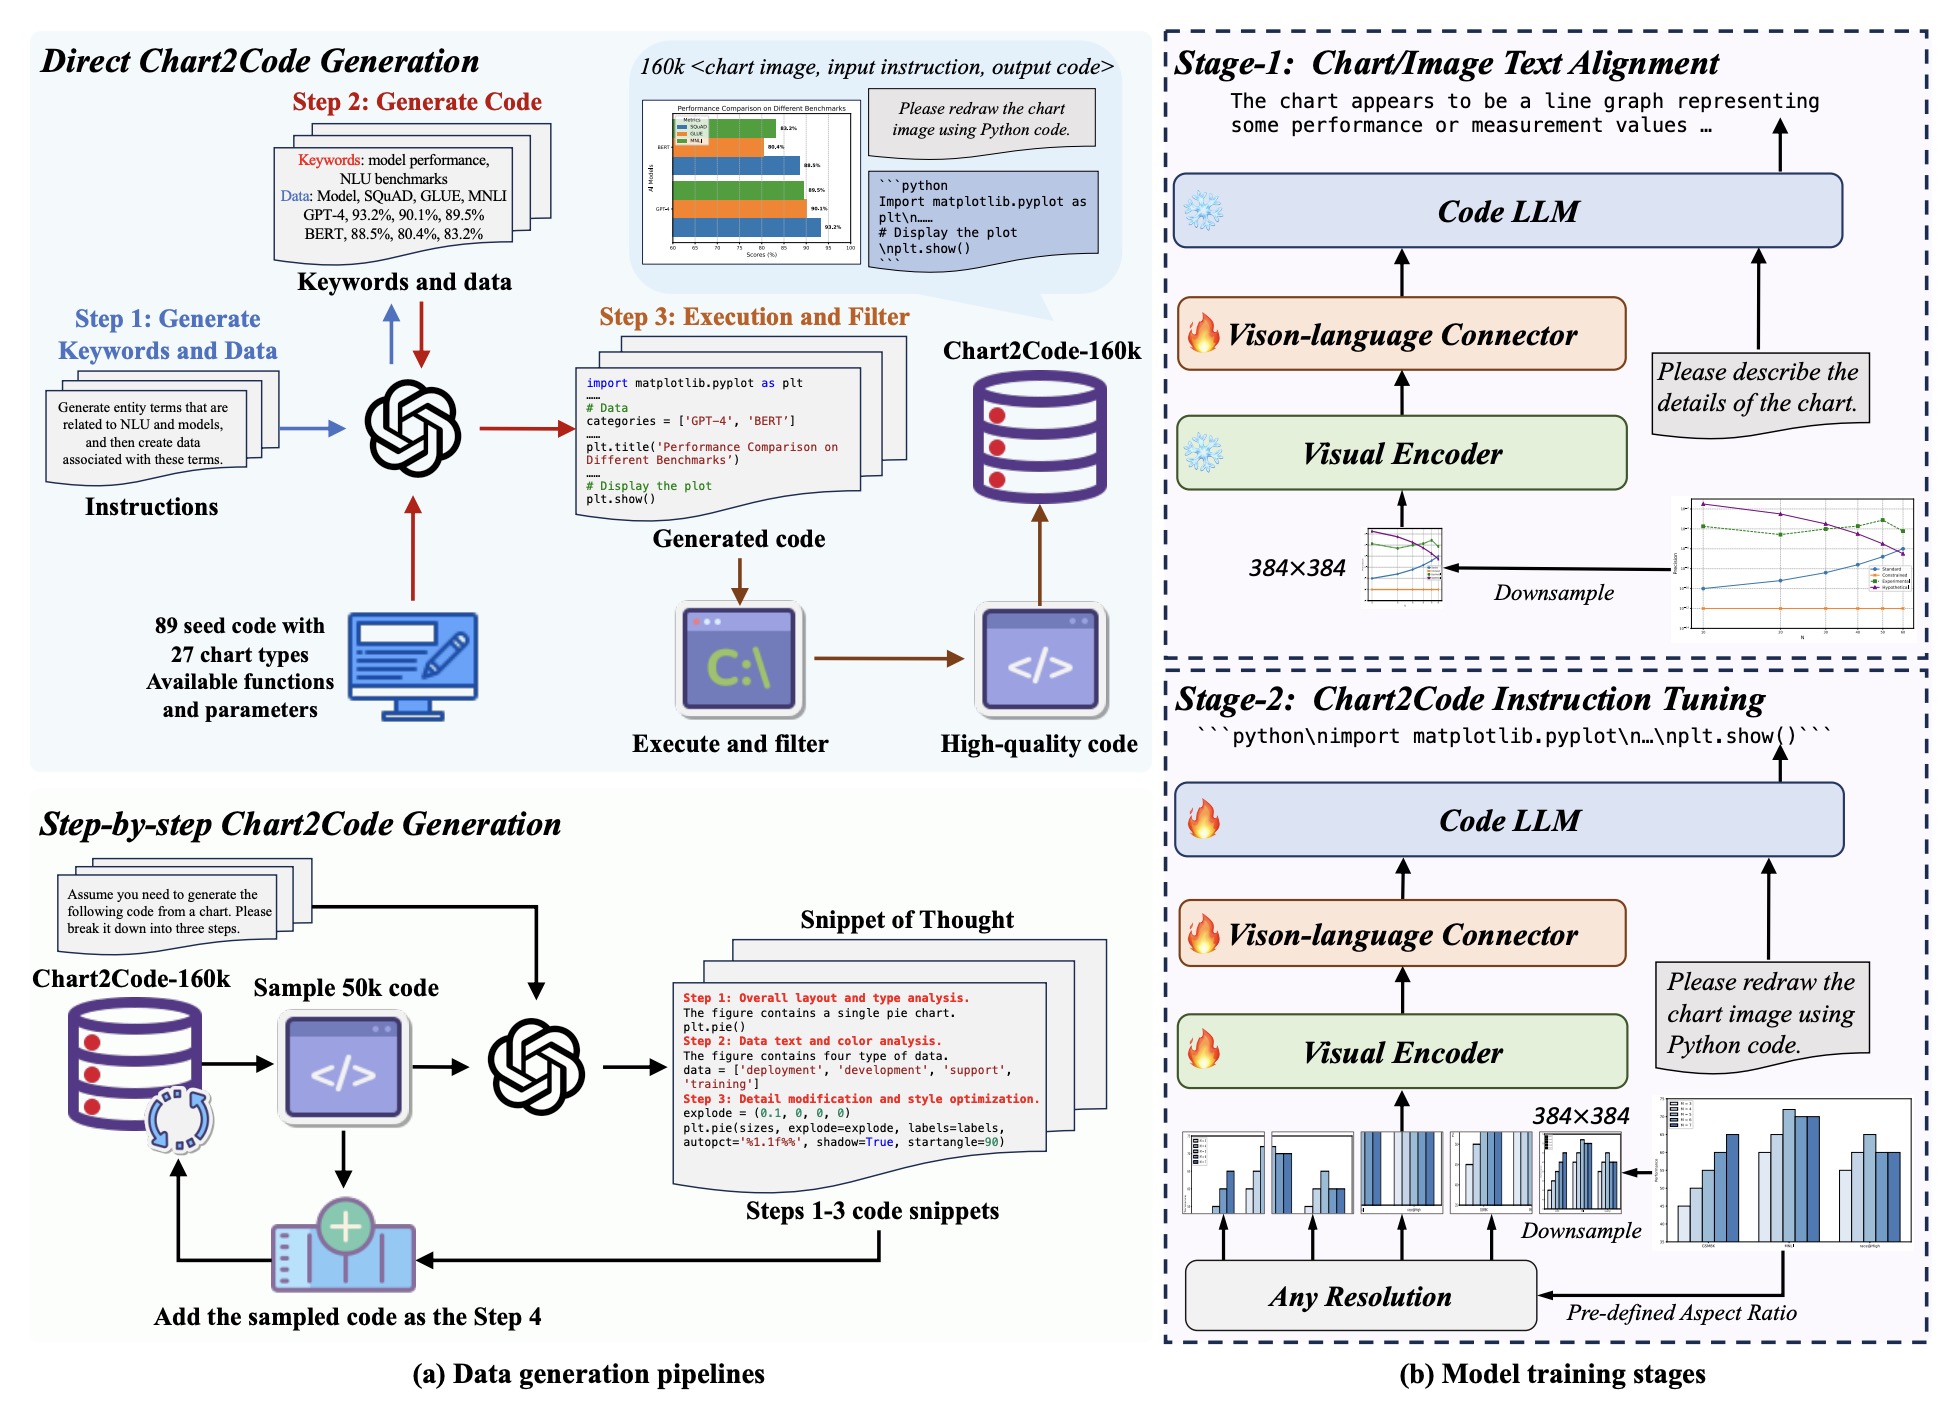
위 그림이 이 논문의 두 축임 — (a) 코드를 먼저 생성·실행해 차트를 만들고 SoT로 단계화하는 데이터 파이프라인, (b) chart-to-text 정렬 후 chart-to-code 지시학습으로 이어지는 학습 단계.
기존 MLLM이 차트를 자연 이미지로 보고 자연어를 뱉는 데 최적화됐다면, ChartCoder는 언어 백본 자체를 코드 LLM(DeepSeek Coder) 으로 바꿔 코드 문법·실행 가능성을 처음부터 챙김. 데이터는 차트→코드의 일대일 성질을 역이용해 코드를 먼저 만들고 실행해 차트를 렌더하는 식으로 대량 확보함.
2.2 아키텍처
표준 MLLM 3-모듈 구성.
| 구성요소 | 내용 |
|---|---|
| 비전 인코더 | SigLIP-384. 차트 이미지를 시각 feature로 |
| 커넥터 | 2-layer MLP. 시각 feature를 단어 임베딩 공간으로 사영 |
| 언어 백본 | DeepSeek Coder 6.7B — 일반 LLM 대신 코드 LLM을 언어 백본으로 쓴 게 핵심 차별점 |
고해상도 차트의 작은 글자·기호를 살리려 Any Resolution 전략(LLaVA-NeXT의 AnyRes)을 씀: 입력을 높이·너비가 인코더 해상도의 정수배가 되는 최적 종횡비로 리사이즈 → 표준 해상도(384²) 패치로 분할 + 전체를 다운샘플한 버전과 concat. 원본을 정사각형으로 욱여넣지 않아 세부 손실을 피하면서 전역 정보도 함께 보존함(ViT/SigLIP의 224·384 고정 해상도 제약 우회). 다만 패치 수만큼 시각 토큰이 늘어나는 비용은 감수하는 선택임.
2.3 데이터 — Chart2Code-160k
차트→코드의 일대일 성질을 이용해 코드를 먼저 생성하고 실행해 데이터를 만듦.
- 키워드·데이터 생성: LLM(gpt-4o-2024-08-06)에 특정 도메인 키워드와 관련 모의 데이터를 생성시킴.
- 코드 생성: 27개 차트 유형을 정하고 유형별 시드(seed) 코드를 수작업으로 써 in-context 예시로 주고,
plt.text()·hatch='/'같은 함수·파라미터를 명시적으로 제공해 구조 다양성을 유도. Matplotlib·Seaborn 같은 표준 라이브러리 사용을 권장하고, 모든 파라미터를 코드 안에 정의(외부 CSV 불필요)해 바로 실행 가능하게 함. - 실행·필터: 200k 코드를 실행해 문제 차트(과도한 픽셀·틱)를 걸러 160k로.
<chart, instruction, code>형식.
유형 분포(부록 Table 8)를 보면 line 9.7%·bar 8.3%·pie 8.0%가 상위이고, 3D(5.6%)·quiver(5.2%)·candlestick·funnel·treemap·violin 등 롱테일 유형과 복합(Combination) 차트 2.8%까지 포함함 — “다양성이 차트 유형에 있다”는 데이터 설계 원칙이 분포로 뒷받침됨. 단, inset·histogram·graph·density는 각 1.2%로 얇음.
| 데이터셋 | 용도 | 차트 유형 | 규모 |
|---|---|---|---|
| ChartX | Eval | 18 | 6k |
| Plot2Code | Eval | 6 | 132 |
| ChartMimic | Eval | 22 | 2.4k |
| ChartLlama | Train | 10 | 7.8k |
| Chart2Code-160k | Train | 27 | 160k |
규모·다양성에서 기존 학습셋(ChartLlama 7.8k)을 압도. 참고로 후속 MSRL의 데이터 비교표(Table 1)에선 이 데이터의 API 유형이 187개로 집계되는데, MSRL 자체 데이터(1,555개)와의 이 격차가 “합성 시드 기반 생성의 다양성 상한”을 보여주는 수치임.
2.4 Snippet-of-Thought (SoT)
생성 코드 대부분이 비슷한 템플릿이고 색·값 같은 세부만 다르다 보니, 모델이 그 결정적 세부를 놓쳐 불완전·오답 코드를 냄. SoT는 직접 생성을 단계별 생성으로 확장해 각 단계에서 핵심 정보를 강조함(160k 중 50k 샘플에 적용, 나머지 110k는 직접 생성 형식 유지).
- Step 1: 차트 유형·레이아웃(
plt.bar(),plt.subplot()) - Step 2: 데이터·색상(
data=[10,15],colors=[...]) - Step 3: 결정적 세부(
hatch='/',loc='upper left') - Step 4: 완성된 최종 코드
CoT·PoT와 달리 각 단계에 텍스트 설명 + 코드 스니펫을 함께 넣음. 다만 LLM에 단계별 코드를 곧바로 시키면 중간 스니펫과 최종 코드가 어긋나는 환각이 생겨, “생성 후 분해”의 2단계로 재구성함 — 완성 코드를 Step 1–3 설명·스니펫으로 분해하고 Step 4에 완성본을 붙임. 분해 시 placeholder·기본 파라미터를 써 정의 안 된 값으로 인한 환각을 줄임. 텍스트-투-코드 쪽에서 검증된 “outline-then-details”식 조립(coarse-to-fine)을 멀티모달로 가져온 셈임.
2.5 2단계 학습
- Stage-1 (chart-to-text 정렬): 언어·비전 인코더는 얼리고 커넥터만 학습(LR 1e-3). 차트 캡션·chart-to-table 등 공개 코퍼스(UniChart, Chart-to-Text, SciCap, SciCap+) + LLaVA 사전학습 데이터 + Chart2Code-160k로 차트 구조 인지 능력 부여.
- Stage-2 (chart-to-code 지시학습): 세 모듈 전체를 공동 미세조정 — 1 epoch, batch 128, LR은 SigLIP 5e-6·나머지 1e-5, warmup 3% 후 0으로 감쇠. Chart2Code-160k + 코드 관련 데이터(ChartQA PoT, ChartLlama chart-to-chart).
전체 비용은 A100 80GB 32장 기준 정렬 12시간 + 지시학습 5시간. 7B 전용 모델치고 가벼운 편이라, “데이터가 준비되면 학습 자체는 싸다”는 게 이 노선의 실용적 장점임 — 뒤집어 말하면 비용의 본체는 GPT-4o API로 200k 코드를 뽑는 데이터 생성 단계에 있음.
3. 실험 결과
베이스 7B(SigLIP-384 + DeepSeek Coder 6.7B). 평가는 셋 다 특정 서브셋·task에서 zero-shot으로 수행됨: ChartMimic은 testmini의 Direct Mimic(스타일 보존 재현), Plot2Code는 Direct Asking(Pass Rate·Text-Match·Rating), ChartX는 Redrawing(GPT-score).
주의할 평가 프로토콜 변경이 하나 있음: Plot2Code의 Rating 산식을 저자들이 고침. 원래 Rating은 실행에 성공한 코드의 차트만 채점해, 단순한 차트만 만들어 실행률을 챙기는 모델이 유리해지는 왜곡이 있었음. 저자들은 전체(실행 실패 포함)에 대해 재계산함. 방향은 옳지만, 이 표의 Rating은 원 벤치마크 논문이나 타 논문의 Rating과 직접 비교하면 안 되는 수치가 됨.
3.1 메인 결과 (Table 2 발췌)
| 모델 | Params | ChartMimic (Exec/Low/High) | Plot2Code (Pass/Text/Rating) | ChartX (GPT) |
|---|---|---|---|---|
| GPT-4o (proprietary) | – | 93.2 / 79.0 / 83.5 | 88.6 / 56.3 / 5.71 | – |
| GPT-4V (proprietary) | – | 91.2 / 76.4 / 78.9 | 84.1 / 57.7 / 5.58 | 2.63 |
| Claude-3-opus (proprietary) | – | 83.3 / 60.5 / 60.1 | 84.1 / 57.5 / 3.80 | – |
| InternVL2-Llama3-76B | 76B | 83.2 / 54.8 / 62.2 | 85.6 / 46.6 / 3.89 | 1.74 |
| TinyChart (chart-domain) | 3B | 42.5 / 26.3 / 25.9 | 43.2 / 44.6 / 2.19 | 1.89 |
| ChartCoder (Ours) | 7B | 91.4 / 77.4 / 74.0 | 87.9 / 54.5 / 4.50 | 2.09 |
오픈소스 전부를 능가하고 proprietary 중에서도 GeminiProVision·Claude-3-opus는 전 지표에서 앞서며, GPT-4V와는 ChartMimic Exec/Low에서 대등 이상(91.4/77.4 vs 91.2/76.4), High-level에서만 밀림. 7B로 76B급·chart-domain 모델을 모두 상회. 가장 어려운 ChartMimic에서 소규모 general-domain 대비 평균 +26.7(MiniCPM)·+34.6(InternVL2-8B).
수치 재현성 각주: 후속 MSRL이 같은 ChartMimic Direct Mimic에서 ChartCoder를 재평가한 Low-level은 72.5로, 본 논문 자기보고(77.4)와 5점 가까이 차이남(GPT-4o는 두 논문에서 동일 수치). Low-level은 규칙 기반 코드 비교라 심판 모델 탓으로 돌리기도 어려움 — 평가 하네스·프롬프트·파싱 차이로 이 정도가 흔들린다는 뜻이고, 이 분야 리더보드 수치를 논문 간 비교할 때 오차 범위를 넉넉히 잡아야 하는 이유임.
- High-level 세부(Table 3): 유형·레이아웃·텍스트·데이터·스타일·명료성 6항목 모두 GPT-4o에 근접. 가장 큰 격차는 데이터 항목(15.68 vs 12.41/20) — 복잡 차트에서 정확한 수치 추출이 어렵다는 기존 차트 이해 연구의 결론과 일치. 단, high-level 채점자가 GPT-4o 자신이라 실제 격차는 보이는 것보다 작을 수 있음(저자 언급).
- Low-level 세부(Table 4): 코드 유사도 4항목 중 레이아웃(95.0 vs 89.8)·유형(78.5 vs 77.3)·색(69.0 vs 67.2)에서 GPT-4o를 앞섬. 텍스트(67.2 vs 81.5)는 뒤짐 — 차트 OCR 특화 학습 부재 탓.
- 오류 유형 분석(Fig. 3): 실행 실패 코드를 유형별로 쪼개 보면, 코드 LLM 백본이 닫는 따옴표 누락 같은 구문 오류와 잘못된 인자 타입 같은 타입 오류를 크게 줄임 — “코드 LLM이 왜 실행률을 올리는가”에 대한 메커니즘 수준 근거임.
3.2 Ablation (Table 5·7)
| 변경 | ChartMimic (Exec/Low/High) | Δ |
|---|---|---|
| ChartCoder | 91.4 / 77.4 / 74.0 | – |
| 코드 LLM → 일반 LLM (DeepSeek LLM) | 80.6 / 61.4 / 63.4 | -10.8 / -16.0 / -10.6 |
| SigLIP-384 → CLIP-336 | 91.6 / 77.3 / 70.3 | +0.2 / -0.1 / -3.7 |
| SoT 제거 | 89.2 / 70.1 / 65.4 | -2.2 / -7.3 / -8.6 |
| Qwen2-VL-7B → Chart2Code-160k 미세조정 | 67.0/32.9/35.0 → 83.6/73.4/68.2 | +16.7 / +40.5 / +33.2 |
읽는 법: ① 코드 LLM 백본이 가장 큰 기여 — 일반 LLM으로 바꾸면 실행률·품질이 크게 떨어짐(위 오류 유형 분석과 짝을 이룸). ② 해상도는 실행률엔 거의 무영향, high-level 유사도에만 약간 영향 — 저자 분석으론 저해상도의 피해가 텍스트·특수기호 인식에 집중되는데, Any Resolution이 이를 완화. ③ SoT는 특히 텍스트·데이터에서 효과 — 50k(전체의 31%)로 얻은 이득임. 다만 SoT 비율을 바꿔가며(예: 0/25/50/100%) 최적점을 찾는 실험은 없어, 50k가 왜 그 규모인지는 근거 없음. ④ Chart2Code-160k만으로도 기존 오픈소스 MLLM을 크게 끌어올림 → 데이터 자체의 유효성.
- 코드가 이해를 돕는가(Table 6): 생성 코드를 보조 문맥으로 주면 MMC True/False에서 MiniCPM-Llama3-V2.5가 0.76→0.81(+6.5%) — 차트 유형·데이터 이해에 기여. 코드가 “이해를 위한 중간 표현”으로도 기능한다는 방증임.
- 백본 추가 비교(부록 Table 7): DeepSeek Coder(91.4/77.4/74.0) > Qwen2.5 Coder(90.3/76.8/69.7) > Qwen2.5 일반(88.1/73.4/67.9). 공식 코딩 평가상 우세한 Qwen2.5 Coder가 오히려 뒤지는데,
ax[0], ax[1]을 직접 쓰는 DeepSeek와 달리for i in range(2): ax[i]처럼 표준화된 루프를 선호해, 서브플롯마다 막대 수가 다른 복잡 차트에서 오류를 냄 — “코드 품질”과 “시각 복원 적합성”이 다른 축임을 보여주는 대목임.
4. 한계 및 비판
1) 모델이 데이터를 만들고 평가까지 하는 순환 데이터는 GPT-4o가 생성(gpt-4o-2024-08-06), High-level 점수도 GPT-4o가 판정. 저자도 “채점자가 GPT-4o라 격차가 과장됐을 수 있다”고 인정함 — 뒤집으면 ChartCoder의 high-level 점수도 GPT-4o가 만든 데이터 분포에 맞춰져 후하게 나왔을 가능성이 있음. 생성·평가가 한 모델에 묶인 구조로, MOCR·PaddleOCR-VL·MSRL 리뷰에서 짚은 자기 생태계 순환 우려와 같은 계열임.
2) “무손실”은 절반만 참 — 과제 정의 자체의 비유일성 “코드는 무손실 표현”이 핵심 논거인데, 이 명제는 코드에서 렌더된 차트에서만 성립함. 실세계 비트맵 차트(엑셀 캡처, 보도자료 이미지)에는 GT 코드가 존재하지 않고, 같은 그림을 그리는 코드는 무한히 많음 — 즉 실차트에 대한 chart-to-code는 “복원”이 아니라 본질적으로 비유일해(ill-posed) 그럴듯한 재구성임. 게다가 high-level에서 가장 큰 격차가 데이터 항목이고, 학습 데이터의 수치가 전부 LLM이 지어낸 모의 데이터라, 무손실 주장의 핵심인 “정확한 수치 복원”이 가장 약하다는 게 정확히 어긋나는 지점임.
3) render-and-compare 평가 = 시각 유사도 High-level이 렌더 이미지의 GPT-4o 유사도 채점이라, 데이터가 틀려도 그림이 비슷하면 후하게 나올 수 있음. MOCR의 ISVGEN에서 지적한 한계, MSRL의 시각 보상이 안은 한계와 동형임. 여기에 3장에서 짚은 Rating 산식 개정, MSRL 재평가와의 Low-level 5점 차이까지 겹치면, 이 분야는 지표 자체의 신뢰 구간이 모델 간 격차보다 클 수 있는 상태임.
4) SFT+데이터의 완성형이자 그 천장 ChartCoder는 데이터를 160k로 키우고 SoT를 더했지만 어디까지나 SFT임. 후속인 MSRL이 바로 이 SFT+데이터 스케일링이 2M 부근에서 정체됨을 실증하고 RL로 넘음. 합성 데이터의 한계도 후속에서 정량으로 확인됨 — MSRL의 데이터 비교 ablation에서 실제 arXiv 표 기반 데이터로 SFT한 결과(73.0/77.6)가 ChartCoder 데이터로 SFT한 결과(68.5/68.0)를 뚜렷이 앞섬. 즉 “GPT-4o 합성 + SFT” 노선은 규모(160k→3M)와 출처(합성→실데이터)와 학습 신호(SFT→RL) 세 축 모두에서 후속에 추월당하는 출발점임.
5) 텍스트·OCR 약점 (저자 인정) low-level·high-level 모두 텍스트가 최약점(low-level 67.2 vs GPT-4o 81.5). 코드 접근이 미세 글자 읽기를 대신 해주지 않으며, 해상도 의존 문제와 맞물림 — Any Resolution으로 완화될 뿐 해소되진 않고, 차트 OCR 특화 학습이 별도로 필요.
6) 합성·matplotlib 편중 전 데이터가 LLM 생성 matplotlib/Seaborn 코드, 27개 유형에 한정. 실세계 차트의 분포·비정형성(비표준 라이브러리, 디자인 툴 산출물, 스캔 품질)은 담지 못함. 저자도 future work로 더 복잡·다양한 차트와 HTML 등 다른 이미지 유형을 남김.
7) SoT는 “정답에서 역분해한 추론” — 추론 시 사용 여부도 불명 단계별 생성을 곧바로 시키면 환각이 나서 완성 코드를 사후 분해하는 방식으로 우회함. 즉 SoT의 “단계”는 실제 추론 과정이 아니라 정답을 쪼갠 것에 가까움. 더 나아가 추론 시점에 모델이 단계별로 생성하는지, 직접 생성하는지 원문에 명시가 없음 — 검증된 것은 “SoT 형식의 학습 데이터가 성능을 올린다”까지이고, “추론 능력 강화”라는 표현은 그보다 강한 주장임.
5. 결론
1) 핵심 기여 — 첫 전용 차트→코드 MLLM + 대규모 데이터 + 단계별 생성 코드 LLM을 언어 백본으로 깔아 실행 가능성을 확보하고, Chart2Code-160k(160k·27유형)로 데이터 공백을 메우고, SoT로 핵심 정보를 강조함. 7B로 오픈소스 전부를 능가하고 low-level 3개 항목에서 GPT-4o를 앞섬.
2) 설계 핵심 — 코드 LLM 백본·Any Resolution·SoT ablation이 보여주듯 실행률·품질을 살리는 결정적 요인은 코드 LLM 백본이고(구문·타입 오류 감소라는 메커니즘까지 확인), Any Resolution이 텍스트·기호 세부를, SoT가 데이터·텍스트를 보강함. 세 축이 각각 실행 가능성·해상도·핵심 정보라는 다른 병목을 겨눔.
3) 계보에서의 위치 — 이미지→코드의 SFT 완성형, MSRL의 직계 선행 MOCR(그래픽→SVG)·MSRL(차트→코드 RL)과 같은 이미지→코드 계보에 속하며, 특히 MSRL의 직계 선행임(1저자 공통). ChartCoder가 SFT+데이터로 차트→코드를 끌어올린 정점을, MSRL이 “그 스케일링의 천장”으로 재규정하고 RL로 넘는 흐름이 한 줄로 이어짐 — 데이터 출처(합성→실표)·규모(160k→3M)·학습 신호(NLL→다입자 보상)가 정확히 ChartCoder의 세 약점을 겨눈 업그레이드임. render-and-compare 평가·자기 생태계 순환의 그림자는 MOCR·MSRL과 공유함. 차트→코드를 “코드 생성 task로 제대로 정렬한 첫 칸“으로 읽으면 이후 RL·SVG로의 확장이 자연스럽게 꿰임.
배경 개념 정리
Chart-to-code 차트 이미지를 입력받아 그 차트를 그리는 실행 가능한 코드(주로 matplotlib)를 생성하는 task. 자연어 설명(chart-to-text)이 조밀한 정보를 잃는 반면, 코드는 데이터·구조·스타일을 무손실로 담음 — 단, 이 무손실성은 코드에서 렌더된 차트에 한정되고, 실세계 비트맵 차트에는 유일한 정답 코드가 없음. 출력이 길고 강하게 구조화돼 시각 이해+구조 추론+코드 문법이 겹침.
코드 LLM 백본 (Code LLM as language backbone) MLLM의 언어 모델을 일반 LLM 대신 코드로 사전학습된 LLM(DeepSeek Coder)으로 쓰는 것. 코드 문법·실행 가능성을 처음부터 챙겨 구문 오류·타입 오류를 크게 줄임. ablation에서 가장 큰 성능 기여 요인. 단, 코딩 벤치마크 점수 순위(Qwen2.5 Coder > DeepSeek Coder)가 차트→코드 순위와 일치하지 않음 — 코드 스타일(직접 인덱싱 vs 루프 표준화)이 시각 복원 적합성에 별도로 작용함.
Any Resolution 전략 (AnyRes) 고정 해상도(SigLIP 384) 제약을 우회해 고해상도 차트를 처리하는 방식(LLaVA-NeXT 계열). 입력을 인코더 해상도의 정수배가 되는 최적 종횡비로 리사이즈해 표준 해상도 패치로 나누고, 전체를 다운샘플한 버전과 concat해 전역·세부 정보를 함께 보존함. 작은 글자·기호 인식에 유리하나 시각 토큰 수는 패치 수만큼 증가함.
Snippet-of-Thought (SoT) 직접 생성을 4단계(유형·레이아웃 → 데이터·색 → 세부 → 완성 코드)로 확장해 핵심 정보를 강조하는 기법. 각 단계에 텍스트 설명과 코드 스니펫을 함께 둠. 환각을 막기 위해 “생성 후 분해”로 만들어, 완성 코드를 역으로 단계 스니펫으로 쪼갬. 텍스트-투-코드의 coarse-to-fine 생성 계보를 멀티모달로 이식한 형태.
Chart2Code-160k 차트→코드 전용 대규모 데이터셋. 코드를 먼저 생성·실행해 차트를 렌더하는 방식으로 160k <chart, instruction, code> 쌍(27유형)을 구축. 모든 파라미터를 코드 안에 정의해 외부 파일 없이 실행 가능. 기존 학습셋(ChartLlama 7.8k) 대비 규모·다양성에서 압도하나, 수치는 전부 LLM 생성 모의 데이터임.
High-level vs Low-level score (ChartMimic) 차트→코드 평가의 두 축. High-level은 GPT-4o가 원본과 생성 차트 이미지를 6항목(유형·레이아웃·텍스트·데이터·스타일·명료성)으로 채점, Low-level은 정답 코드와 생성 코드를 규칙 기반 4항목(텍스트·레이아웃·유형·색)으로 비교. render-and-compare 계열이라 시각 유사도에 후해질 수 있음.
Direct Mimic vs Customized Mimic (ChartMimic) Direct Mimic은 차트 이미지만 주고 그대로 재현하는 코드를 요구하고, Customized Mimic은 이미지에 수정 지시문(색 바꿔라, 데이터 바꿔라 등)을 더해 지시 반영까지 요구함. ChartCoder를 포함해 이 계보 논문 대부분의 헤드라인 수치는 testmini의 Direct Mimic 기준임 — 벤치마크 이름만 보고 어느 task인지 확인 없이 논문 간 수치를 비교하면 안 되는 이유.
Plot2Code 지표 3종 (Pass Rate / Text-Match / Rating) Pass Rate는 생성 코드의 실행 성공률, Text-Match는 렌더된 차트의 텍스트 요소(제목·라벨 등) 일치도, Rating은 GPT-4V(원 논문)의 1–10 유사도 채점. ChartCoder 논문은 Rating을 전체 샘플 기준으로 재계산해 원 산식과 다름 — 실행 성공분만 채점하는 원 방식은 단순 차트만 만드는 모델에 유리한 왜곡이 있기 때문.