B3
Breaking the Batch Barrier (B3) of Contrastive Learning via Smart Batch Mining
Authors: Raghuveer Thirukovalluru, Rui Meng, Ye Liu, Karthikeyan K, Mingyi Su, Ping Nie, Semih Yavuz, Yingbo Zhou, Wenhu Chen, Bhuwan Dhingra (Duke University, Salesforce AI Research, University of Waterloo 등) — arXiv 2505.11293, NeurIPS 2025.
대조학습(contrastive learning)으로 멀티모달 임베딩 모델을 학습할 때 배치를 어떻게 짜느냐를 다루는 학습 레시피 논문임. 핵심은 무작위로 짠 배치에서 가장 어려운 negative를 골라 끼우는 게 아니라, 배치 자체를 서로가 서로의 강한 negative가 되도록 구성하는 것. 별도 hard negative를 추가하지 않고도 강한 학습 신호를 얻어 연산 비용을 크게 줄이고, MMEB(멀티모달 임베딩 벤치마크)에서 SOTA를 달성함. 임베딩·검색 모델의 학습 효율을 끌어올리는 방법론으로 읽으면 됨.
1. 문제 정의
핵심 문제
대조학습에서 고품질 학습 배치를 어떻게 구성할 것인가가 핵심 문제임.
대조학습(CL)은 (질의, 정답) 쌍을 가까이 당기고 negative를 멀리 미는 식으로 임베딩을 학습함. negative의 주요 공급원이 in-batch negative — 같은 배치 안 다른 예시의 positive — 라서, 모델 성능이 배치의 크기와 질에 강하게 좌우됨. 즉 “어떤 예시들을 한 배치에 모으느냐”가 학습 신호의 품질을 직접 결정함.
기존 연구의 한계
1) Hard negative mining 방식 (NV-Embed, SFR-Embedding 등) teacher 모델로 질의별 negative를 랭킹해 상위 몇 개(예: 10개)를 hard negative로 끼워넣음. 효과는 좋지만 비쌈 — hard negative 10개는 1개 대비 학습 시간이 약 4배임. 텍스트 전용이면 감당되지만 멀티모달에서는 사실상 불가능함: positive에 고해상도 이미지가 끼어 negative 하나 추가할 때마다 연산 부담이 증폭되고, 가뜩이나 큰 멀티모달 데이터를 다 쓰기도 어려운데 부담이 더 커짐.
2) Hard negative mining을 회피한 멀티모달 방식 그래서 최근 멀티모달 임베딩은 전체 데이터셋 차원의 hard negative mining을 대체로 피함. VLM2Vec은 다양한 task 데이터를 contrastive용으로 재활용하되 hard negative 샘플링은 생략하고, MegaPairs·mmE5는 합성 쌍 생성에 집중하며, LLaVE·UniLM은 현재 배치 안에서만 negative를 재샘플링함. 공통 한계: 배치 바깥에 있는 더 강한 negative 신호를 못 씀.
3) 기존 배치 마이닝 방식 NGAME(클러스터 병합), GCBS(인접 그래프 bandwidth 최소화), BatchSampler(랜덤 워크) 등이 배치 구성을 최적화하려 했지만, false negative의 영향이나 과도한 hard negative의 역효과를 대규모 데이터에서 제대로 고려하지 못함. Morris & Rush의 클러스터링 배치는 텍스트 전용·소규모에 그침.
정리하면 전체 데이터셋에서 강한 in-batch negative를 체계적으로 모아 배치를 짜되, false negative와 과잉 난도를 동시에 통제하는 틀이 없었던 게 미해결 과제임.
2. 제안 방법: B3
teacher 랭킹 + 그래프 community detection으로 서로가 서로의 강한 negative가 되는 예시들을 묶어 배치를 구성하는 오프라인 배치 마이닝 전략임. 별도 hard negative를 끼우지 않고도 강한 학습 신호를 얻어 연산 비용을 크게 줄임.
2.1 핵심 아이디어
개별 hard negative를 골라 IID 배치에 끼워넣지 말고, 데이터셋 전체에서 상호 강한 negative들을 클러스터로 묶어 배치 자체를 만든다.
기존 방식은 “랜덤 배치 + 따로 캔 hard negative”의 조합이라, 추가 negative마다 비용이 붙음. B3는 발상을 뒤집어, 한 배치에 들어가는 예시들이 태생적으로 서로의 강한 negative이도록 배치를 설계함. 그러면 추가 negative가 필요 없어 비용이 사라짐.
기존 in-batch negative의 질은 “그 배치에 마침 누가 같이 들어왔느냐”라는 우연에 달려 있음. B3는 그 우연을 설계로 바꿈 — 배치 안 모든 예시가 강한 negative가 되도록 미리 묶어두면, 검색기가 매 스텝 더 어려운 대조 신호를 받게 됨. 즉 B3는 VLM 기반 대조 임베딩 모델 위에 그대로 얹히는 학습 모듈이라, 저자들도 “data synthesis·architecture 혁신과 직교·상보적”이라고 못박음.
2.2 배치 마이닝 알고리즘 (§3.1.1)
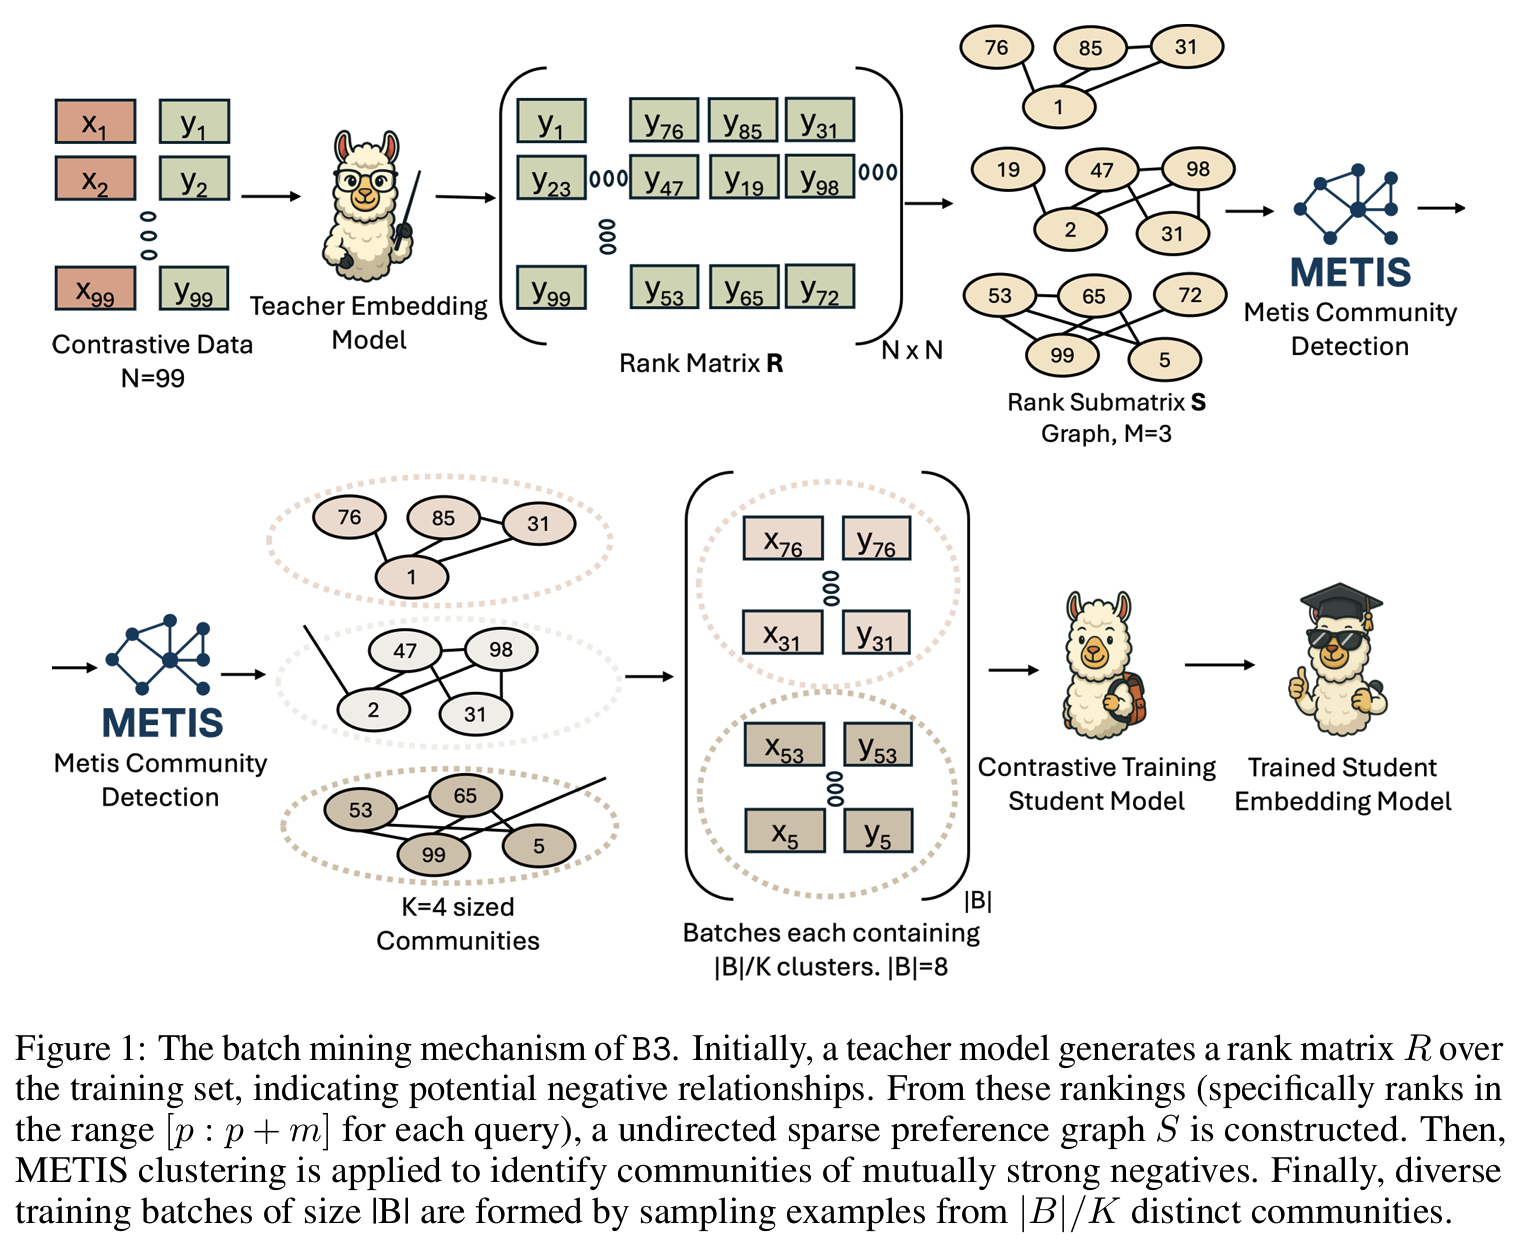
위 그림이 전체 파이프라인을 한눈에 보여줌. teacher 모델이 학습셋에서 랭크 행렬 R을 만들고, false negative를 거른 부분행렬 S로 희소 무향 그래프를 구성한 뒤, METIS로 서로 강한 negative끼리 묶인 커뮤니티(크기 K)를 뽑아, 이를 |B|/K개씩 조립해 한 배치를 만듦.
| 단계 | 내용 |
|---|---|
| ① 랭킹 | teacher 임베딩 모델로 질의 x_i에 대해 전체 positive를 랭킹 → rank matrix R ∈ ℕ^{N×N}. 각 행이 {1..N}의 순열(유사도 내림차순) |
| ② false negative 거르기 | 최상위 랭크는 golden과 의미상 동일/근접한 false negative라 negative로 못 씀. NV-Retriever식 임계로 상위 p개를 버리고 다음 m개만 사용 → S = R[:, p : p+m] |
| ③ 무향 그래프화 | S는 희소 유향 그래프. 양방향 엣지만 남겨 무향 그래프로 만듦. 엣지 = “같은 배치에 넣을 선호”(=강한 in-batch negative) |
| ④ 클러스터링 | METIS min-cut 알고리즘으로 크기 K의 community 추출 — 커뮤니티 내 엣지 최대화, 커뮤니티 간 엣지 최소화. m이 작아 빠르고 대략 O(n) |
| ⑤ 배치 구성 | 크기 K 클러스터를 |B|/K개 모아 배치 하나 구성. CL은 큰 배치가 필요하므로 이 조립으로 큰 배치를 만듦 |
핵심 차별점: 개별 negative를 더하는 대신 상호 선호 negative 집단을 한 배치에 함께 두는(co-locate) 것. p로 false negative를 자르고 m으로 “적당히 어려운” 난도 구간만 취함.
2.3 이론적 정당화 (§3.1.2)
배치 손실로 전역(global) InfoNCE 손실을 근사하는 게 목표임(Eq. 1~3).
- 정리 1: 전역-배치 손실 차이는 Σ log( (N/K) · H^K_i / H^K_{Bi,i} )로 상한이 잡힘. 여기서 H^K는 분모의 상위 K개 지수항 합. ⇒ (1) H^K_{Bi,i}가 클수록, (2) K가 클수록 상한이 더 타이트해짐.
- 정리 2 (인용): 다운스트림 손실 상한에서 intra-class covariance와 계수 β가 강한 negative 수(=K)가 많을수록 커짐 ⇒ 너무 큰 K는 오히려 해로움. SFR-Embedding의 경험적 결과(hard negative 과다 시 성능 하락)와도 일치.
- 두 정리가 K에 대해 상반된 방향을 가리키므로, K는 경험적으로 고르는 게 맞음(배치 크기 |B|로 상한이 묶임).
- B3 알고리즘은 각 클러스터를 크기 K로 잡고 클러스터 내 엣지를 최대화 → 곧 H^K_{Bi,i} 최대화(Eq. 6)라, 위 상한을 직접 최적화함.
2.4 두 가지 보강과 변형
① Unified Hard-Negative Mining (§3.2, 선택적) 집단 최적화 탓에 일부 예시는 선호 negative와 같은 배치에 못 들어갈 수 있음. 이때 추가 hard negative가 도움이 됨. 단, 추가 negative는 배치 내 모든 질의와 대조되므로, 질의별 S[i,:]를 쓰는 대신 배치 전체의 선호를 합산한 분포 Pr(j) ∝ Count(S_B, j)에서 h개를 뽑음 — “배치 안 누군가에게 강한 negative”를 우선 샘플링하는 통합 전략.
② Improved Representation Prompts (§3.3) 기존엔 질의에만 instruction을 붙이고 positive는 그대로 인코딩해 불일치가 생김. “aeroplane”(ImageNet 분류)과 “Skateboarder performing a stunt in mid air”(MSCOCO 캡션)는 표현 방식이 근본적으로 달라야 함. positive에도 instruction 프롬프트를 붙여 task별 스타일을 분리(decouple)함.
③ B3 vs B3++ B3 = §3.1(배치 마이닝) + §3.3(프롬프트). B3++ = B3 + §3.2(hard negative). B3++가 더 강하지만, B3는 추가 negative 없이도 강력해 자원 제약 환경에 적합함.
3. 실험 결과
MMEB 학습셋으로 2,000 스텝(~2 epoch), 기본 |B|=1024. backbone은 Qwen2-VL-7B, InternVL3-8B(각 7B·2B 변형). m=100, p=30(검색·grounding)/70(VQA), classification은 golden 라벨만 제거. B3++는 h=5. 전부 LoRA(rank 8), lr 1e-4, temperature 0.02. teacher는 같은 스케일·같은 데이터·hard negative 없는 VLM2Vec(배치 마이닝의 기여만 분리하려는 통제).
3.1 메인 결과 (MMEB 36 task, Avg accuracy)
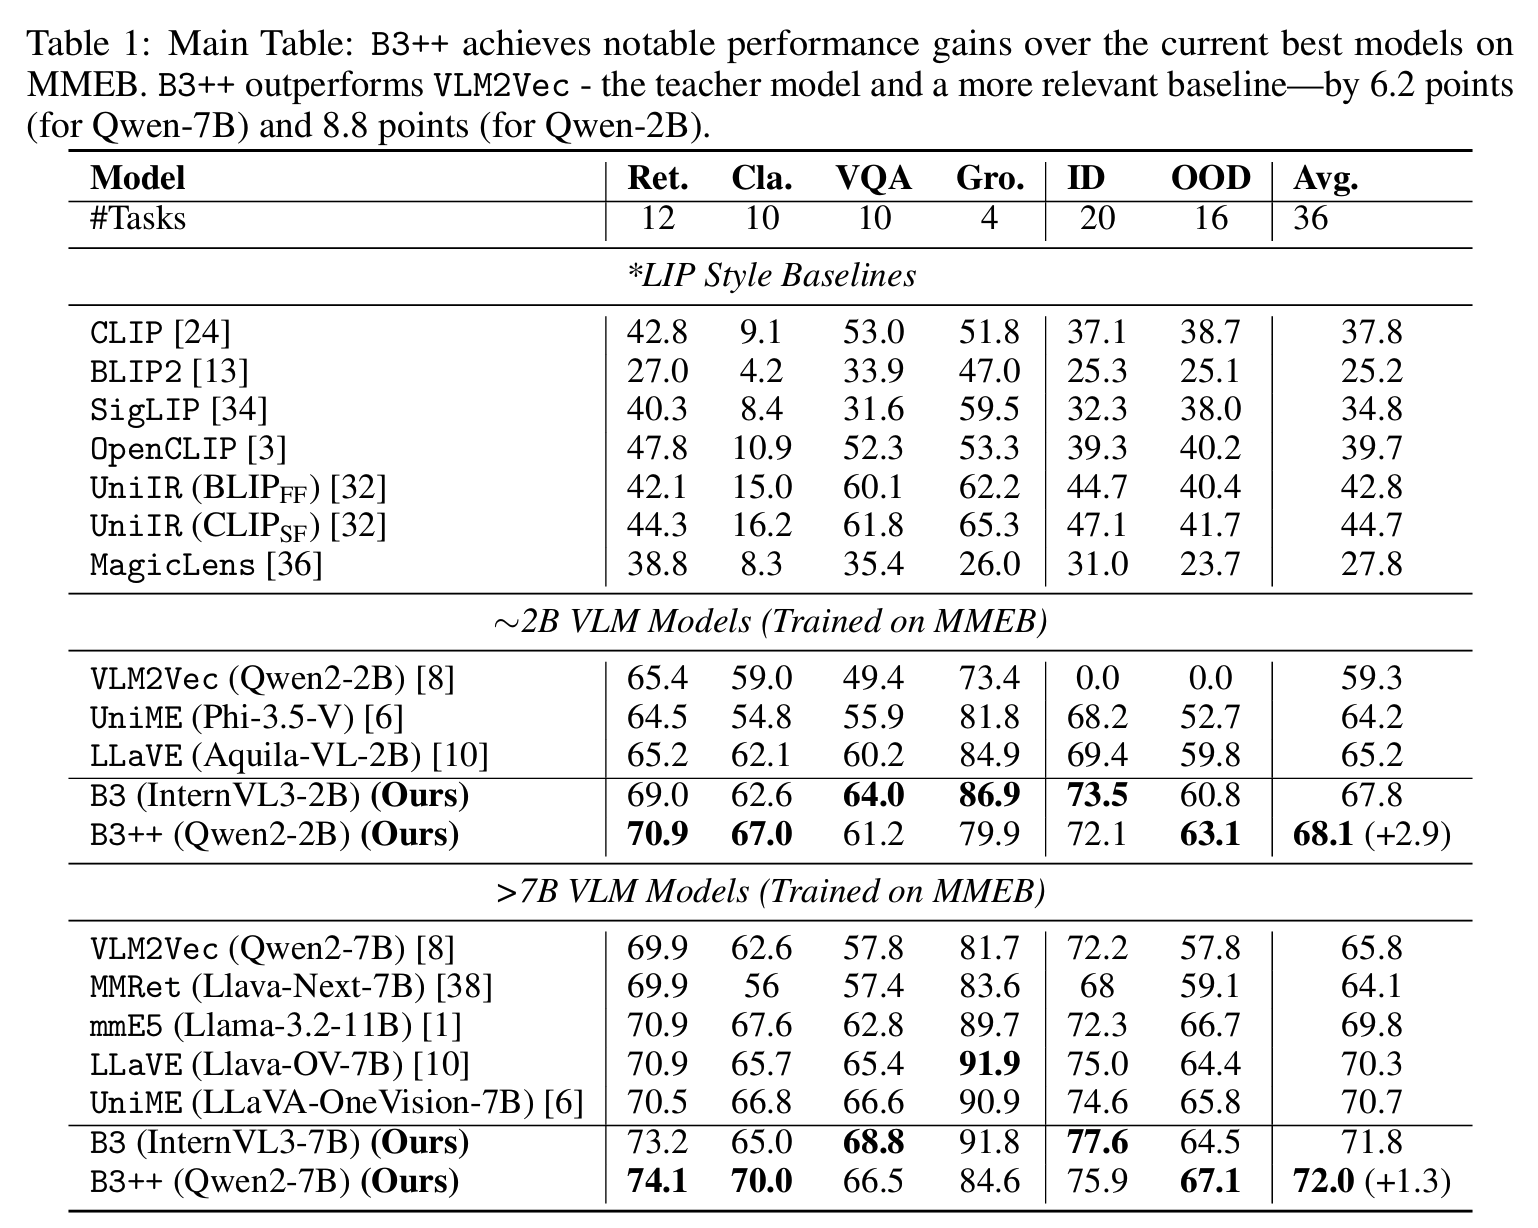
| 모델 | Ret. | Cla. | VQA | Gro. | Avg. |
|---|---|---|---|---|---|
| ~2B | |||||
| VLM2Vec (Qwen2-2B, teacher) | 65.4 | 59.0 | 49.4 | 73.4 | 59.3 |
| LLaVE (Aquila-VL-2B) | 65.2 | 62.1 | 60.2 | 84.9 | 65.2 (종전 2B SOTA) |
| B3 (InternVL3-2B) | 69.0 | 62.6 | 64.0 | 86.9 | 67.8 |
| B3++ (Qwen2-2B) | 70.9 | 67.0 | 61.2 | 79.9 | 68.1 (+2.9) |
| >7B | |||||
| VLM2Vec (Qwen2-7B, teacher) | 69.9 | 62.6 | 57.8 | 81.7 | 65.8 |
| UniME (LLaVA-OneVision-7B) | 70.5 | 66.8 | 66.6 | 90.9 | 70.7 (종전 SOTA) |
| B3 (InternVL3-7B) | 73.2 | 65.0 | 68.8 | 91.8 | 71.8 |
| B3++ (Qwen2-7B) | 74.1 | 70.0 | 66.5 | 84.6 | 72.0 (+1.3) |
MMEB는 36 task(검색 12·분류 10·VQA 10·grounding 4, ID 20·OOD 16). 차순위 모델 대비 2B에서 +2.9, 7B에서 +1.3로 SOTA. 더 공정한 기준인 teacher(VLM2Vec) 대비로는 +8.8(2B)·+6.2(7B) — 배치 마이닝만 바꿔 얻은 순증분임. 특히 검색(retrieval)에서 강함(임베딩 모델의 핵심 용처).
3.2 배치 크기 효과 (Fig. 2)
B3 vs Random Batches를 배치 32부터 비교. 작은 배치에서 격차가 가장 큼(+14점 이상) 이고, 1024에서도 +2.5점 이상 유지. 결정적으로 |B|=64만으로도 종전 2B SOTA(LLaVE)를 넘음 — 다른 방법이 요구하는 배치의 4~16배 작은 규모임. 적은 하드웨어로도 학습이 되고, 큰 모델로의 확장이 쉬워짐.
3.3 구성요소 분해 (Table 2, Qwen2-2B, |B|=1024)
| 구성 | Avg. |
|---|---|
| B3++ | 68.10 |
| B3 | 67.87 |
| Random + 5 hn (from S) | 67.14 |
| Random Batches | 65.35 |
| Random (프롬프트 없음) | 62.61 |
positive 프롬프트(§3.3)가 +2.7, B3 배치 마이닝이 +2.5로 두 기여가 가장 큼. 특히 B3(추가 negative 0개)가 Random+5hn을 +0.7로 앞서면서 학습 연산은 절반이라는 점이 두드러짐 — 효과와 효율을 동시에 가져감.
3.4 캡션 검색 (Table 3, zero-shot)
Flickr·COCO(짧은 캡션)·Urban1k(긴 캡션) 검색에서, B3++(Qwen2-2B)가 UniME(7B)를 능가하고 B3++(Qwen2-7B)가 전 항목 최고. 메인 표의 검색 강세와 일관됨.
3.5 Ablation 요지
- K 효과(Table 4, |B|=512): K=8→67.40, K=32→67.58, K=512→67.28. 중간 K가 최적 — 정리 1·2의 상반된 방향을 실측으로 확인.
- 해상도(Table 4): max res 700(~600 토큰)→67.45, 1000(~1200 토큰)→67.87. 토큰 많을수록(=고해상도) 성능 향상.
- teacher 강도(Table 5): 약한 CLIP(400M) teacher로도 67.30(Random 65.35 대비 견고), 강한 VLM2Vec(7B) teacher는 67.57로 2B teacher(67.58)와 사실상 동일. teacher의 역할은 “강한 negative를 일부 집어주는 것”뿐이라, teacher 품질에 둔감함.
- GBM 대비(Fig. 3): GritLM 기반 배치 선택(GBM)을 모든 배치 크기에서 일관되게 상회. p가 작으면 false negative가 끼어 특히 작은 배치에서 성능이 떨어짐 — p 임계의 필요성 입증.
- 텍스트 일반화(Table 6): SimCSE와 동일 NLI 데이터·STS 벤치에서 B3가 SimCSE 상회(teacher에 hard negative가 있어도 추가 개선). 멀티모달을 넘어 텍스트로도 작동.
- 런타임(§4.8): 전부 오프라인 전처리. teacher 스코어링은 병렬화, 랭크 리스트 O(n log n), METIS O(n). 마인된 배치는 디스크에 저장해두고 학습 시 샘플링만 하면 됨.
4. 한계 및 비판
1) 정적(static) 배치 — 커리큘럼 부재 B3는 학습 전 한 번 배치를 마이닝해 디스크에 고정함. 학습이 진행되며 모델이 강해져도 배치는 그대로라, 모델 상태에 맞춰 난도를 조정하는 커리큘럼이 없음. GCBS가 중간 체크포인트에서 그래프를 다시 뽑는 것과 대비됨 — 단순·저비용을 얻은 대가로 적응성을 버림.
2) 전체 데이터셋 랭킹 비용 (대규모에서) rank matrix R은 N×N 구조이고, m열만 쓰니 결과 그래프 S는 희소하지만, 질의별 전체 positive 유사도를 teacher로 매기는 단계 자체가 본질적으로 O(N²) 연산임. 병렬화·오프라인이라 해도 코퍼스가 수천만~억 단위로 커지면 부담임. 논문은 task 단위(20개 MMEB 학습셋)로 마이닝해 N을 작게 유지하는데, 이 분할 가정이 깨지는 초대규모 단일 코퍼스에서는 검증 안 됨.
3) “이론적 정당화”의 느슨함 (저자도 인정에 가까움) 정리 1·2가 K에 대해 정반대 방향을 줄 뿐, 최적 K를 정해주지 못함 → 결국 held-out으로 튜닝. p·m도 task별 휴리스틱(p=30/70, m=100). 이론은 알고리즘을 동기부여하는 수준이지 보장(guarantee)을 주는 틀은 아님. 하이퍼파라미터 민감도(Fig. 3에서 작은 p의 false negative 타격)도 그 방증임.
4) MMEB in-domain 이득 주 평가셋 MMEB의 학습 split으로 학습함(임베딩 모델 관행). STS 일반화로 일부 방어하지만, 헤드라인 수치(68.1/72.0)에는 in-domain 이득이 섞여 있음을 감안할 것. OOD(16 task) 성능이 함께 좋다는 게 완화 근거.
5) teacher 의존의 잔여 리스크 teacher 품질에 둔감하다고 보였지만(CLIP teacher도 작동), teacher가 false negative를 잘못 거르거나 특정 분포에 편향되면 마인된 배치 전체가 그 편향을 물려받음. teacher의 역할이 “일부 강한 negative만 집기”로 작아 위험이 낮을 뿐, 0은 아님.
6) 멀티모달 일반화 폭 텍스트 일반화 검증이 STS(소규모 문장 유사도)에 그침. 저자도 “향후 MMEB급 대규모·더 넓은 멀티모달로 확장”을 future work로 남김 — 현재 결론의 사정거리는 MMEB+소형 텍스트 벤치까지임.
5. 결론
1) 핵심 기여는 “배치를 짜는 방식”으로 in-batch negative의 질을 끌어올린 것 개별 hard negative를 IID 배치에 끼우는 대신, teacher 랭킹 → false negative 제거(p) → 적당 난도 구간(m) → METIS 클러스터 → 클러스터 조립으로, 배치 전체를 상호 강한 negative로 만듦. 그 결과 추가 negative 없이 MMEB SOTA(+2.9/+1.3)를 달성하고, 배치 64만으로도 종전 2B SOTA를 넘음.
2) 설계 핵심은 “false negative 통제 + 적정 난도 + 오프라인” ablation이 보여주듯 너무 쉬운 상위 랭크(false negative)도, 너무 많은 강한 negative(큰 K)도 해로움 — p와 K가 그 사이를 잡음. 전 과정이 오프라인 전처리라 기존 학습 파이프라인에 최소 수정으로 얹히고, data synthesis·architecture 혁신과 직교·상보적임.
3) 효율과 범용성 — 그대로 얹히는 학습 모듈 B3는 모델 구조나 데이터 합성을 건드리지 않고 배치 구성만 바꾸는 오프라인 모듈이라, 기존 대조 임베딩 학습 파이프라인 위에 최소 수정으로 얹힘. 베이스 VLM이 좋아질수록 같이 좋아지고, 작은 배치·약한 teacher로도 견고해 자원 제약 환경까지 커버함. 학습 효율(배치 구성)이라는, 상대적으로 덜 주목받던 축에서 큰 이득을 끌어냈다는 점이 핵심 의의임.
배경 개념 정리
Contrastive Learning / InfoNCE (질의, positive) 쌍을 가까이, negative를 멀리 미는 임베딩 학습법. InfoNCE 손실은 질의-정답 유사도를 분자, 질의-모든 후보(정답+negative) 유사도 합을 분모로 둔 soft-max 형태. 전역(global) InfoNCE는 분모가 전체 데이터셋, 배치 InfoNCE는 분모가 배치 내로 제한됨 — B3의 목표는 후자로 전자를 잘 근사하는 것.
In-batch negative vs Hard negative in-batch negative는 같은 배치 안 다른 예시의 positive를 그냥 negative로 재활용하는 것(공짜지만 질이 우연에 좌우됨). hard negative는 질의와 헷갈리기 쉬운(겉은 비슷하나 의미는 다른) 예시를 일부러 캐서 끼우는 것(질은 좋지만 비쌈). B3는 배치 구성을 바꿔 in-batch negative를 hard negative 수준으로 끌어올림.
False negative 랭킹 상위에 올라온 예시 중 사실은 질의의 정답과 의미가 같거나 매우 가까워 negative로 쓰면 안 되는 것. negative로 쓰면 모델이 맞는 답을 밀어내게 됨. B3는 상위 p개를 버려 이를 거름(NV-Retriever 임계).
METIS / Community detection 그래프를 커뮤니티(클러스터)로 나누는 min-cut 알고리즘. 커뮤니티 내부 엣지는 최대, 커뮤니티 간 엣지는 최소가 되도록 분할. B3에선 “같은 배치 선호” 엣지로 만든 그래프에 적용해, 서로 강한 negative인 예시 집단을 K개씩 묶음. 희소 그래프라 근사적으로 O(n).
Teacher-based ranking 이미 학습된 teacher 임베딩 모델로 예시 간 유사도를 매겨 랭크 행렬을 얻는 것. B3에서 teacher의 역할은 정답을 가르치는 게 아니라 “누가 누구의 강한 negative인지”를 집어주는 것뿐이라, teacher 품질에 둔감함(약한 CLIP teacher로도 작동).
MMEB (Massive Multimodal Embedding Benchmark) 검색·분류·VQA·grounding 4범주 36 task로 멀티모달 임베딩 능력을 재는 벤치마크. ID 20 + OOD 16 task. 지표는 accuracy. VLM2Vec가 학습/평가 표준을 깐 무대로, B3가 SOTA를 갱신한 곳.
B3 vs B3++ B3 = 배치 마이닝 + positive 프롬프트(추가 negative 없음, 자원 제약 친화). B3++ = B3 + 통합 hard negative 샘플링(h=5). B3++가 상한이 더 높지만, B3가 Random+5hn을 절반 연산으로 앞설 만큼 이미 강함.
부록: 왜 METIS인가 (2026-07-05)
전체를 세부까지 파기보다, METIS가 다른 클러스터링과 뭐가 다르고 왜 B3에 맞는지 두 갈래로만 좁힘.
METIS의 성질 (다른 클러스터링과 다른 점) METIS는 “자연스러운 덩어리를 찾는” 알고리즘이 아니라 크기를 강제로 맞춰 쪼개는 분할 알고리즘임. 성질 셋:
- 균등 크기 — K-means·Louvain은 클러스터 크기가 데이터에 따라 제각각 나오지만, METIS는 “모든 조각을 크기 K로 균등하게”를 제약으로 검.
- min-cut 최적화 — 그 균등 제약 아래에서 조각 사이를 지나는 엣지 수를 최소화함. 강하게 얽힌 노드는 같은 조각에, 약하게 연결된 노드는 다른 조각으로.
- 빠름 — multilevel 방식(뭉치기 → 대충 자르기 → 되돌리며 다듬기)으로 sparse 그래프에서 거의 노드 수에 비례(O(n))하는 속도로 돎.
왜 이게 B3에 맞나 B3가 METIS에서 원하는 게 정확히 이 세 성질임:
배치를 만들려면 크기가 정확히 K인 조각이 필요함( B /K개를 모아 한 배치 구성). Louvain처럼 크기가 들쭉날쭉하면 배치를 못 짬 → METIS의 균등 크기 제약이 이걸 공짜로 해결. - B3에서 엣지 = “같은 배치에 넣으면 좋은 강한 negative” 관계임. 따라서 cut 최소화 = 서로 강한 negative인 예시를 같은 배치에 모으고, 관계 약한 예시는 다른 배치로 밀어냄 = B3가 노리는 “in-batch negative가 빽빽한 배치”와 정확히 일치.
- 전체 학습 데이터(수백만~수천만 행)에 offline으로 한 번 돌려야 하니 속도가 필수 → multilevel의 O(n)급 속도가 이걸 가능하게 함.
한마디로 “크기 고정 + 내부는 촘촘하게”가 배치의 요구조건과 그대로 겹침.
공짜는 아님 — 균등 크기를 강제하다 보니 자연스러운 덩어리가 K보다 크면 억지로 쪼개고, 작으면 무관한 노드를 끌어와 채움. 그래서 K를 너무 크게 잡으면 한 배치 안에 약하게 연결된 노드까지 섞여 품질이 떨어짐 — 논문이 K를 경험적으로 튜닝한 이유가 이것(§2.3 정리 1·2가 K에 대해 상반된 방향을 가리킨다는 점과도 맞물림).