MSRL
Breaking the SFT Plateau: Multimodal Structured Reinforcement Learning for Chart-to-Code Generation
Authors: Lei Chen, Xuanle Zhao, Zhixiong Zeng, Jing Huang, Liming Zheng, Yufeng Zhong, Lin Ma (Meituan) — arXiv 2508.13587, ICLR 2026. 모델명 MSRL.
차트→코드 생성(chart-to-code) 논문이며, 직전에 본 MOCR과 같은 “이미지를 실행 가능한 코드로 복원”하는 계보에 있음. 저자진(Xuanle Zhao·Zhixiong Zeng·Yufeng Zhong·Lin Ma 등)이 MOCR 리뷰에서 다룬 OCRVerse·ChartCoder·VinciCoder를 만든 그 Meituan 그룹이라, MOCR이 “그래픽 전반을 SVG로” 갔다면 이쪽은 “차트를 matplotlib 코드로” 가는 자매 작업임. 다만 무게중심이 다름: MOCR이 무엇을 파싱하느냐(task·data engine) 를 넓혔다면, MSRL은 어떻게 학습시키느냐(SFT→RL) 를 파고듦. 핵심 주장이 B3와 한 짝으로 읽힘 — B3가 “배치/데이터를 더 키워도 한계가 오니 똑똑한 배치 구성으로 뚫는다”였다면, MSRL은 “SFT 데이터를 더 부어도 정체(plateau)되니 구조화된 강화학습으로 뚫는다”임. 둘 다 데이터 무지성 스케일링의 천장을 진단하고 더 똑똑한 학습 신호로 넘는다는 같은 서사임. 평가의 “렌더해서 원본과 비교”(render-and-compare) 철학도 MOCR의 ISVGEN과 같은 뿌리고, 그 그림자(시각 유사도≠코드 정확성)도 같이 물려받음.
1. 문제 정의
핵심 문제
차트 이미지를 보고 그 차트를 재현하는 실행 가능한 코드(matplotlib) 를 생성하는 것이 핵심 문제임.
차트는 과학·비즈니스·통계 정보를 압축해 전달하지만, 그 정보가 시각 포맷에 갇혀 자동 시스템이 해석·재활용하기 어려움. MLLM이 차트를 코드로 정확히 변환하면 시각 이해와 구조적 추론을 동시에 끌어올릴 뿐 아니라, 과학 시각화의 자동 재현 같은 실용 가치가 큼.
기존 연구의 한계
1) 합성 데이터 + SFT/DPO의 한계 기존 차트→코드 데이터셋은 순수 합성이라 단조로운 추세·낮은 다양성을 보임. 그 위에 SFT나 DPO로 학습하니 성능이 제한됨(단순 패턴·빈약한 일반화).
2) SFT 데이터 스케일링의 정체(이 논문의 핵심 발견) 저자들은 사상 최대 규모(3M chart-code pairs, 24개 차트 유형) 코퍼스를 실제 arXiv 표에서 만들어 200k→2.8M로 데이터를 키우며 SFT를 돌림. 결과는 명확한 plateau — 400k까지 급상승, 1.6M까지 완만, 2M 이후 사실상 정체(2M→2.8M 무이득). 즉 데이터 양만으로는 천장을 못 넘음.
3) SFT 목적함수의 구조적 결함 SFT의 NLL은 모든 토큰을 균등하게 취급함. 그런데 플로팅 코드는 대부분 plt.plot 같은 상용구(boilerplate) 이고, 정작 중요한 데이터 값·스타일 파라미터는 드물게 등장함. 그래서 SFT는 희소하지만 결정적인 토큰을 우선 학습하지 못함 — 이게 정체의 근원이라는 진단.
2. 제안 방법: MSRL
포화된 SFT 모델 위에, 텍스트·시각 두 입자(granularity)의 보상을 쓰는 2단계 강화학습을 얹어 SFT 천장을 넘는 전략임.
2.1 핵심 아이디어
데이터를 더 붓는 대신, “어느 토큰이 중요한지”를 보상으로 가르친다 — 코드 디테일은 규칙 기반 텍스트 보상으로, 전체 차트 구조는 렌더 후 시각 보상으로.
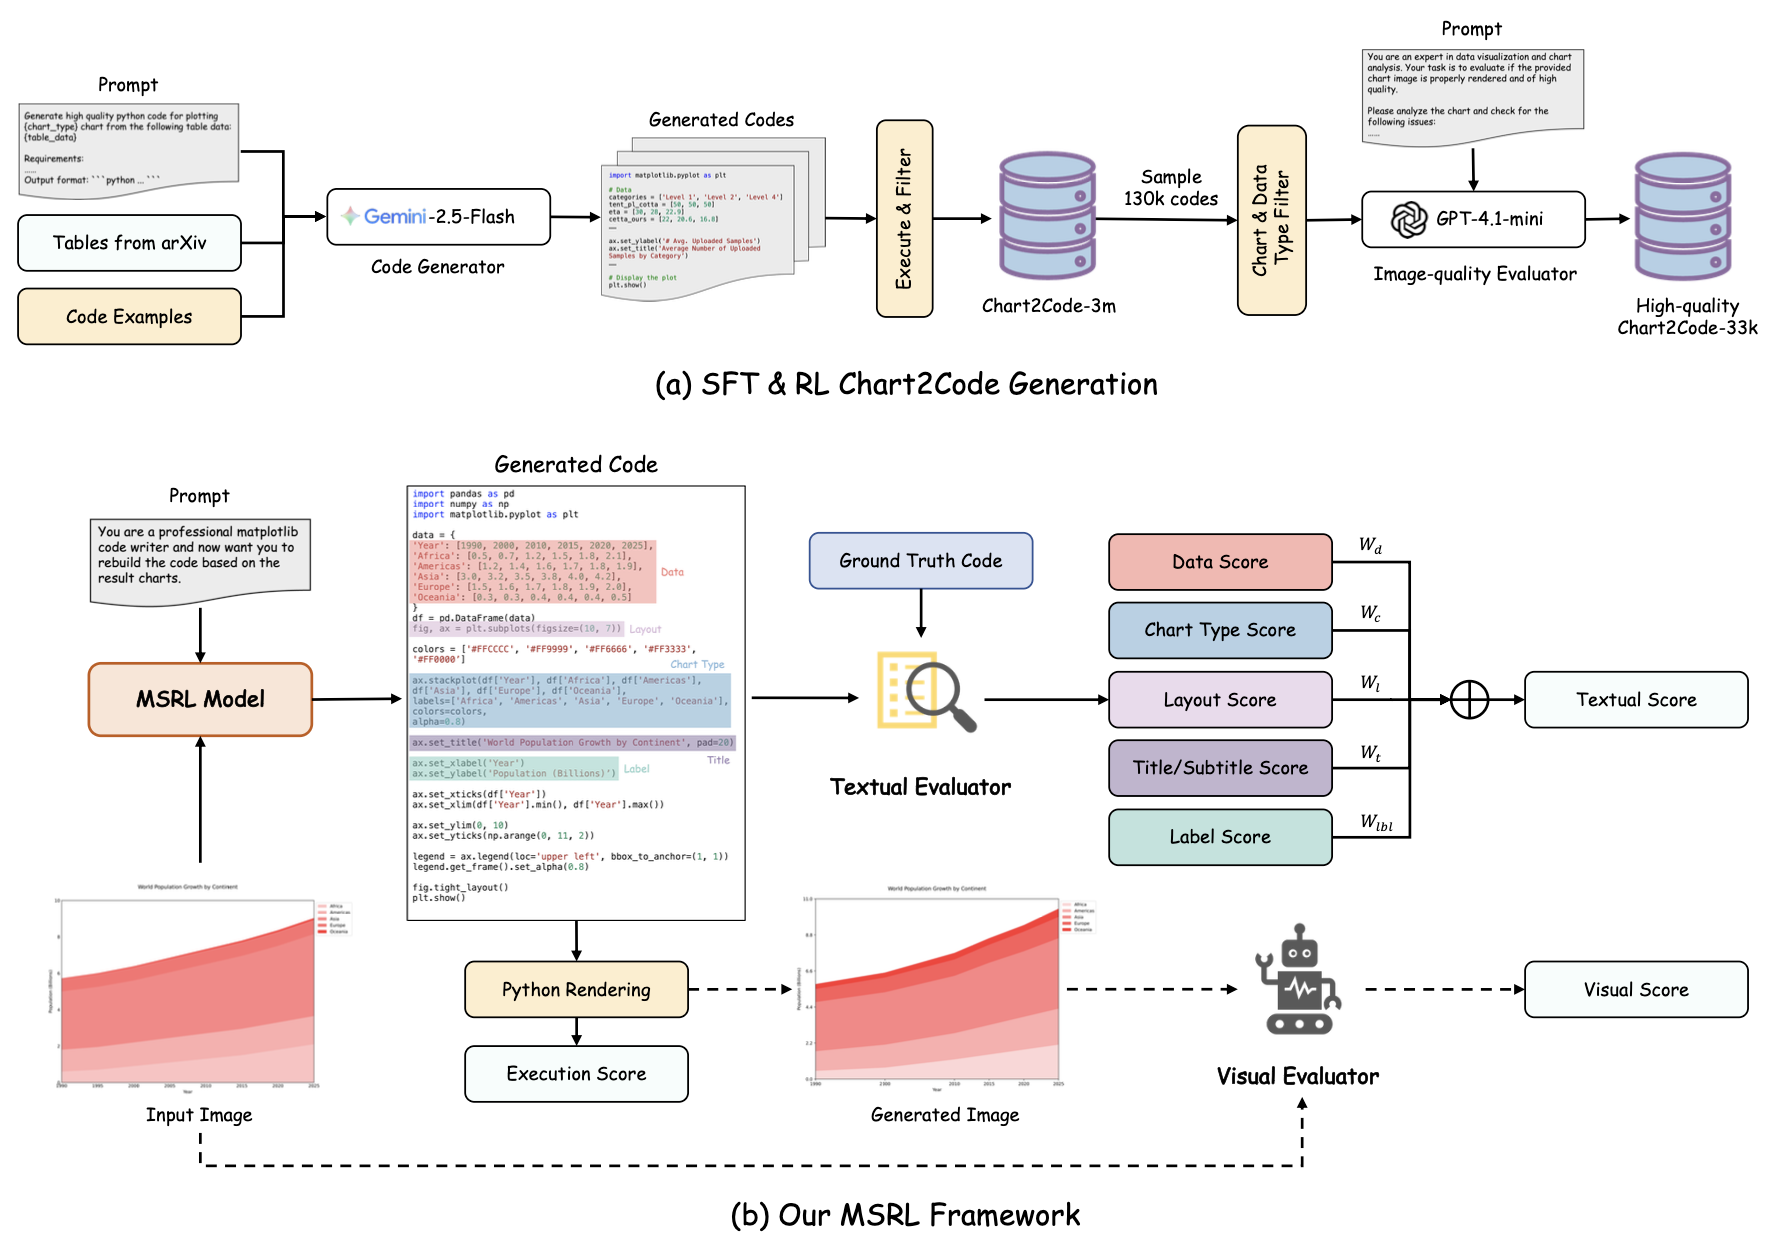
위 그림 (a)는 arXiv 표→Gemini 코드 생성→실행·필터→심판으로 고품질 Chart2Code 데이터를 거르는 파이프라인이고, (b)는 MSRL 프레임워크임 — 생성 코드를 텍스트 평가기(데이터·유형·레이아웃·제목·라벨)와, 렌더 이미지를 시각 평가기로 채점해 두 보상을 합침.
SFT가 못 하는 “중요 토큰 우선 학습”을, 정답 데이터 값·차트 유형·레이아웃의 정확성을 직접 보상하는 RLVR로 해결함. 텍스트 보상만으로는 전체 그림의 구조를 못 보므로, 생성 코드를 렌더해 이미지로 만든 뒤 MLLM이 원본과의 유사도를 채점하는 시각 보상을 더함.
정체 진단 → 똑똑한 신호로 돌파라는 구조가 B3와 쌍둥이임. B3는 in-batch negative의 “질”을 배치 구성으로 끌어올렸고, MSRL은 토큰의 “중요도”를 보상 설계로 끌어올림 — 둘 다 양적 스케일링(배치·데이터)의 한계를 명시하고 질적 신호로 넘음. 그리고 MOCR과는 “이미지→코드 + render-and-compare 평가”를 공유하되, MOCR이 SFT+데이터 엔진으로 task를 넓혔다면 MSRL은 같은 task류에서 학습 패러다임(RL) 을 갈아끼움. 이 논문이 굳이 포화된 SFT 베이스라인을 먼저 세워 RL의 순효과를 분리한 것도, “RL이 좋은 게 아니라 SFT가 덜 됐던 것 아니냐”는 반론을 차단하려는 설계임.
2.2 데이터 파이프라인
| 단계 | 내용 |
|---|---|
| 표 수집 | arXiv 논문(ChartMimic 오염 방지 위해 2023년 이전)에서 실제 표 크롤 |
| 코드 생성 | Gemini-2.5-Flash에 표 + 코드 예시를 주고 플로팅 코드 생성 → 실행·필터 → 3M pairs(24 유형) |
| RL 데이터 정제 | 130k 샘플 → ① 코드 내용 필터(차트·데이터 유형; 멀티유형은 트리 파싱; 1D 배열·비중첩 dict만 유지) → 45k → ② 시각 품질 필터(GPT-4.1-mini 심판; 0점 100개 수동검수 시 인간 일치 >90%) → 최종 33k |
| SFT 데이터 | 나머지 2.8M. SFT/RL 코퍼스를 분리해 SFT 형식 과적합 방지·RL 탐색력 강화 |
데이터셋 비교(Table 1): 본 데이터는 실데이터 출처 ✓, 멀티차트 ✓, 24 유형, 3M 샘플, 1,555 API 유형 — ChartCoder(187)·Chart2Code(168) 대비 규모·다양성에서 압도.
2.3 다입자 보상(multi-granularity reward)
① 텍스트 보상(규칙 기반 RLVR) 스타일 다양성 탓에 critical 정보 파싱이 어려워, 먼저 코드 정규화(canonicalization) 로 구문 변형에 불변인 표준형으로 매핑. 그 뒤 5개 항목 가중 평균: 데이터 값(soft matching, ±5% 허용, w=0.4)·차트 유형(hard string, 0.3)·레이아웃(hard value, 0.1)·제목/부제(edit distance, 0.1)·라벨(edit distance, 0.1). 별도로 실행 보상(코드가 돌면 1, w=0.5).
② 시각 보상(모델 기반) 생성 코드를 렌더 → Qwen2.5-VL-72B가 원본과 6항목(유형·레이아웃·텍스트·데이터·스타일·명료성)으로 채점 → 정규화. 렌더 실패 시 보상 0.
③ 총 보상: R = w_t·R_text + w_v·R_vis + w_e·R_exec. 알고리즘은 GRPO(그룹 상대 advantage).
2.4 2단계 커리큘럼 RL
시각 보상은 렌더+MLLM 채점이라 비쌈. 그래서 1단계: 텍스트 보상만(22k, w_t=1·w_v=0·w_e=0.5)로 SFT 천장을 먼저 넘고, 2단계: 텍스트+시각 하이브리드(11k, 0.5/0.5/0.5)로 시각 충실도를 마무리. 비용↔성능 균형.
3. 실험 결과
베이스 Qwen2.5-VL-7B. ChartMimic(Direct Mimic 600)·ReachQA(500) zero-shot 평가. Exec.Rate(실행률)·Low-level(요소 정확도)·High-level(전체 충실도).
3.1 메인 결과
| 모델 | ChartMimic (Exec/Low/High) | ReachQA (Exec/Low/High) |
|---|---|---|
| GPT-4o (proprietary) | 93.2 / 79.0 / 83.5 | 92.8 / 81.8 / 84.0 |
| ChartCoder 7B (종전 차트 SOTA) | 91.4 / 72.5 / 74.0 | 83.8 / 67.9 / 69.4 |
| MSRL-SFT 7B | 93.2 / 73.0 / 77.6 | 92.2 / 78.6 / 80.0 |
| MSRL 7B | 96.5 / 78.6 / 83.8 | 98.2 / 86.1 / 89.9 |
오픈소스 전부를 능가하고, 7B 모델로 훨씬 큰 GPT-4o에 필적·일부 추월(실행률·high-level). RL이 SFT 대비 high-level을 ChartMimic +6.2%·ReachQA +9.9% 끌어올림. 세부 low-level(Table 3)에서도 MSRL이 GPT-4o를 다수 항목에서 앞섬(예: ChartMimic Layout 93.0 vs 89.8, ReachQA Text 87.5 vs 84.4).
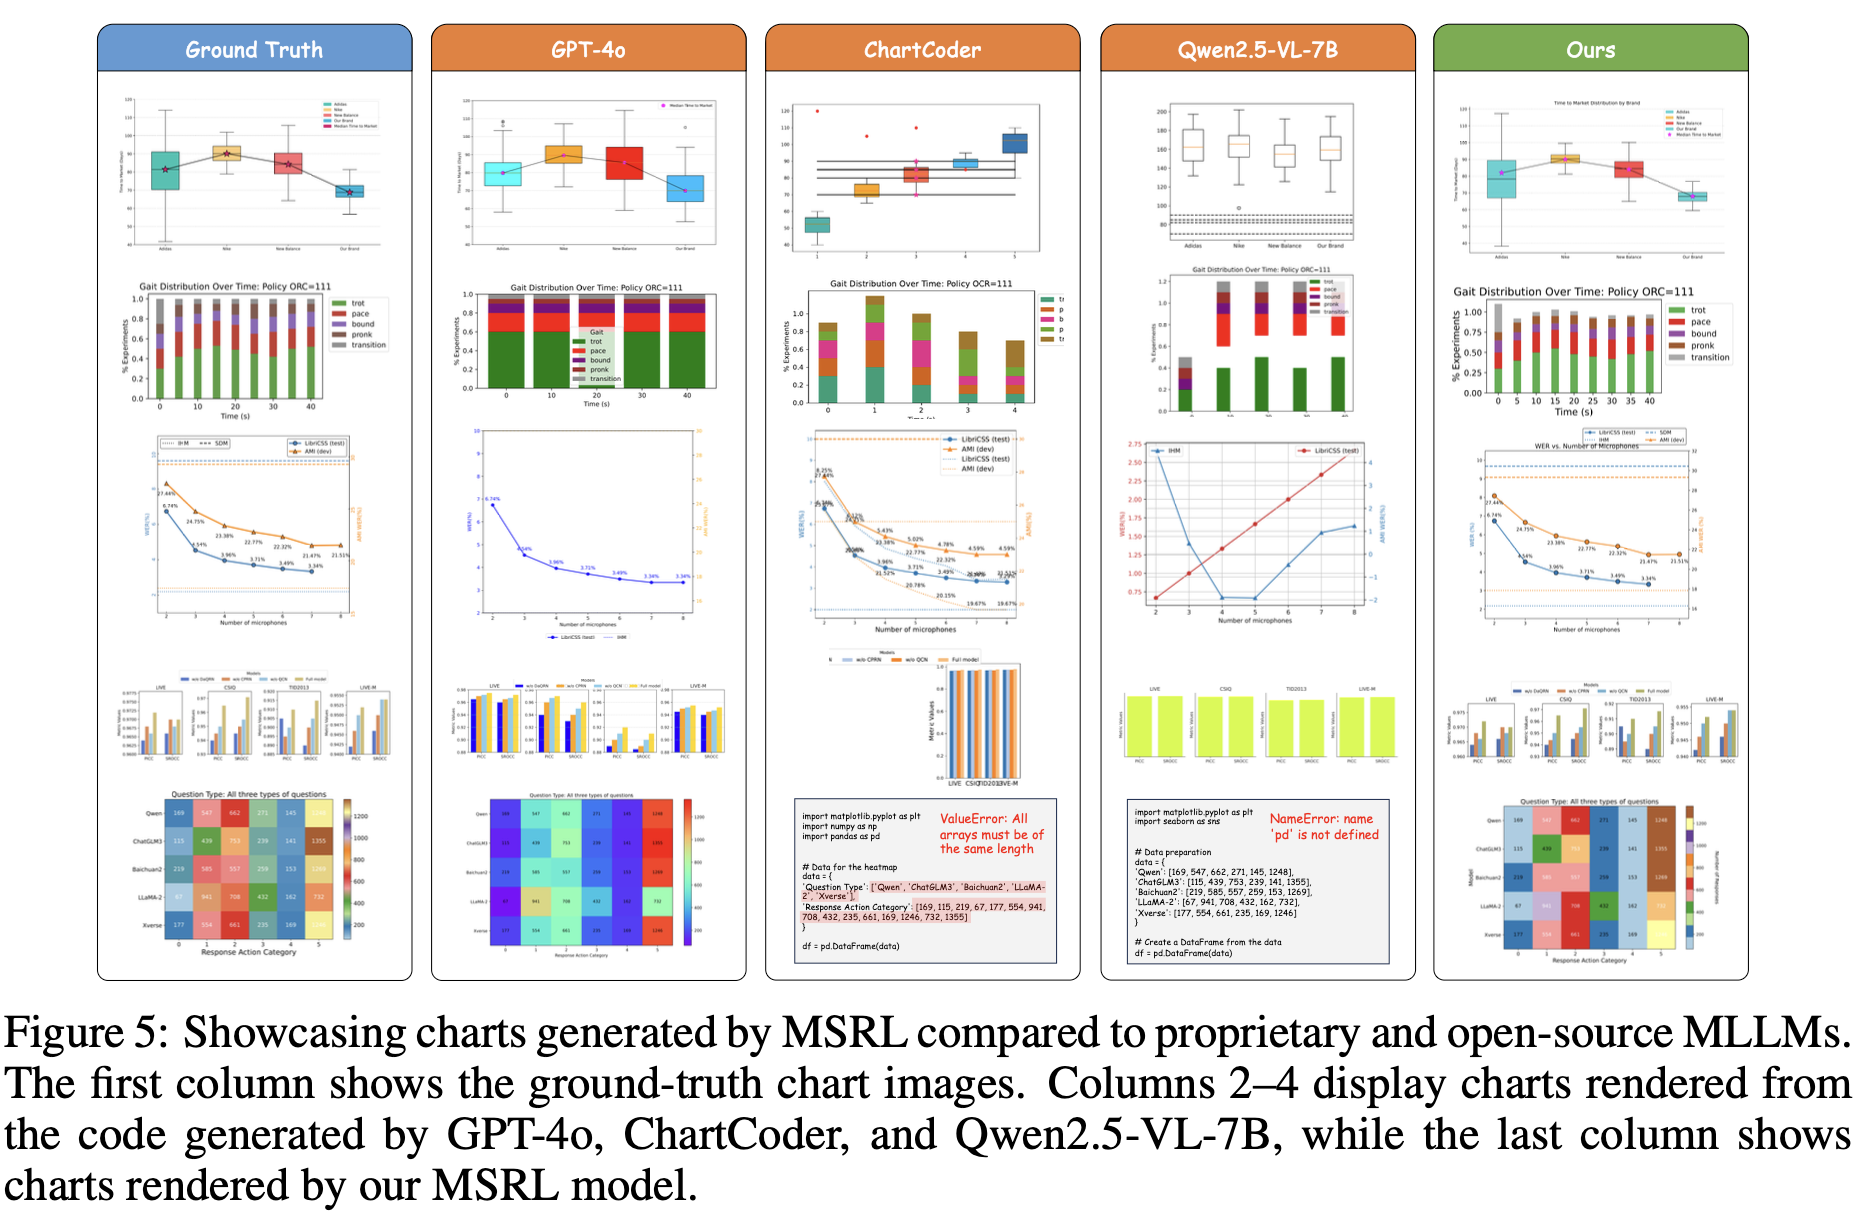
맨 왼쪽이 원본 차트, 오른쪽 끝이 MSRL이 생성한 코드의 렌더 결과임. 베이스라인들이 데이터·레이아웃·스타일에서 틀어지는 사례에서도 MSRL은 원본에 가깝게 재현함.
3.2 정체와 돌파 (Fig. 1·4)
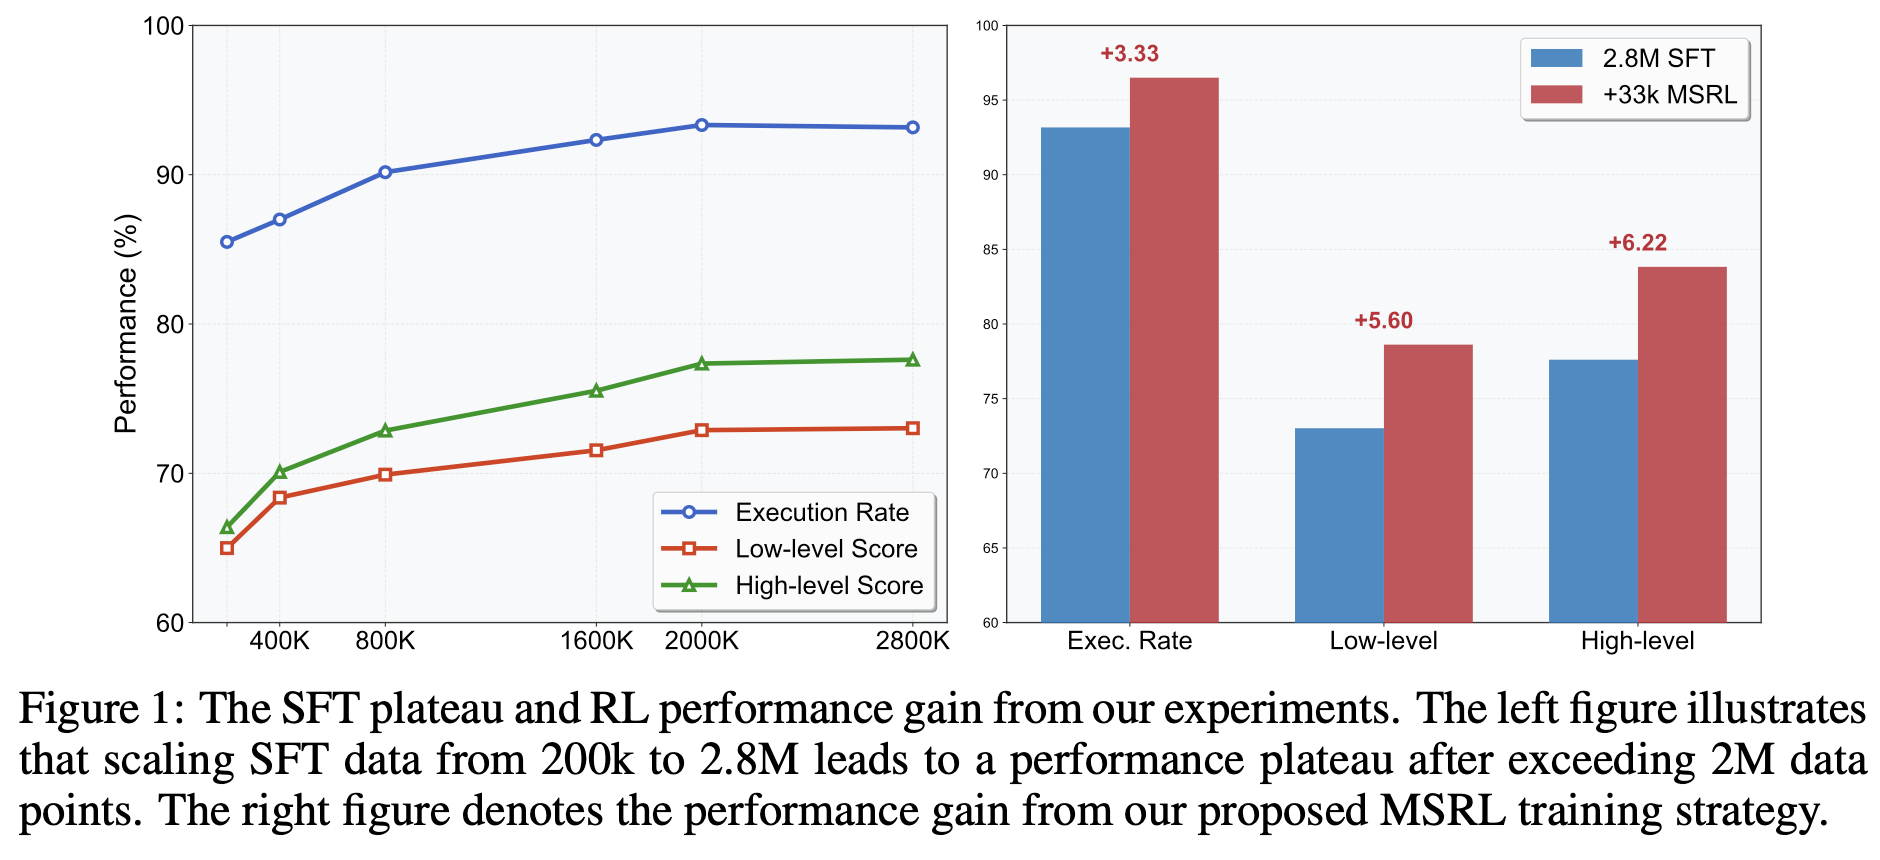
왼쪽 곡선이 SFT 데이터를 2M 넘게 부어도 성능이 정체됨을 보이고, 오른쪽 막대가 그 위에 MSRL을 얹었을 때의 순이득(Exec +3.33, Low +5.60, High +6.22)을 보임.
- SFT plateau: 400k 급상승 → 1.6M 완만 → 2M 이후 정체. 2M→2.8M 무이득.
- RL plateau: 1단계(텍스트) ~+5%, 22k에서 수렴. 2단계(멀티모달) ~+1.5%, 11k에서 수렴. RL도 천장이 있되 더 높은 곳에 있음.
3.3 Ablation 요지
- SFT/RL 상호작용(Table 4, 텍스트 보상만): SFT-only 93.17/73.02/77.61, RL-only 93.83/65.60/62.29(불포화 베이스에 RL만 하면 low/high가 SFT보다 낮음 — 실행 보상 덕에 exec만 높음), SFT+RL 97.00/78.06/82.69. 포화 SFT 위에서도 RL이 천장을 넘는다는 게 핵심.
- 보상·비용(Table 5, H800 GPU시간): (T)만 240h·82.69, (V)만 1344h·84.01(가장 강하나 5.6배 비쌈), (T→T+V) 912h·83.81, (T→T+V, 절반 샘플) 576h·83.83을 채택(효율 최적).
- 미지 라이브러리 일반화(Table 6): matplotlib만 학습했는데 Seaborn(85.1/30.5)·Plotly(90.0/35.9)에서 Qwen2.5-VL-7B(69.2/25.7, 62.7/22.6)를 크게 앞섬 — OOD 전이 확인.
- 시각 심판 선택(부록): 인간 상관은 GPT-4.1 > Qwen2.5-VL-72B > Qwen2.5-VL-7B. reward hacking 방지·예산 고려로 Qwen2.5-VL-72B 채택. 순수 비전 모델(InternViT·DINOv2-L)은 개선되나 VLM 심판에 못 미침 — image-text matching은 차트 요소의 미세 차이를 못 잡음.
- GRPO vs DPO(부록): GRPO 78.6/83.8 > DPO 74.0/78.9 > SFT 73.0/77.6. 차트→코드는 규칙으로 보상이 잘 정의돼 GRPO에 적합, DPO는 “나쁜 코드”를 명확히 정의하기 어려움.
- 데이터 비교(부록): 본 데이터가 ChartCoder 데이터를 SFT(73.0/77.6 vs 68.5/68.0)·RL(78.6/83.8 vs 76.5/81.2) 모두에서 앞섬.
4. 한계 및 비판
1) 모델이 모델을 채점하는 순환 (전 단계에 걸침) SFT 데이터는 Gemini-2.5-Flash가 생성, RL 데이터는 GPT-4.1-mini가 필터, 시각 보상은 Qwen2.5-VL-72B가 채점. 생성→필터→보상이 전부 대형/상용 VLM 판단에 기댐. 저자도 reward hacking을 의식해 (상관이 더 높은 GPT-4.1 대신) Qwen-72B를 고르고 100샘플 인간 검수를 붙였지만, 사슬 자체는 여전히 “모델이 만든 데이터를 모델이 거르고 모델이 보상”하는 구조 — MOCR·PaddleOCR-VL 리뷰의 자기 생태계 순환 우려와 같은 계열.
2) 시각 보상 = render-and-compare → 코드 정확성이 아니라 시각 유사도를 보상 렌더 이미지의 닮음을 채점하므로, 데이터가 틀려도 그림이 비슷하면 후하게 나올 수 있음(텍스트 보상의 데이터 값 매칭으로 일부 보완하나, 시각 신호 자체는 거침). MOCR의 ISVGEN에서 지적한 한계가 보상 함수로 들어온 형태.
3) 평가-보상의 철학 공유 → 메트릭에 맞춰 학습할 위험 학습 보상(렌더 일치)과 평가 지표(ChartMimic/ReachQA의 렌더 mimic)가 같은 “그림이 맞나” 철학임. arXiv ≤2023으로 데이터 오염은 막았지만, 보상과 평가가 한 방향이라 높은 점수의 일부는 “메트릭에 정렬되도록 최적화한” 효과일 수 있음.
4) RL도 빠르게 새 천장에 부딪힘 텍스트 +5%(22k 수렴)·시각 +1.5%(11k 수렴)로, “SFT 천장을 넘는다”는 맞지만 곧 더 높은 RL 천장에 도달함. 특히 비싼 시각 보상(5.6배 비용)이 +1.5%만 보태 한계효용이 작음. “plateau를 깬다”는 서사는 “더 높은 plateau로 옮긴다”가 더 정확.
5) 도메인·데이터 구조의 협소함 matplotlib 중심이고, OOD 일반화는 보였으나 테스트셋이 작고(107/150장) high-level 절대값이 낮음(30.5/35.9) — “된다” 수준이지 “강하다”는 아님. RL 필터가 1D 배열·비중첩 dict만 남겨, 복잡한 중첩 데이터 구조는 애초에 RL 최적화 대상에서 빠짐.
6) 실행 보상의 약한 신호 RL-only가 exec는 높지만 low/high는 낮다는 결과처럼, 실행 보상은 “돌기만 하면” 주어져 단독으론 품질을 못 가름. 텍스트·시각 보상과의 결합이 전제.
5. 결론
1) 핵심 기여는 “SFT 정체의 정량적 규명 + RL로 돌파” 사상 최대 3M 실데이터 코퍼스로 SFT 데이터 스케일링의 천장을 분명히 보이고, 포화 SFT 위에 다입자 보상 RL을 얹어 그 천장을 넘음. 7B로 오픈소스 전부를 능가하고 GPT-4o에 필적. RL의 순효과를 분리하려 포화 베이스라인을 세운 실험 설계가 단단함.
2) 설계 핵심은 “중요 토큰을 보상으로 가르치기 + 2단계 커리큘럼” 코드 정규화 후 데이터·유형·레이아웃을 규칙 보상(텍스트)으로, 전체 구조를 렌더-채점(시각)으로 잡되, 비싼 시각 보상은 2단계로 미뤄 비용을 통제. GRPO가 규칙 보상과 맞물려 DPO를 앞섬.
3) 계보에서의 위치 — 이미지→코드 진영의 “학습 방법론” 축 MOCR이 같은 그룹에서 “무엇을 코드로 복원하느냐(SVG·task)”를 넓혔다면, MSRL은 같은 차트→코드 task에서 “어떻게 학습하느냐(SFT→RL)”를 파고든 보완재임. B3와는 “데이터 무지성 스케일링의 천장을 진단하고 더 똑똑한 신호로 넘는다”는 한 서사를 공유하고(B3=배치 구성, MSRL=보상 설계), render-and-compare 평가·자기 생태계 순환의 그림자는 MOCR과 함께 짊어짐. 차트/그래픽-투-코드에 RLVR을 본격 이식한 한 칸으로 읽으면, 출력이 길고 구조화된 멀티모달 생성에서 RL이 SFT를 넘는 일반 레시피로 확장될 여지가 보임.
배경 개념 정리
Chart-to-code 차트 이미지를 입력받아 그 차트를 그리는 실행 가능한 코드(주로 matplotlib)를 생성하는 task. 출력이 길고 강하게 구조화된 코드라, 단순 인식보다 시각 이해+구조 추론+코드 문법이 겹침. MOCR의 image-to-SVG와 형제 관계.
SFT plateau (지도학습 미세조정의 정체) SFT 데이터를 계속 늘려도 성능이 더는 오르지 않는 포화 현상. 이 논문은 200k→2.8M 실험으로 2M 부근에서 정체를 실증함. 원인은 NLL이 모든 토큰을 균등 취급해 희소한 핵심 토큰(데이터 값·스타일)을 우선 못 배우는 데 있음.
RLVR / GRPO RLVR(Reinforcement Learning with Verifiable Rewards)은 정답 여부를 규칙으로 검증 가능한 보상으로 LLM을 최적화하는 패러다임(DeepSeek-R1 계열). GRPO(Group Relative Policy Optimization)는 한 프롬프트에서 여러 응답을 뽑아 그룹 내 상대 우열로 advantage를 계산하는 알고리즘으로, 규칙 보상이 잘 정의되는 차트→코드에 적합.
다입자 보상(multi-granularity reward) / 코드 정규화 미세한 코드 디테일은 규칙 기반 텍스트 보상으로, 전체 차트 구조는 렌더-채점 시각 보상으로 동시에 거는 설계. 텍스트 보상 전에 코드를 표준형으로 정규화해, 같은 의미의 다른 표기(구문 변형)에 보상이 흔들리지 않게 함.
Render-and-compare 시각 보상 생성 코드를 실제로 렌더해 이미지로 만든 뒤, MLLM(Qwen2.5-VL-72B)이 원본과 6항목으로 채점해 보상으로 쓰는 방식. 전체 시각 충실도를 잡지만, 그림이 닮으면 코드·데이터가 틀려도 후해질 수 있다는 한계가 따름.
Soft value matching (±5%) 데이터 값 보상에서 정확히 일치가 아니라 상대오차 ±5% 이내면 맞다고 보는 완화 매칭. 부동소수·반올림 차이로 인한 과벌점을 막아 RLVR 신호를 안정화함.