ColPali
ColPali: Efficient Document Retrieval with Vision Language Models
Authors: Manuel Faysse, Hugues Sibille, Tony Wu, et al. (Illuin Technology, CentraleSupélec, ETH Zürich) — arXiv 2407.01449, ICLR 2025.
문서 검색(retrieval) 논문임. 같은 적 — 문서의 시각 정보와 무거운 전처리 파이프라인 — 을 겨누되, task가 다름. MinerU2.5/PaddleOCR-VL이 문서를 “변환(파싱)”하고 DocOwl2가 “이해(VQA)”한다면, ColPali는 질의에 맞는 페이지를 “찾음(retrieval)”. 그리고 답이 가장 급진적임: 파싱 파이프라인을 고치는 게 아니라 아예 건너뜀. 페이지 이미지를 그대로 임베딩해 검색하는 “Retrieval in Vision Space” 개념을 제안하고, 이를 재는 벤치마크 ViDoRe까지 함께 공개함. RAG 파이프라인의 검색 단을 실질적으로 바꿔놓은 논문임.
1. 문제 정의
핵심 문제
시각적으로 풍부한 문서를 정확하고 빠르게 검색하는 것이 핵심 문제임.
문서는 텍스트만으로 정보를 전달하지 않음. 그림·레이아웃·표·폰트까지 동원해 사람에게 효율적으로 정보를 전달함. 그런데 현대 검색 시스템은 문서에서 추출한 텍스트에만 의존하므로 이 시각 단서를 거의 못 씀. RAG가 산업 표준이 되면서 이 약점이 실무 병목으로 드러남.
저자들의 핵심 관찰: 실무에서 검색 성능의 병목은 임베딩 모델이 아니라 그 앞단의 인제스천(ingestion) 파이프라인임. PDF 한 장을 색인하려면 OCR/파서로 텍스트 추출 → 레이아웃 검출 → 청킹 → (시각 요소는) 캡셔닝까지 거쳐야 하는데, 길고 부서지기 쉬움. 실제 실험에서도 임베딩 모델을 바꾸는 것보다 인제스천을 손보는 게 성능에 훨씬 크게 작용함.
이를 산업 요건 세 가지로 정식화함: (R1) 검색 성능, (R2) 빠른 온라인 질의 latency, (R3) 높은 색인 throughput.
기존 연구의 한계
1) 텍스트 검색 파이프라인 (BM25, BGE-M3 + Unstructured류 파서) 강력하지만 시각 정보가 병목임. OCR·캡셔닝으로 시각 요소를 텍스트화해 보강할 수 있으나, 색인 비용이 폭증함(페이지당 7초대). BM25와 신경 임베딩(BGE-M3)의 차이가 작다는 결과 자체가 “임베딩이 아니라 입력 정보가 문제”라는 증거임.
2) Contrastive VLM (CLIP·SigLIP류) 이미지-텍스트 정렬은 되지만 단일 벡터로 페이지 전체를 요약하므로, 빽빽한 문서의 세부 텍스트 정보를 담기엔 표현력이 부족함. ViDoRe에서 텍스트 파이프라인에도 크게 뒤짐.
3) 평가 공백 텍스트 검색 벤치(BEIR·MTEB)는 텍스트 패시지 수준이고, 비전 검색 벤치는 자연 이미지 중심임. 문서 검색을 텍스트+시각 양쪽 능력으로, end-to-end로 재는 벤치마크가 없었음.
2. 제안 방법: ViDoRe + ColPali
2.1 ViDoRe 벤치마크
페이지 수준 문서 검색 벤치마크. 학술 task 5종(DocVQA·InfoVQA·TAT-DQA·arXivQA·TabFQuAD — 기존 VQA 셋의 질문을 질의로, 해당 페이지를 정답 문서로 재활용)과 실전 task 5종(Energy·Government·Healthcare·AI·Shift — 주제별 PDF 1,000페이지 + Claude-3 Sonnet 생성 후 사람이 검수한 질의 100개)으로 구성됨. 영어·프랑스어를 포함하고, 주제를 일부러 좁게 잡아 문서 간 구문 유사도를 높임(어려운 검색). 주 지표는 nDCG@5.
2.2 핵심 아이디어
파싱하지 말고, 페이지 이미지를 그대로 multi-vector로 임베딩한 뒤, 질의 토큰과 늦게(late) 상호작용시킨다.
세 가지 요소의 조합임: (1) VLM(PaliGemma-3B)으로 페이지 이미지를 인코딩하고, (2) LLM 출력 토큰(이미지 패치 포함)을 D=128로 사영해 패치당 벡터 하나씩 보존하며, (3) 질의-문서 매칭은 ColBERT식 late interaction으로 함 — 질의 토큰마다 모든 문서 패치 벡터와의 최대 내적(MaxSim)을 구해 합산.
1
2
색인(offline): 페이지 이미지 → PaliGemma → 패치별 128차원 벡터 묶음 (~1030개/페이지)
질의(online):  질의 텍스트 → 같은 모델 → 토큰별 벡터 → MaxSim 합산으로 페이지 점수
OCR·레이아웃 검출·청킹·캡셔닝이 전부 사라짐. 색인이 모델 forward 한 번이라 end-to-end 학습이 가능해지고, 이게 도메인 적응(fine-tuning)까지 쉽게 만듦.
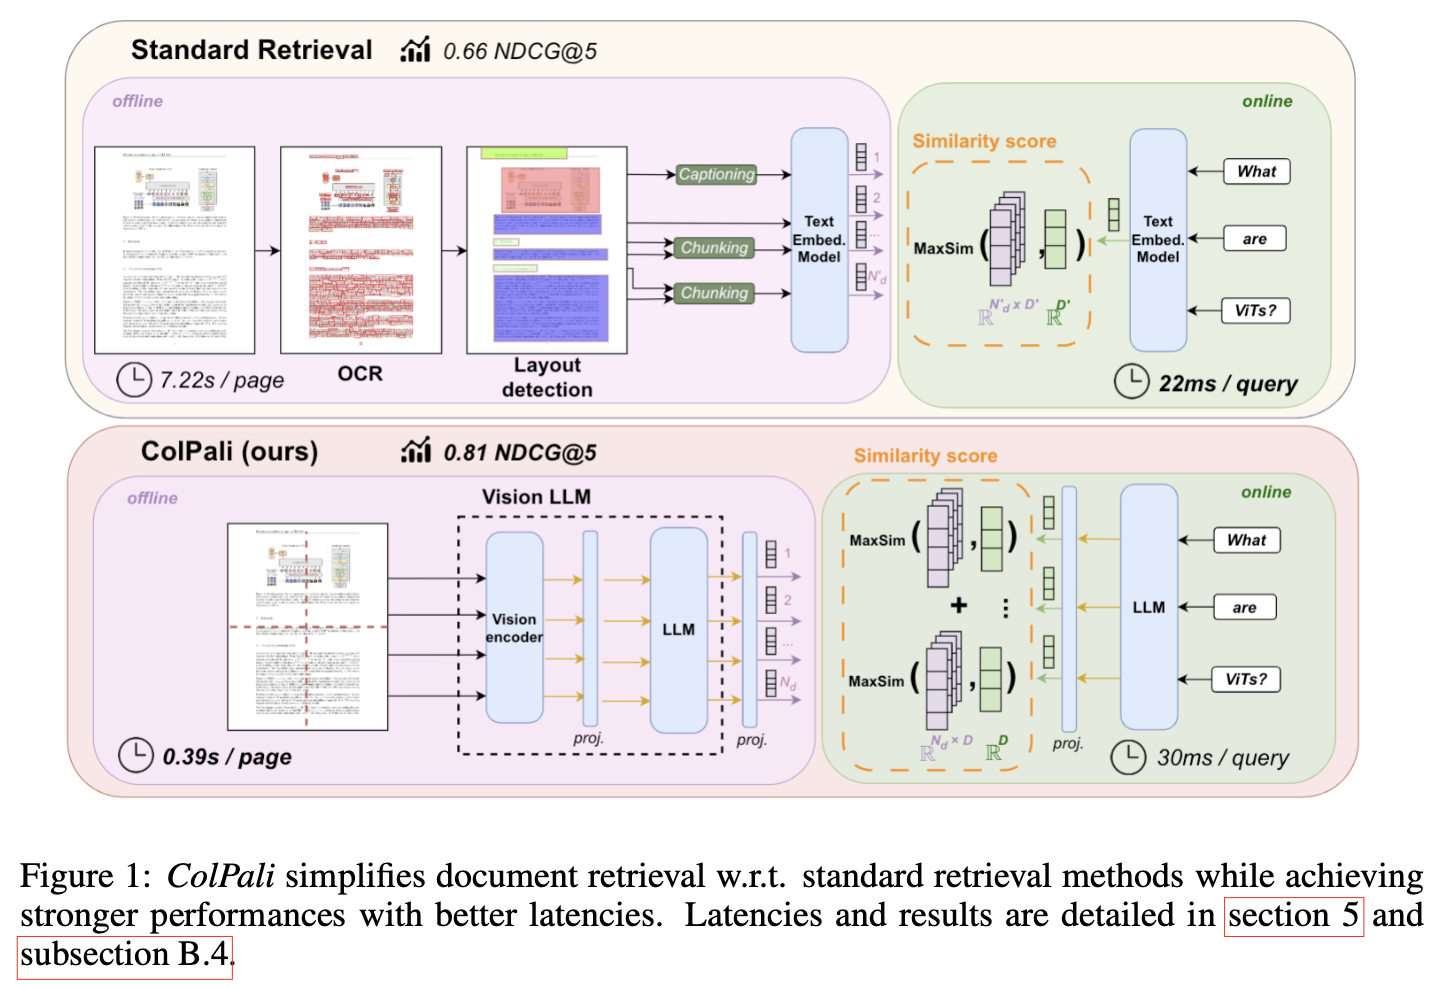 Figure 1: 표준 검색은 OCR·레이아웃 검출·청킹을 거쳐 페이지당 7.22s가 드는 반면(nDCG@5 0.66), ColPali는 페이지 이미지를 VLM으로 바로 임베딩해 0.39s/페이지에 더 높은 0.81을 냄.
앞선 논문들과 이어지는 지점이 둘 있음. 첫째, ColPali가 건너뛴 “파싱 파이프라인”이 바로 MinerU2.5/PaddleOCR-VL이 고도화하는 그 파이프라인임 — 답변 생성용 RAG라면 결국 파싱이 필요하지만, “어느 페이지인가”를 찾는 검색 단계에서는 파싱 없이 시각 공간에서 끝낼 수 있다는 게 이 논문의 주장임. 둘째, 작동 원리가 DocOwl2 리뷰에서 다룬 의미 공간 정렬 그 자체임: 이미지 패치를 LLM에 통과시키면 패치 임베딩이 텍스트(질의) 임베딩과 같은 공간에 정렬되고, 그 덕에 질의 토큰 ↔ 이미지 패치의 직접 매칭(late interaction)이 성립함. 실제로 질의 토큰 “hour”가 페이지 속 “hourly” 글자 패치에 강하게 반응하는 유사도 맵이 그 증거임.
2.3 학습
| 항목 | 내용 |
|---|---|
| 베이스 | PaliGemma-3B (SigLIP 비전 인코더 + Gemma-2B, prefix full attention) + 신규 128차원 사영층 |
| 데이터 | 118,695 질의-페이지 쌍. 학술 train split 63% + 웹 크롤링 PDF에 Claude-3 Sonnet 가짜 질의를 단 합성 37%. 전부 영어(비영어 zero-shot 일반화 검증용) |
| 손실 | in-batch contrastive. positive 점수 vs 배치 내 최난도 negative의 pairwise CE |
| 학습량 | LoRA(r=α=32), 1 epoch, batch 32. 질의에 |
평가 오염 방지를 위해 동일 PDF가 train/test 양쪽에 들어가지 않도록 검증함.
3. 실험 결과
3.1 검색 성능 (R1)
ViDoRe 평균 nDCG@5 기준. 단계적 기여가 깔끔하게 분해됨.
| 모델 | 구성 | Avg nDCG@5 |
|---|---|---|
| Unstructured + OCR (BGE-M3) | 텍스트 파이프라인 + 시각 요소 OCR | 66.1 |
| Unstructured + Captioning (BGE-M3) | + Claude-3 Sonnet 캡셔닝 | 67.0 |
| SigLIP (Vanilla) | contrastive VLM 단일 벡터 | 51.4 |
| BiSigLIP | + 문서 데이터 fine-tuning | 58.6 |
| BiPali | + LLM 통과(단일 벡터 평균) | 58.8 |
| ColPali | + multi-vector late interaction | 81.3 |
성능의 계단이 말해주는 것: 문서 데이터 학습(+7.2), LLM 통과(영어는 소폭 하락이지만 프랑스어 등 다국어에서 개선), 그리고 late interaction이 결정타(+22.5)임. 단일 벡터로는 문서의 정보량을 못 담고, 패치 수준 multi-vector가 필요하다는 증거임. 시각적으로 복잡한 task(인포그래픽·그림·표)에서 격차가 가장 크지만, 텍스트 중심 문서에서도 전부 이김.
3.2 효율 (R2·R3)
| 단계 | 텍스트 파이프라인 | ColPali |
|---|---|---|
| 색인 (페이지당) | 7.22s (레이아웃 0.81 + OCR 2.67 + 캡셔닝 3.71 + 인코딩 0.03) | 0.39s |
| 질의 latency | 22ms (BGE-M3) | 30ms + late interaction ~1ms/1000페이지 |
색인이 18배 빨라짐. 전처리가 사라지고 forward 한 번이라 배칭·FlashAttention 등 LLM 생태계의 효율 개선을 그대로 흡수함. 질의는 소폭 느리지만 실용 범위.
3.3 저장 공간과 token pooling
약점도 정직하게 드러남: 페이지당 257.5KB로 BGE-M3(8.6KB) 대비 30배임. 다만 패치 상당수가 흰 배경 같은 중복 정보라, 계층적 mean pooling으로 벡터 수를 66.7% 줄여도 성능 97.8%가 유지됨(pool factor 3). 예외는 텍스트가 가장 빽빽한 Shift셋 — 정보 밀도가 높을수록 중복 패치가 적어 pooling 손실이 큼. token redundancy 서사가 검색 인덱스에서도 반복되는 장면임.
3.4 Ablation 요지
이 논문도 ablation이 충실함.
- 패치 수 절반(512)이면 −24.8로 급락. 그런데 더 좋은 LM을 쓰면 64패치(ColIdefics2)가 512패치 ColPali를 +20.1로 역전 — 좋은 LM일수록 적은 패치로 효율적 표현이 가능함.
- 더 좋은 VLM = 더 좋은 검색기: Qwen2-VL로 갈아끼운 ColQwen2가 +5.3. 생성 벤치 성능이 검색 성능으로 전이됨.
- 비전 인코더까지 학습하면 오히려 소폭 하락(−0.7).
- 부정 결과의 가치: ColSigLIP(SigLIP에 late interaction)은 처참함. SigLIP 사전학습이 pooled 표현만 최적화해 패치 개별 임베딩의 정렬이 안 돼 있기 때문 — late interaction이 작동하려면 패치 수준 정렬(=LLM 통과)이 전제라는 역증명임.
- 완전 분리 데이터(DocMatix)로만 학습해도 −2.2에 그침 → in-domain 학습 보정 후에도 baseline을 12점 이상 앞섬.
- 도메인 적응 용이성: 프랑스어 표 샘플 1,552개만 추가해도 TabFQuAD +2.6 (Recall@1 +5), 다른 task 손실 없음.
4. 한계 및 비판
1) 저장 비용은 구조적 약점 multi-vector는 본질적으로 비쌈. 페이지당 257.5KB는 수백만 페이지 코퍼스에서 실질 부담이고, pooling·양자화로 두 자릿수 압축이 가능하다지만 그만큼 엔지니어링이 붙음. 단일 벡터의 단순함을 버린 대가임.
2) 질의 생성의 순환 위험 실전 task의 질의를 Claude-3 Sonnet으로 생성함(사람 검수는 거침). 캡셔닝 baseline도 같은 Claude-3 Sonnet을 씀. VLM이 만든 질의는 VLM이 잘 보는 시각 특징에 치우칠 수 있어, 시각 기반 검색기에 유리한 분포일 가능성을 배제 못 함. 학술 task와 사람 검수로 완화되지만, PaddleOCR-VL 리뷰에서 지적한 “자기 생태계 순환”과 같은 계열의 우려임.
3) 페이지 = 문서라는 단순화 page-level retrieval로 문제를 정의함(페이지가 검색의 원자 단위). 실제 RAG에선 여러 페이지에 걸친 근거, 페이지 내 특정 구획 수준의 정밀 검색이 필요할 수 있는데 그건 범위 밖임. 멀티페이지 맥락은 DocOwl2가 다루던 축이고, 두 접근의 결합(시각 검색 + 시각 QA로 end-to-end 비전 RAG)은 future work로만 언급됨.
4) 언어·도메인 커버리지 벤치도 학습도 영어·프랑스어 중심임. 프랑스어 zero-shot 일반화는 되지만(Gemma의 다국어 사전학습 덕), 비라틴 문자·저자원 언어는 미검증임.
5) in-domain 학습 데이터 ViDoRe 학술 task의 train split이 ColPali 학습에 포함됨. 임베딩 모델 관행이고 DocMatix ablation으로 방어했지만, 표의 헤드라인 수치(81.3)에는 in-domain 이득이 섞여 있음을 감안할 것.
5. 결론
1) 핵심 기여는 “Retrieval in Vision Space”의 입증 파싱 파이프라인 없이 페이지 이미지를 multi-vector로 임베딩하고 late interaction으로 매칭하는 것만으로, 최강 텍스트 파이프라인을 14점 이상 앞서면서 색인은 18배 빨라짐. 검색에 관한 한 “문서를 텍스트로 변환해야 한다”는 전제 자체를 무너뜨림.
2) 작동 원리는 패치 수준 의미 정렬 LLM을 통과한 이미지 패치가 질의 텍스트와 같은 의미 공간에 놓이는 것이 전부의 전제임. ColSigLIP의 실패가 역으로 증명하듯, pooled 정렬(CLIP류)이 아니라 토큰/패치 수준 정렬이 late interaction의 필요조건임. DocOwl2의 “V2T 뒤 압축” 논리와 같은 뿌리 — 의미 공간에 올라온 시각 토큰은 텍스트처럼 다룰 수 있다 — 가 검색에서도 관철됨.
3) 문서 AI 지형에서의 위치 같은 token redundancy·전처리 병목을 두고 세 갈래가 갈림: 파싱 진영(MinerU2.5·PaddleOCR-VL)은 변환 자체를 효율화하고, 이해 진영(DocOwl2)은 압축으로 멀티페이지 이해를 열고, 검색 진영(ColPali)은 변환을 생략함. ColPali는 ViDoRe 리더보드를 공개해 이 갈래의 표준 무대까지 만들었고, ColQwen2 결과가 보여주듯 베이스 VLM이 좋아질수록 같이 좋아지는 구조라 수명이 긴 설계임. RAG의 검색 단을 비전 공간으로 옮긴 전환점으로 기록될 논문임.
배경 개념 정리
Bi-encoder vs Cross-encoder vs Late interaction bi-encoder는 질의·문서를 따로 단일 벡터로 인코딩해 코사인 유사도로 매칭함 — 빠르지만 표현이 거칢. cross-encoder는 질의+문서를 붙여 한 모델에 넣어 정밀하지만 문서마다 온라인 인코딩이 필요해 느림. late interaction(ColBERT)은 그 절충임: 문서를 토큰별 벡터로 미리 색인해두고(오프라인), 질의 토큰과의 세밀한 상호작용(MaxSim)은 질의 시점에 가볍게 계산함. 정밀도와 속도를 동시에 가져가는 대신 저장 공간을 냄.
MaxSim과 LI 점수 질의 토큰 하나가 문서의 모든 벡터와 내적을 구해 최댓값만 취하고(MaxSim), 이를 모든 질의 토큰에 대해 합산한 것이 질의-문서 점수임. “질의의 각 단어가 문서 어딘가에서 가장 강하게 반응하는 정도의 총합”으로 읽으면 됨. 완전 미분 가능해 end-to-end 학습이 됨.
PaliGemma / SigLIP SigLIP은 CLIP의 softmax 대비 sigmoid 손실로 배치 확장성을 높인 contrastive 비전-언어 모델. PaliGemma-3B는 SigLIP 인코더의 패치 임베딩을 선형 사영으로 Gemma-2B의 텍스트 공간에 넣는 VLM으로, prefix(이미지+지시문)에 full attention을 거는 Prefix-LM 구조임. 이미지 토큰이 질의를 보며 인코딩될 수 있다는 점이 검색 적합성의 한 요인임.
nDCG@5 상위 5개 검색 결과의 순위 품질 지표. 정답 문서가 더 높은 순위에 있을수록 점수가 크고, 순위 할인(log discount)을 반영해 0~100으로 정규화함. 검색 문헌의 표준 지표임.
Query augmentation 토큰 질의 뒤에 학습 가능한 더미 토큰 몇 개를 붙여, 모델이 질의 확장·재가중에 쓸 여백을 주는 ColBERT 기법. ColPali에선 영어에선 효과가 미미했지만 프랑스어 task에서 유의미한 이득을 보임.
ViT 레지스터 현상 유사도 맵에서 흰 배경 패치가 높은 점수를 받는 경우가 관찰되는데, 이는 정보 없는 패치가 내부 연산용 저장소로 재활용돼 이미지 전역 정보를 담기 때문으로 해석됨(ViT registers). multi-vector 임베딩의 해석 시 유의할 지점임.
부록: late interaction 문답 (2026-07-05)
ColPali의 late interaction(MaxSim)을 두고 주고받은 문답을 정리함. “이런 거지?” 하고 내 이해를 던지면 맞는 부분·틀린 부분을 갈라 교정받고, 그걸로 다음 질문을 좁혀가는 식으로 진행함.
Q1. 이미지를 영역으로 나눠, 영역별 고정 토큰으로 질의와 pairwise 비교하는 건가? 반은 맞음. “영역”은 의미 영역이 아니라 ViT 고정 그리드 패치(패치당 벡터 1개, 페이지당 ~1024개)임. 그리고 “영역별 독립 비교”가 아니라 질의 토큰 × 모든 패치의 전체 쌍을 보고, 각 질의 토큰이 자기 최적 패치를 골라(max) 합산(sum)함 — score = Σ_i max_j (q_i·d_j).
Q2. 질의 토큰에 대응되는 비전 토큰을 가져와서 뭘 하나? 가져오지 않음. max가 뽑는 건 벡터가 아니라 스칼라(최대 내적값) 하나임. 그 값들을 합산 → 페이지 점수 → 랭킹이 전부. 답변이 필요하면 상위 k 페이지 이미지 전체를 별도 생성 VLM에 넣어 답을 만듦(개별 매칭 패치를 넘기는 게 아님). argmax 패치는 유사도 히트맵 같은 해석·시각화에만 쓰임.
Q3. 그럼 질의마다 페이지별 점수가 있고, 그걸 최대화하는 페이지를 찾는 거지? 맞음. 두 층위의 max를 구분하는 게 핵심 — 안쪽 max(패치 단위 MaxSim)로 페이지 점수 1개를 만들고, 바깥쪽 max로 페이지들 중 최고(또는 top-k)를 고름. 문서 패치 벡터는 질의 전에 미리 색인해두므로 질의 시엔 MaxSim만 돌림 → 색인·latency 이점.
Q4. 그냥 질문 벡터 1개 × 문서 벡터 1개 유사도랑 근본적으로 뭐가 다른가? pooling 병목의 유무임. single-vector는 페이지(패치 수백~천 개)와 질의를 각각 벡터 1개로 뭉갬 → 세부가 평균에 섞여 흐려지고 전역 gist만 매칭. late interaction은 조각을 유지해 질의 토큰이 각자 최적 패치를 국소 매칭함(작은 디테일·needle-in-haystack에 강함). 실측: single(BiPali) 58.8 → late interaction(ColPali) 81.3, +22.5가 결정타.
Q5. PaddleOCR처럼 레이아웃 단위로 쪼개 공백 없이 스코어를 내면 리던던시·노이즈가 줄어 성능이 오르지 않나? 목표(리던던시↓)는 ColPali의 최대 약점을 겨눠 타당함. 다만 수단으로는 회의적 — (a) MaxSim의 max가 이미 공백을 안 뽑아 “노이즈↓→성능↑”는 약하고, (b) 레이아웃 영역을 벡터로 pooling하면 국소성을 잃어 single-vector 병목이 부활하며, (c) ColPali가 없애려던 검출기 파이프라인이 부활함(오류전파·시각 리치 콘텐츠 취약). 리던던시는 검출기 없는 패치 풀링/ saliency 드롭이 정석.
Q6. 그래도 공백이 점수를 깎을 수 있지 않나? 내용은 맞는데 공백이 많으면 불리하게. single-vector면 맞음 — mean-pool이 공백까지 평균 내 콘텐츠 신호를 희석함. 하지만 MaxSim은 아님: 합이 질의 토큰에 대해서만 걸리고 문서 길이 |D|로 나누는 정규화가 없어서, 공백 패치를 더해도 콘텐츠 패치의 max값이 안 변해 점수가 불변임. (예: 콘텐츠 동일·공백만 3배인 페이지도 점수 1.79로 동일. single-vector는 0.62→0.41로 하락.) 즉 공백은 점수엔 무해, 저장·연산만 낭비 — Q5의 결론을 오히려 강화함.