Matryoshka Representation Learning
Matryoshka Representation Learning (MRL)
Authors: Aditya Kusupati, Gantavya Bhatt, Aniket Rege, Matthew Wallingford, Aditya Sinha, Vivek Ramanujan, William Howard-Snyder, Kaifeng Chen, Sham Kakade, Prateek Jain, Ali Farhadi (University of Washington, Google Research, Harvard) — arXiv 2205.13147, NeurIPS 2022.
표현학습(representation learning) 논문임. 특정 task용 모델이 아니라, 이미 있는 임베딩 파이프라인 위에 얹는 범용 기법임. 핵심은 “임베딩 하나는 학습 때 정한 고정 차원을 가진다”는 당연한 전제를 깨는 것 — 한 벡터 안에 여러 크기의 표현을 겹겹이(마트료시카) 심어, 앞 m차원만 잘라도 독립 학습한 m차원만큼 정확하게 함. 아키텍처·추론 경로는 그대로 두고 손실 함수만 다중 스케일로 바꾸는 게 전부라 ResNet·ViT·BERT·ALIGN 어디에도 최소 수정으로 붙음. 이후 “차원을 잘라 쓸 수 있는 임베딩(Matryoshka embedding)”이 임베딩 모델의 기본 옵션으로 자리잡은 출발점임.
1. 문제 정의
핵심 문제
하나의 임베딩으로, 다운스트림 task마다 다른 계산·정확도 제약에 맞게 유연하게 대응하는 표현을 학습하는 것이 핵심 문제임.
학습된 표현은 한 번 학습해 얼려두고 여러 task에 재사용됨. 그런데 학습 시점에는 각 task가 요구하는 계산량·정확도를 알 수 없음. 그래서 고정 차원(rigid) 표현은 어떤 task엔 과하고 어떤 task엔 모자람.
논문이 짚는 비용 구조가 문제의 출발점임. 표현의 배포는 두 단계로 나뉨.
- (1) 표현을 뽑는 forward pass — 무겁지만 차원과 무관하게 고정 비용
- (2) 뽑은 표현을 쓰는 다운스트림 활용(분류·검색) — 비용이 차원 d · 데이터 수 N · 라벨 수 L에 선형 비례
웹 스케일에서는 (2)의 활용 비용이 (1)의 featurization 비용을 압도함. 그런데 기존 표현은 경직돼 있어서, task마다 자원·정확도 요구가 다른데도 전부 고차원 벡터를 써야 함. 이 경직성이 대규모 배포의 비효율을 낳음.
기존 연구의 한계
딥러닝 모델은 gradient 학습의 inductive bias 탓에 정보를 벡터 전체에 고르게 퍼뜨리는(diffuse) 경향이 있음. 그래서 앞 몇 차원만 잘라 쓰면 성능이 급락함. 유연성을 얻으려는 기존 시도는 셋인데, 모두 대규모 적응형 배포엔 부적합함.
| 방식 | 내용 | 한계 |
|---|---|---|
| 저차원 모델 다수 학습 | 차원마다 독립 모델을 따로 학습 | 학습·유지 비용, 데이터 전체에 대한 여러 번의 forward pass, 인코딩 복사본 다수 저장 |
| Sub-net 공동 최적화 (slimmable net) | 하나의 큰 망 안에 여러 폭의 sub-net | sub-net마다 가중치가 달라 별도 forward pass 필요 → 검색 DB를 폭마다 재인코딩해야 함 |
| 사후 압축 (SVD, hashing 등) | 고차원 벡터를 학습 후 축소 | 차원을 줄이면 정확도가 크게 떨어짐 |
가장 가까운 선행 연구는 Rippel et al.의 ordered representation(nested dropout, autoencoder 맥락)임. 다만 이건 O(d)개 차원 전부에 nesting을 걸어야 해서 무거움. MRL은 여기서 O(log(d))개 차원만 최적화하는 것으로 차별화함.
정리하면, “하나의 모델·하나의 벡터로, 배포 시점의 자원 제약에 맞춰 차원을 골라 쓰되, 잘라 쓴 저차원이 독립 학습한 저차원만큼 정확한” 표현이 비어 있었음.
2. 제안 방법: MRL
기존 표현학습 파이프라인을 거의 손대지 않고, 손실 함수만 다중 스케일로 바꿔서 정보를 coarse-to-fine로 겹겹이 쌓는 방법임. 추론·배포 시 추가 비용은 없음.
2.1 핵심 아이디어
하나의 고차원 벡터 안에, 앞 m차원이 그 자체로 완결된 표현이 되도록 여러 크기를 중첩(nested)해서 학습한다.
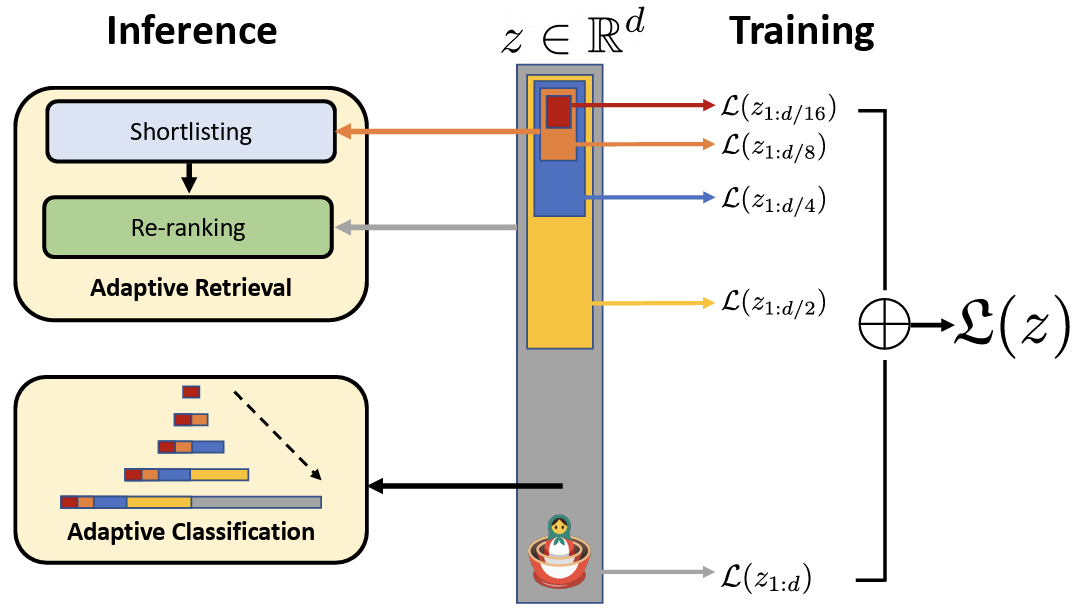
위 그림 오른쪽이 학습임 — 한 벡터 z의 앞 d/16, d/8, d/4, d/2, d 차원 각각에 손실 L(z_{1:m})을 걸고 전부 더해 하나의 손실로 학습함. 왼쪽이 추론 활용임 — 그렇게 학습한 중첩 표현을 저차원으로 후보를 추리고 고차원으로 재정렬하는 Adaptive Retrieval, 쉬운 샘플은 저차원에서 끝내는 Adaptive Classification으로 씀.
마트료시카 인형처럼, 벡터 z ∈ R^d의 첫 m차원 z_{1:m}이 독립적으로 학습한 m차원 표현만큼 정확한 정보-농축 벡터가 되게 함. 차원이 커질수록 정보가 coarse→fine으로 쌓임. 추가 학습 비용은 사실상 없음.
2.2 형식화
| d에 대해 표현 크기 집합 M ⊂ [d]를 정함( | M | ≤ ⌊log(d)⌋, 보통 8→16→…→2048처럼 반씩 키움). 심층망 F(·; θ)가 z = F(x)를 뽑고, 각 m마다 별도 선형 분류기 W^(m) ∈ R^{L×m}로 앞 m차원만 써서 분류함. 전체 손실은 각 스케일 손실을 상대 중요도 c_m으로 가중해 더함. |
L = Σ_{m∈M} c_m · CE( W^(m) · F(x)_{1:m} , y ) — 기본값 c_m = 1
핵심 성질: O(log(d))개 차원만 명시적으로 최적화하는데도, 학습하지 않은 중간 차원들로 정보가 interpolate돼서 사실상 모든 m ∈ [8, 2048]에서 쓸 만한 표현이 나옴.
MRL–E (Efficient): 분류기들을 weight-tying해 W^(m) = W_{1:m}으로 공유함(공통 W ∈ R^{L×d}). 분류기 메모리가 거의 절반으로 줌 → 라벨 수 L이 극단적으로 큰(extreme classification) 상황에서 유리. 대신 최저 차원에서 약간 손해를 봄.
2.3 프레임워크 이식
MRL은 대부분의 표현학습 세팅에 최소 수정으로 얹힘. 저자들의 코드는 FFCV 파이프라인의 fc 레이어를 MRL_Linear_Layer로 바꾸는 정도임.
| 세팅 | 이식 방법 |
|---|---|
| 지도학습(비전) | ResNet50/ViT의 최종 선형층을 다중 헤드로 교체 |
| MLM(BERT) | 입력 임베딩 행렬과 분류기가 weight-tying → 자동으로 MRL–E가 됨 |
| Contrastive(비전 / 비전+언어) | 대조되는 양쪽 임베딩 모두에 MRL 적용 |
정규화(normalization)는 각 nesting 차원마다 독립으로 처리해야 최상 성능이 나옴.
3. 실험 결과
세팅: ResNet50 on ImageNet-1K (2048-dim, M={8,…,2048}), ViT-B/16 on JFT-300M & ALIGN (768-dim, M={12,…,768}), BERT MLM on Wikipedia+BooksCorpus. 하이퍼파라미터는 독립 학습 baseline과 동일하게 두고 별도 탐색 안 함. baseline은 FF(차원별 독립 학습), SVD, slimmable net, 랜덤 선택 특징(Rand.), JL 사영 등.
3.1 분류 (ImageNet-1K, ResNet50)
| Rep. Size | FF | Slim. Net | SVD | MRL | MRL–E |
|---|---|---|---|---|---|
| 8 | 65.29 | 0.42 | 2.34 | 66.63 | 56.66 |
| 16 | 72.85 | 0.96 | 7.17 | 73.53 | 71.94 |
| 128 | 75.29 | 14.15 | 67.24 | 76.30 | 75.80 |
| 2048 | 76.87 | 76.26 | – | 76.80 | 76.51 |
(Top-1 %, Table 1 발췌.) 읽는 법: ① MRL은 모든 차원에서 FF 이상임 — 차원마다 모델을 따로 학습할 필요가 사라짐. ② SVD·slimmable 같은 사후/서브넷 방식은 저차원에서 처참하게 무너짐(SVD 8-dim 2.34, slimmable 8-dim 0.42) → 저차원 표현은 명시적으로 학습해야만 산다. ③ 1-NN 지표에서는 MRL이 저차원에서 FF 대비 최대 2%p 더 정확함(표현 품질 자체가 좋다는 신호). ④ 학습 안 한 중간 차원도 interpolate돼 매끄럽게 이어짐.
웹 스케일(JFT-ViT, ALIGN)에서도 동일 경향. ALIGN-MRL은 거의 모든 차원에서 원본 ALIGN보다 분류 정확도가 높았고, 저차원일수록 격차가 컸음. BERT MLM도 FF 대비 검증 정확도 0.5%p 이내로, 언어 모달로도 확장 가능함을 확인.
3.2 Adaptive Classification (MRL–AC)
confidence(최대 softmax) 임계값을 검증셋에서 학습해, 낮으면 다음 차원으로 넘어가는 cascade. 이 논문의 대표 헤드라인임.
- 76.30% 정확도를 기대 차원 ~37로 달성 → 512-dim FF와 동급, 2048-dim FF 대비 0.8%p 낮음
- 같은 정확도 기준 최대 14× 작은 표현 크기
3.3 검색 (ImageNet-1K / 신설 ImageNet-4K)
- mAP@10: MRL이 대부분 최고, FF 대비 최대 3%p 우위. 사후 압축·slimmable은 ≤256차원에서 급락
- Adaptive Retrieval(AR): 저차원 Ds로 후보를 shortlist → 고차원 Dr로 re-rank. ImageNet-1K에서 Ds=16 & Dr=2048이 단일 2048-dim 검색과 동급 정확도이면서 이론 128×, 실측(HNSW) 14× 빠름. ImageNet-4K는 난도가 높아 Ds=64가 필요 → 이론 32×, 실측 6×
- Funnel Retrieval: shortlist를 반씩 줄이고 차원을 두 배씩 키우는 일관 cascade. Ds/Dr 수동 선택 부담을 없애면서 단일 2048 대비 0.1%p 이내 정확도, 128× 적은 FLOPs
3.4 추가 분석
- 강건성: OOD(ImageNet-V2/R/A/Sketch)에서 FF 이상. ImageNet-A는 오히려 +0.6%p(상대 20%↑). 검색 강건성도 최대 +3%p mAP@10
- Long-tail (FLUID): 꼬리(novel-tail) 클래스에서 최대 2%p 우위(64-dim MRL 6.22% vs 2048-dim 12.88%로 고차원이 필요, 반면 pretrain-head는 84.46 vs 85.60로 차이 미미) → task 난도에 따라 필요 차원이 다르다는 증거
- 차원 간 불일치: 정확도가 차원에 따라 단조 증가하지 않는 인스턴스가 존재. 완벽 라우팅(oracle) 시 최대 +4.6%p. 저차원은 같은 superclass 내 혼동이나 다물체 장면에서 헷갈림(Grad-CAM: 비닐봉지↔샤워캡, 록파이썬↔보아 등)
- Superclass: 저차원에서 fine-grained 정확도는 급락하지만 superclass 수준 정확도는 완만하게만 떨어짐 → 좁은 병목이 계층(hierarchy)의 coarse 의미는 보존함
3.5 Ablation
- 사전학습 FF 모델에 부분 finetuning으로도 nesting을 어느 정도 유도 가능(단, 선형층만으론 부족하고 conv를 풀어야 함; d=8이 5%→60%, end-to-end 대비 6%p 아래)
- 손실 가중 c_m 튜닝으로 저차원 부스트 가능(MRL-8boost: d=8에서 +3%p, 고차원은 최대 0.1%p만 손해)
- 로그 간격 > 균일 간격: 저차원 정보 packing이 더 촘촘하고, 비용도 O(L·2log d) vs O(L·m²)로 유리
- 초기 차원 8이 경험적 최적(4·6은 저차원이 사실상 못 쓸 수준 + 고차원 소폭 하락)
4. 한계 및 비판
논문이 인정한 부분과 더 따져볼 지점을 함께 정리함.
1) 헤드라인 “14×·128×”는 최상 조건의 조합임 “14× 작다”는 고정 크기가 아니라 임계값 cascade + test-time augmentation으로 얻은 기대(평균) 차원 ~37임. 누적합 방식으로 세면 기대 차원이 62(≈8.2×)로 떨어짐. “128×”는 이론 FLOPs이고 실측은 14×로, 이론과 실제의 간극이 큼. 깔끔한 “벡터 하나 자르면 끝”이라는 서사 뒤에 임계값 학습·TTA·funnel 스케줄 같은 부수 장치가 붙는다는 점을 감안해야 함.
2) featurization 비용은 그대로 MRL이 줄이는 건 (2) 활용/검색 비용이지 (1) forward pass 비용이 아님. 표현을 뽑는 순간은 여전히 full-d를 통과함. 에지에서 추론 자체가 무거운 상황엔 직접적 이득이 제한적임.
3) MRL vs MRL–E 트레이드오프 별도 분류기(MRL)는 저차원 정확도가 좋지만 8MB 저장 오버헤드가 있고, weight-tying(MRL–E)은 오버헤드 0이지만 최저 차원(특히 d=8)에서 눈에 띄게 손해를 봄. “둘 다 공짜”는 아님.
4) interpolation은 경험적 관찰 학습 안 한 중간 차원이 매끄럽게 이어지는 건 실험으로 보였을 뿐 이론적 보장이 없음. diffusion inductive bias에 기댄 현상이라, 다른 아키텍처·손실에서 항상 성립한다고 단정하기 어려움.
5) baseline의 비대칭 저차원에서 극적으로 무너지는 SVD·slimmable·랜덤과 비교하면 MRL이 압도적으로 보이지만, 이들은 애초에 저차원용으로 학습된 게 아님. 진짜 공정한 상대는 차원별 독립 학습 FF인데, 여기서 MRL은 “동급 정확도 + 모델 하나”라는 실용적 승리를 냄 — 정확도 자체의 대폭 상승은 아님(핵심은 |M|개 모델을 1개로 압축).
6) error bar 부재(저자 인정) ImageNet-1K/JFT-300M/ALIGN 규모라 여러 seed 반복이 너무 비싸 표준편차를 못 냄. 소수점 단위 우열은 조심해서 읽어야 함.
저자들이 남긴 future work도 이 한계들과 맞닿음: 중첩 손실 가중의 Pareto 최적화, 차원별로 목적을 달리하는 손실(8-dim은 recall, 2048-dim은 robustness), MRL 위에 미분가능 k-d tree 같은 검색 구조를 얹어 데이터·표현 인식형 검색을 학습하는 것.
5. 결론
1) 핵심 기여 — “하나의 벡터에 여러 크기를 겹쳐 담는다” 손실만 다중 스케일로 바꾸는 최소 수정으로, 앞 m차원이 독립 학습 저차원만큼 정확한 coarse-to-fine 표현을 얻음. 추론·배포 추가 비용 0. 차원별로 |M|개 모델을 학습·저장·전환하던 부담을 모델 하나로 접음. ResNet·ViT·ALIGN·BERT까지 모달 불문으로 붙는다는 걸 보임.
2) 설계 핵심 — 저차원은 “명시적으로 학습”해야 산다 사후 압축·서브넷·랜덤은 저차원에서 무너지지만, 손실에 저차원 항을 직접 넣으면 정보가 앞쪽으로 packing됨. 로그 간격 nesting이 이 packing을 촘촘하게 하고, O(log d)만 최적화해도 중간 차원이 interpolate돼 실용성을 확보함.
3) 선행 연구 대비 — nested representation의 실용화 가장 가까운 선행인 nested dropout(Rippel et al. 2014)은 O(d)개 차원 전부에 nesting을 걸었지만, MRL은 O(log d)개만 명시적으로 최적화하고도 중간 차원을 interpolate로 메워 웹 스케일에서 실용화함. 또한 MRL은 기존 효율화 기법을 대체하는 게 아니라 상보적임 — HNSW 같은 ANNS 인덱싱이나 PQ 같은 벡터 양자화와 함께 걸면 효율-정확도 트레이드오프를 더 밀어붙일 수 있음.
배경 개념 정리
Fixed-feature(FF) 모델 각 표현 크기(8, 16, …, 2048)마다 따로 처음부터 학습한 독립 모델. MRL이 넘어야 할 “정확도 상한”이자 가장 공정한 비교 대상. 문제는 |M|개 모델을 다 학습·저장해야 한다는 점.
Slimmable Network 하나의 망 안에 여러 폭(25/50/75/100%)을 공유해 두는 sub-net 방식. 폭마다 가중치가 달라 표현을 뽑으려면 별도 forward pass가 필요하고, 검색 DB를 폭마다 재인코딩해야 해서 적응형 배포엔 불리함.
1-NN accuracy를 표현 품질 지표로 쓰는 이유 1-최근접이웃 분류는 학습이 필요 없어(추가 학습 비용 0) 표현 자체의 다운스트림 유용성을 값싸게 재는 프록시가 됨. 선형 분류(LP)와 함께 봄.
Adaptive Retrieval / Funnel Retrieval 저차원 Ds로 후보군을 추리고(shortlist) 고차원 Dr로 재정렬(re-rank)하는 2단 검색이 AR. Funnel은 이걸 여러 단으로 확장해 shortlist를 반씩 줄이고 차원을 두 배씩 키우는 일관 cascade로, Ds/Dr 수동 선택 부담을 덜어줌.
정보 diffusion vs packing 딥러닝 모델은 gradient 학습 편향으로 정보를 벡터 전체에 퍼뜨림(diffuse) → 앞 몇 차원만 자르면 성능 급락. MRL은 손실에 저차원 항을 넣어 정보를 앞쪽에 몰아넣게(packing) 강제함. 이게 “자를 수 있는 임베딩”의 본질.
Oracle accuracy 어떤 차원에서든 한 번이라도 맞히면 정답으로 치는 상한. ImageNet-1K에서 18.46%는 모든 차원에서 틀렸고, 나머지 81.54%가 oracle. 완벽 라우팅이 있다면 얻을 수 있는 이론적 천장으로, 차원별 라우팅 연구의 동기를 줌.