MOCR
Multimodal OCR: Parse Anything from Documents
Authors: Handong Zheng, Yumeng Li, Kaile Zhang, Liang Xin … Yuliang Liu, Xiang Bai (Huazhong University of Science and Technology, Xiaohongshu hi lab) — arXiv 2603.13032, 2026년 3월. 모델명 dots.mocr.
문서 파싱(parsing) 논문이며, 지금까지 본 파싱 진영(MinerU2.5·PaddleOCR-VL·dots.ocr·MonkeyOCR)의 가장 최신·가장 급진적인 확장임. 앞선 파서들이 “텍스트는 마크다운으로 변환하고, 그림은 잘라서 픽셀 크롭으로 버리는” 텍스트 중심 파싱이었다면, MOCR는 그림(차트·다이어그램·아이콘·UI)까지 1급 파싱 대상으로 끌어올려 렌더링 가능한 코드(SVG)로 복원함. 저자가 OCRBench의 Yuliang Liu·Xiang Bai라는 점이 상징적임 — OCRBench가 “LMM은 글자를 의미로 추측하고, 그래픽/해상도/구조에서 무너진다”고 진단한 그 팀이, 이번엔 그래픽을 통째로 코드로 복원하는 처방을 내놓음. 계보로 보면 Donut의 “OCR-free 생성형 구조화 출력”(JSON) → MinerU/PaddleOCR의 “Markdown 생성” → MOCR의 “Markdown + SVG 코드 생성” 으로 출력 공간이 확장된 셈이고, 동시에 “문서를 image-to-code 코퍼스로 바꿔 멀티모달 사전학습 데이터를 캔다”는 데이터 엔진 관점을 전면에 내세움. LayoutLMv3가 깔았던 “이미지를 텍스트처럼 다룬다”가, 여기선 이미지를 말 그대로 텍스트(코드)로 바꾼다로 극단화됨.
1. 문제 정의
핵심 문제
문서에서 텍스트뿐 아니라 그래픽까지 구조화된 표현으로 복원하는 것이 핵심 문제임.
LLM·VLM 시대에 문서 파싱은 사전학습·검색의 핵심 데이터 엔진임 — PDF·스캔·스크린샷에 담긴 방대한 지식에서 얼마나 믿을 만한 구조적 supervision을 회수하느냐가 파싱 품질에 달려 있음. 그런데 문서는 텍스트만이 아니라 차트·다이어그램·플로차트·UI·과학 삽화 같은 그래픽으로도 정보를 전달함.
기존 연구의 한계
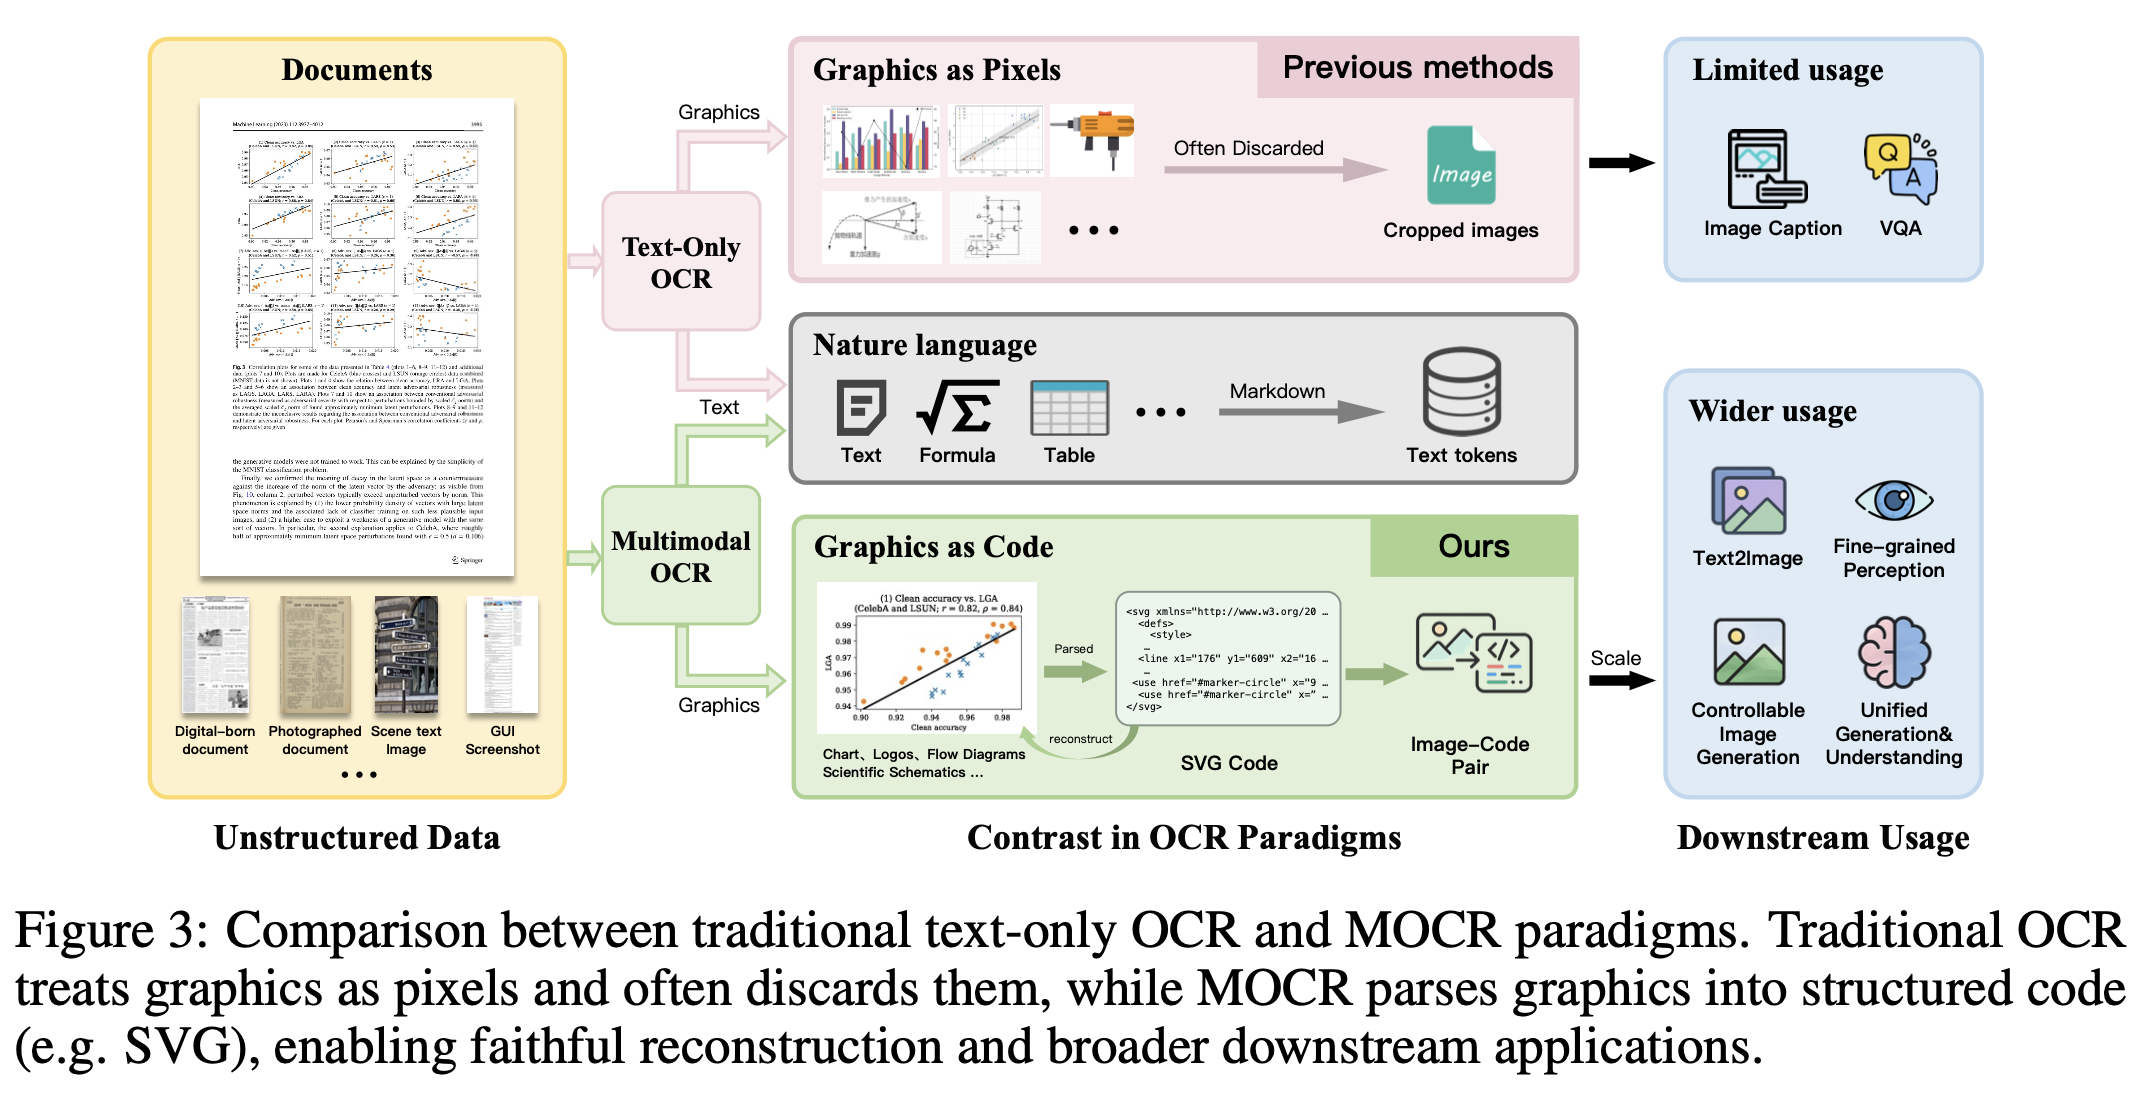
위 그림이 두 패러다임의 차이를 보여줌. 전통적 OCR(위)은 그래픽을 픽셀로 보고 잘라낸 크롭으로 버려 downstream이 캡션·VQA에 그치는 반면, MOCR(아래)는 그래픽을 SVG 코드로 파싱해 충실한 복원과 더 넓은 downstream(통제 가능한 이미지 생성, 통합 이해)을 가능케 함.
1) 텍스트 중심 파싱의 손실성(lossy) 기존 파서(pp-StructureV3, MonkeyOCR, MinerU2.5, PaddleOCR-VL, dots.ocr, GOT-OCR, DeepSeek-OCR 등)는 텍스트 인식·정렬에 집중하고, 비텍스트 요소는 그냥 잘라낸 픽셀 크롭(raster crop)으로 처리함. 그 결과 그래픽에 담긴 구조·의미 정보가 통째로 버려짐. 현재 문서 파싱이 본질적으로 손실적이고, 문서에서 뽑을 수 있는 supervision 양을 스스로 제한한다는 게 미해결 과제임.
2) 파이프라인 분류와 그 한계 파싱을 세 갈래로 정리함: ① 다단계 파이프라인(레이아웃→검출→인식→읽기순서; 단계 간 오류 누적), ② VLM 보강 하이브리드(MonkeyOCR·MinerU2.5·PaddleOCR-VL; 여전히 텍스트 중심·파이프라인 복잡성 상속), ③ end-to-end VLM(DeepSeek-OCR·GOT-OCR·OCRVerse; 일반화는 좋지만 빽빽한 표·수식 구조 유지가 약함). 공통적으로 그래픽을 구조로 복원하지 못함.
3) 그래픽 파싱을 어렵게 만드는 세 가지 VLM이 이미지→코드(SVG·HTML·Python) 변환을 점점 잘하게 됐지만, 이를 문서 파싱으로 확장해 스케일하려면 세 난점이 있음: ① supervision 희소 — 실제 문서엔 그래픽의 정렬된 프로그램 표현이 거의 없음. ② 프로그램의 비유일성(non-unique) — 같은 그림을 내는 코드가 여럿이라 정규화·품질관리가 필요. ③ 정밀 시각 grounding + 장문 구조 생성이 동시에 필요해 텍스트 OCR보다 훨씬 어려움.
2. 제안 방법: MOCR / dots.mocr
텍스트·표·수식은 기존처럼 기호로 옮기되, 차트·아이콘·UI 같은 정보밀집 그래픽을 렌더링 가능한 SVG 코드로 복원하는 통합 파싱 패러다임. 이를 3B 컴팩트 모델 하나로 실현함.
2.1 핵심 아이디어
그래픽을 버려진 픽셀이 아니라 “재사용 가능한 렌더링 코드”로 파싱해, 문서를 image-to-code 코퍼스로 바꾼다.
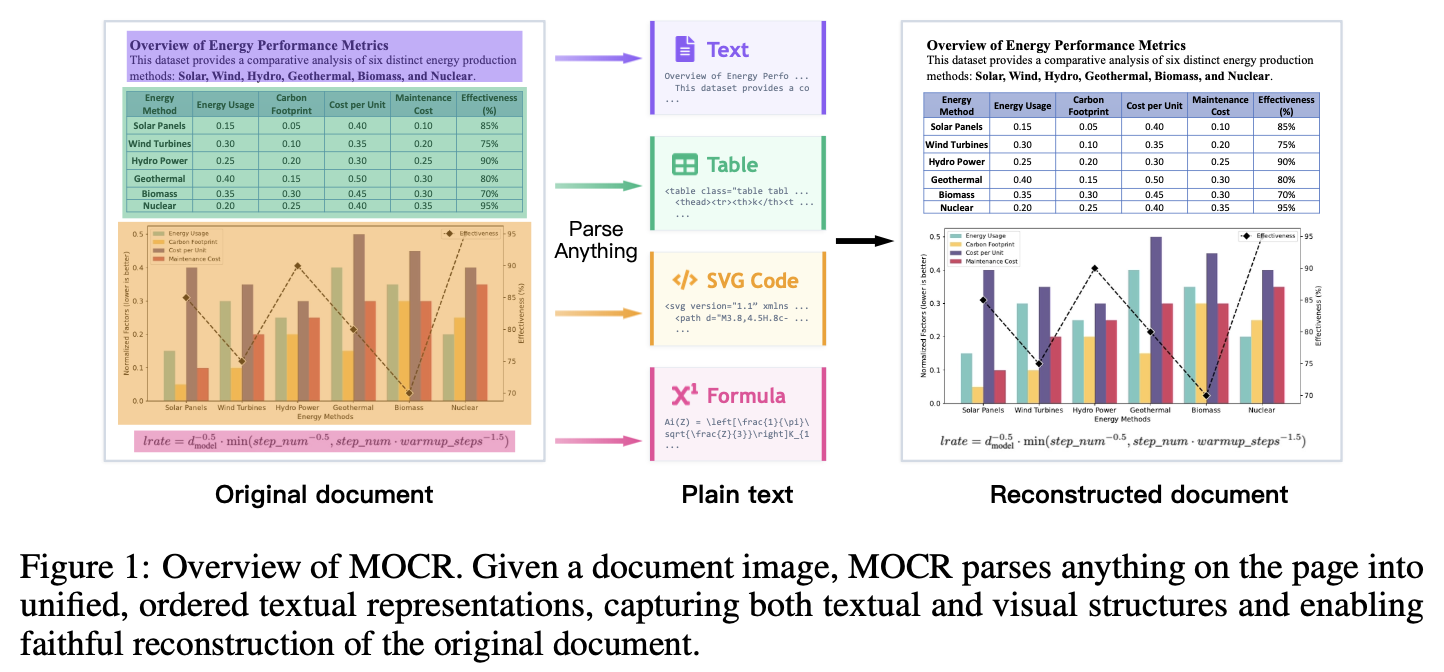
위 그림처럼, 한 문서 이미지를 텍스트·표·SVG 코드·수식이라는 통합된 구조 표현으로 파싱하면, 텍스트·시각 구조를 모두 잡아 원본을 충실히 재구성할 수 있음.
기존 OCR이 텍스트만 회수하고 그림은 크롭으로 남겼다면, MOCR는 텍스트와 시각 요소를 모두 1급 파싱 대상으로 보고 구조화 출력으로 변환함. 특히 그래픽을 SVG 코드 + 텍스트로 표현해, “render-and-reuse”(렌더해서 재사용) 워크플로를 가능케 함. 이렇게 하면 한 문서가 텍스트 토큰뿐 아니라 세밀하고 통제 가능한 구조 supervision까지 공급하게 됨.
계보 연결이 촘촘함. 첫째, Donut→MinerU2.5/PaddleOCR-VL로 이어진 생성형 OCR-free 파싱의 출력 공간을 한 단계 넓힘 — JSON·Markdown을 넘어 실행 가능한 그래픽 코드(SVG) 까지 생성 목표에 넣음. 둘째, OCRBench(같은 저자)가 진단한 “LMM은 의미로 추측하고 그래픽·구조에서 무너진다”는 약점을, 그래픽을 코드로 강제 복원해 정면 공략함. 셋째, “문서 = 사전학습 데이터 엔진”이라는 프레이밍은 ColPali·DocOwl2가 공유하던 “문서에서 어떻게 더 많은 신호를 캐느냐”의 파싱 진영 버전임. LayoutLMv3의 “이미지를 텍스트처럼 다룬다”가, 여기선 이미지를 SVG라는 실제 텍스트로 변환한다로 극단화됨.
2.2 task 정의
입력 이미지 I에 대해 순서 있는 파싱 요소 시퀀스 S = {(B_k, c_k, p_k)}를 생성함. B_k는 영역/bbox, c_k는 의미 범주, p_k는 payload(범주별 직렬화). 사람 중심 읽기 순서로 생성해, 구조 계층·논리 관계를 외부 relation 모듈 없이 생성 순서와 구분자(delimiter)로 암묵 인코딩함.
- 텍스트 중심 영역(텍스트 줄/블록, 표, 수식): payload = 전사(plain text / table markup / LaTeX).
- 시각 기호(UI·아이콘·차트): payload = 렌더링 가능한 SVG 코드(image-to-SVG).
- 간결한 프로그램 기술이 불가능한 복잡 실사진/자연 이미지: 그냥 raster로 보존(코드화 안 함).
한 가지 솔직한 단서: 현 버전은 task-conditioned라, 전면 문서 파싱과 시각기호(SVG) 파싱을 한 번에(one-pass) 내놓지 못함. 페이지 텍스트 파싱과 영역별 image-to-SVG 디코딩을 별도 패스로 돌려 합침. “Parse Anything”은 아직 개념적 통일이고, 실행은 2패스임.
2.3 아키텍처 (dots.ocr 설계 계승)
| 구성요소 | 내용 |
|---|---|
| 고해상도 비전 인코더 | 1.2B, 완전 from-scratch 학습. 네이티브 고해상도 ~11M 픽셀까지 입력. 작은 글자·빽빽한 레이아웃 가독성뿐 아니라 차트 마커·다이어그램 획 같은 그래픽 프리미티브의 정밀 위치 인식에 필수 |
| 멀티모달 커넥터 | 경량 |
| 구조화 언어 디코더 | Qwen2.5-1.5B(base, chat 아님). 1.5B 미만이면 이질적 페이지 내용 + 장문 SVG 구조 생성을 한 번의 디코딩에 못 담고, 너무 크면 비용↑. base에서 출발해야 비자연·강구조 시퀀스 학습에 중립적 |
총 ~3B. 인코더를 처음부터 학습해 문서 파싱에 네이티브 최적화한 것이 특징.
2.4 학습 레시피와 데이터 엔진
3단계 사전학습: ① 일반 비전 학습으로 안정적 vision-language 인터페이스 확보 → ② 일반 비전 + 텍스트 문서 파싱 혼합으로 텍스트 중심 파싱 토대 + 시각 견고성 → ③ 일반 비전 비중↓·멀티모달 문서 파싱(특히 image-to-SVG)↑로 전환. 전 단계에서 단일 autoregressive 목적(이미지+지시 조건부 구조 시퀀스 예측) 유지, 해상도를 단계적으로 상향. 이후 고품질 SFT(검증·정제). 두 체크포인트 공개: dots.mocr(기본)와 dots.mocr-svg(SFT에서 SVG 비중·난도 상향).
데이터 엔진(4 소스):
- PDF: dots.ocr를 자동 라벨러로 써서 다국어 파싱 supervision 생성. 언어/도메인/레이아웃 복잡도 층화 샘플링으로 어려운 구간 강조. SFT엔 규칙 sanity + 렌더 기반 비교 검증 + distillation.
- 웹페이지: 크롤·렌더해 PDF와 같은 MOCR 형식으로. HTML/DOM 정렬 신호로 라벨 노이즈↓, SVG 네이티브 아이콘·차트 풍부.
- SVG 그래픽: 네이티브 SVG 수집 → 렌더해 image–SVG 쌍 구성. svgo로 정규화(메타 제거·수치 정밀도·구조 표준화) + 코드/이미지 중복 제거(텍스트 매칭 + pHash). 도메인 균형 + 복잡도 인지 샘플링.
- 일반 데이터: grounding·counting 등으로 범용 능력 보존.
2.5 평가 틀: OCR Arena (LLM-as-a-Judge + Elo)
WER·NED·TEDS·CDM 같은 규칙 기반 지표는 의미상 같지만 표기가 다른 직렬화에 취약해, 복잡한 Markdown OCR의 실질 품질을 못 잡음. 그래서 Gemini 3 Flash를 심판으로, 원본 이미지 + 두 모델의 Markdown을 보고 우열을 판정하는 페어 비교를 도입. 위치 편향 제거를 위해 A·B 순서를 뒤집어 2회 시행, 두 번 일치할 때만 승리 인정(불일치는 무승부). 결과를 Elo(K=32)로 집계하고, 배틀 순서 영향을 줄이려 1,000회 부트스트랩 평균을 보고.
3. 실험 결과
문서 파싱과 구조화 그래픽 파싱 두 축으로 평가.
3.1 문서 파싱 — Elo (Gemini 3 Flash 심판)
| 모델 | olmOCR-Bench | OmniDocBench1.5 | XDocParse | 평균 |
|---|---|---|---|---|
| Gemini 3 Pro | 1180.4 | 1128.0 | 1323.7 | 1210.7 |
| dots.mocr | 1104.4 | 1059.0 | 1210.7 | 1124.7 |
| dots.ocr | 1041.1 | 1027.2 | 1190.3 | 1086.2 |
| HunyuanOCR | 997.6 | 1003.9 | 951.1 | 984.2 |
| PaddleOCR-VL-1.5 | 897.3 | 997.9 | 866.4 | 920.5 |
| MonkeyOCR-pro-3B | 895.0 | 811.3 | 637.1 | 781.1 |
세 벤치 모두에서 오픈소스 중 1위, 전체로는 Gemini 3 Pro에만 뒤짐.
3.2 olmOCR-Bench 세부 (Overall)
| 모델 | Overall |
|---|---|
| MinerU 2.5.4 | 75.2 |
| dots.ocr | 79.1 |
| PaddleOCR-VL | 80.0 |
| olmOCR v0.4.0 | 82.4 |
| Infinity-Parser 7B | 82.5 |
| dots.mocr | 83.9 (신규 SOTA) |
ArXiv(85.9)·Old scans math(85.5)·Tables(90.7)·Multi column(85.3)에서 최고. 단 Old scans·Headers&footers·Long tiny text·Base에서는 타 모델이 앞서 남은 여지를 인정.
3.3 구조화 그래픽 파싱 — ISVGEN 재구성 점수(렌더 후 원본과 비교, 높을수록 좋음)
| 모델 | UniSVG | ChartMimic | Design2Code | GenExam | SciGen | ChemDraw |
|---|---|---|---|---|---|---|
| OCRVerse | 0.763 | 0.799 | – | – | – | 0.881 |
| Gemini 3 Pro | 0.735 | 0.788 | 0.760 | 0.756 | 0.783 | 0.839 |
| dots.mocr | 0.894 | 0.772 | 0.801 | 0.664 | 0.660 | 0.790 |
| dots.mocr-svg | 0.902 | 0.905 | 0.834 | 0.800 | 0.797 | 0.901 |
dots.mocr-svg가 전 데이터셋 최고. UniSVG에서 OCRVerse를 +0.139(0.902 vs 0.763) 앞서고, 모든 다운스트림에서 Gemini 3 Pro를 능가. 구조 민감 task(ChartMimic·ChemDraw)에서 격차가 특히 큼. 다만 base dots.mocr는 GenExam(0.664)·SciGen(0.660)에서 약해, 3B 예산 안에서 문서 파싱 집중 ↔ 그래픽 집중의 trade-off가 드러남(그래서 -svg를 따로 둠).
3.4 범용 VQA·부록
- 일반 능력(Table 5): Qwen3-VL-2B/4B 대비 경쟁력. CharXiv(서술 77.4·추론 55.3)에서 우세, OCRBench 86.0 유지 — 파싱 특화가 범용 능력을 깎지 않음을 보임.
- OmniDocBench v1.5 편집 지표(부록, 낮을수록 좋음): dots.mocr TextEdit 0.031 / ReadOrderEdit 0.029로 표 내 최고. PaddleOCR-VL(0.035/0.043)·MinerU2.5(0.047/0.044)·dots.ocr(0.048/0.053)를 앞섬(단 dots.mocr 3B vs PaddleOCR-VL 0.9B). dots.ocr 대비 수식 페이지에서 개선.
4. 한계 및 비판
1) “Parse Anything”은 아직 2패스 — 통일은 개념적 제목과 달리, 전면 문서 파싱과 SVG 파싱을 한 번에 못 내놓고 별도 패스로 돌려 합침(저자 명시). 진정한 단일 출력의 통합 파싱은 미완이고, 두 패스의 좌표·요소 정합을 어떻게 안정적으로 잇는지는 충분히 다뤄지지 않음.
2) 자기 생태계 순환 — 심판·라벨러·경쟁자가 한 집안 평가 핵심인 OCR Arena의 심판이 Gemini 3 Flash인데, 리더보드 1위가 Gemini 3 Pro(같은 모델 패밀리)임 — 심판과 최상위 경쟁자가 같은 생태계라 편향 가능성을 배제하기 어려움. 게다가 PDF supervision을 자사 이전 모델 dots.ocr로 자동 라벨링해 학습함 — 자기 distillation 성격이라, dots.ocr의 오류·편향이 dots.mocr로 상속될 수 있음. ColPali·PaddleOCR-VL 리뷰에서 짚은 “자기 생태계 순환” 우려가 여기선 심판·라벨러 양쪽에 걸림.
3) ISVGEN은 “보이면 맞다” 지표 — 코드 정확성 보장 안 됨 그래픽 평가가 렌더 후 원본 이미지와의 시각 일치도(ISVGEN)임. 시각적으로 비슷하면 점수가 높으므로, 구조·의미가 틀려도 픽셀이 닮으면 후하게 매겨질 수 있음. 프로그램의 비유일성을 정규화로 다룬다지만, 평가 지표 자체가 코드의 의미적 정합성을 직접 재지는 못함.
4) “Parse Anything”의 경계 — 가장 정보밀집한 실사진은 못 코드화 간결한 프로그램 기술이 안 되는 복잡 사진·자연 이미지는 raster로 남김. 즉 정보가 가장 풍부한 실세계 이미지가 정확히 코드화 대상에서 빠짐 — “anything”엔 분명한 한계선이 있음.
5) 그래픽 ↔ 문서 파싱의 예산 trade-off 3B 한 모델로 둘을 다 잘하긴 어려워 dots.mocr / dots.mocr-svg를 분리함. 즉 “통합 모델”이 실제로는 강조점이 다른 두 체크포인트로 갈림. base는 GenExam·SciGen에서 약하고, olmOCR-Bench의 Old scans·tiny text·헤더/푸터에선 타 모델에 밀림.
6) 해상도·장문 생성 비용 네이티브 ~11M 픽셀 입력 + 장문 SVG 프로그램 생성은 디코딩 부담이 큼 — OCRBench가 진단한 “고해상도=성능 ↔ 토큰 폭증”의 긴장이 그래픽 코드 생성에서 더 증폭됨. 효율(DocOwl2의 압축, MinerU의 요소 잘라내기)과는 반대로 출력량을 늘리는 방향이라, 추론 비용 측면의 정량 분석이 부족함.
7) Elo 해석의 미묘함 (저자 인정) Elo는 strict-match 점수와 수치가 안 맞고, 벤치 이미지셋에 수식·표 페이지가 적어 그 부분이 작은 가중치를 받음. 즉 리더보드가 정작 어려운 구조 콘텐츠의 약점을 과소평가할 수 있음.
5. 결론
1) 핵심 기여는 “그래픽을 1급 파싱 대상으로 — 픽셀이 아니라 코드로” 문서 파싱을 텍스트 추출에서 모든 정보 요소의 구조적 이해로 넓힘. 그래픽을 렌더링 가능한 SVG 프로그램으로 복원해, 버려지던 시각 정보를 재사용 가능한 supervision으로 바꿈. 3B 컴팩트 모델로 olmOCR-Bench SOTA(83.9), 오픈소스 Elo 1위, image-to-SVG에서 Gemini 3 Pro 능가를 동시에 달성.
2) 설계 핵심은 “데이터 엔진 + 정규화 + 단일 생성 목적” PDF·웹·SVG·일반 데이터를 합친 엔진으로 희소한 그래픽 supervision을 만들고, svgo 정규화·pHash 중복제거·렌더 검증으로 비유일 프로그램 문제를 통제함. 처음부터 학습한 고해상도 인코더 + base 디코더를, 단계적 해상도 상향과 단일 autoregressive 목적으로 묶어 텍스트·그래픽 파싱을 한 모델에 흡수. OCR Arena(LLM 심판 + 대칭 Elo)로 규칙 기반 지표의 취약성을 우회.
3) 계보에서의 위치 — 파싱 진영의 최전선, 출력 공간의 확장 Donut(JSON)→MinerU2.5·PaddleOCR-VL(Markdown)로 이어진 생성형 파싱의 출력 목표를 실행 가능한 그래픽 코드(SVG) 까지 끌어올린 한 칸임. OCRBench(같은 저자)가 진단한 그래픽·구조 약점을 코드 복원으로 공략하고, “문서 = image-to-code 사전학습 코퍼스”라는 데이터 엔진 관점을 제시해 ColPali·DocOwl2가 공유하던 “문서에서 더 많은 신호를 캔다”는 주제를 파싱 쪽에서 변주함. 한계 — 2패스, 자기 생태계 순환, 시각 지표의 느슨함, raster 경계 — 가 분명하지만, 문서를 “텍스트로 변환”에서 “코드로 재구성”으로 옮긴 전환점으로 읽으면 이후 흐름(TikZ·D3·CAD 등 다른 프로그램 공간으로의 확장)이 한 줄로 꿰임.
배경 개념 정리
image-to-SVG / image-to-code 이미지를 렌더링 가능한 벡터/프로그램 코드로 변환하는 task. SVG는 도형·선·스타일을 명시적으로 인코딩해 편집·재사용·합성이 쉬워, 차트·아이콘·UI 같은 구조적 그래픽의 복원 목표로 적합함. MOCR는 텍스트는 Markdown/LaTeX로, 그래픽은 SVG 코드로 파싱해 한 시퀀스로 통일.
렌더 가능한 프로그램의 비유일성(non-uniqueness) 같은 그림을 만들어내는 코드가 무수히 많다는 성질. 정답 코드가 하나로 정해지지 않아, 문자열 매칭 기반 학습·평가가 깨짐. MOCR는 정규화(svgo·viewBox 표준화·복잡도 축소)와 렌더 기반 비교로 이를 다룸.
ISVGEN (render-and-compare 지표) 예측 코드를 렌더한 결과와 원본 이미지의 시각 일치도를 재는 점수(UniSVG 제안). 비유일 코드 문제를 피해 “결과물이 원본과 닮았는가”로 평가하지만, 시각적으로 닮으면 구조·의미가 틀려도 높게 나올 수 있다는 한계가 있음.
LLM-as-a-Judge / Elo + 대칭 평가 고성능 VLM(Gemini 3 Flash)에게 두 출력의 우열을 판정시키는 평가. 규칙 매칭의 취약성(동의 표기 과벌점)을 피함. 위치 편향을 막으려 A·B 순서를 뒤집어 2회 시행해 일치할 때만 승리 인정하고, 결과를 체스식 Elo로 집계(부트스트랩 1,000회 평균)해 리더보드를 만듦.
데이터 엔진(data engine)으로서의 문서 파싱 문서를 1회성 변환 대상이 아니라, 멀티모달 사전학습용 (이미지, 코드, 텍스트) 삼중쌍을 무한히 생산하는 공급원으로 보는 관점. 차트 하나가 SVG로 파싱되면 통제·교란 가능한 학습 데이터가 되고, 그 규모는 가용 문서 수에만 묶임. MOCR가 자신의 의의로 가장 강조하는 프레이밍.
dots.mocr vs dots.mocr-svg 같은 사전학습을 공유하되, 후자는 SFT에서 SVG 비중과 어려운 SVG 프로그램 가중치를 높인 변형. 같은 3B 예산 안에서 문서 파싱 집중(전자)과 그래픽 복원 집중(후자)의 trade-off를 두 체크포인트로 분리한 것.