OCRBench
OCRBench: On the Hidden Mystery of OCR in Large Multimodal Models
Authors: Yuliang Liu, Zhang Li, Mingxin Huang, Biao Yang, et al. (HUST, Microsoft Research, USTB, CAS, SCUT) — arXiv 2305.07895, 2023년 5월 (v7: 2024년 8월).
OCR 벤치마크·진단 논문임. 29개 데이터셋·5개 task를 아우르는, 당시 기준 가장 포괄적인 MLLM OCR 평가 작업이며, 14개 MLLM(GPT4V·Gemini 포함)의 OCR 능력을 처음으로 체계적으로 측정함. 수작업 검수를 거친 1,000문항의 표준 벤치마크 OCRBench를 함께 공개했고, 이후 MLLM들의 OCR 점수 비교 표준으로 자리잡음. 시기상 DocOwl2(2024.9)·MinerU2.5/PaddleOCR-VL(2025)보다 앞서며, 여기서 내려진 진단 — 해상도 부족, 의미 의존, 다국어 약점 — 은 이후 모델들이 하나씩 공략하는 과제 목록이 됨. 경량 문서 파서 계보의 출발점에 놓인 논문임.
1. 문제 정의
핵심 문제
MLLM(거대 멀티모달 모델)의 OCR 능력을 정확하게 측정하는 것이 핵심 문제임.
LLaVA류 MLLM들이 OCR 데이터로 따로 학습하지 않았는데도 zero-shot으로 글자를 꽤 읽어낸다는 게 알려지면서, “그래서 얼마나 잘 읽는데? 어디서 무너지는데?”라는 질문이 생김. 이걸 모르면 멀티모달 방법론을 어디서 개선해야 할지도 알 수 없음. 텍스트가 들어간 시각 task는 종류가 다양해서 — 글자 인식, 간판 읽기, 문서 QA, 영수증 키-값 추출, 손글씨 수식 — 한두 데이터셋으로는 능력의 윤곽이 안 잡힘.
기존 벤치마크의 한계
MLLM 평가 벤치마크는 이미 있었지만, OCR을 재기엔 두 가지가 막힘.
1) OCR 커버리지 부족 MMBench·MME 같은 종합 벤치는 능력 차원을 폭넓게 재지만 OCR 데이터 비중이 작음. “글자를 읽는 능력” 자체를 본격적으로 측정하는 자리가 없었음.
2) 평가 형식의 부적합 True/False나 객관식으로는 “이미지 속 단어를 정확히 읽어냈는가”를 잴 수 없음. 찍어도 맞고, 보기에서 고르는 것과 글자를 생성해내는 건 다른 능력임. 게다가 MLLM의 답변엔 설명이 줄줄 붙어서, 기존 OCR 평가의 exact match나 ANLS도 zero-shot 평가엔 안 맞음.
정리하면 “생성형 답변을 내는 MLLM의 OCR을, 충분한 커버리지로, 공정하게 재는 틀”이 없었던 게 미해결 과제임.
2. 제안 방법: OCRBench
논문은 두 갈래로 답함. 먼저 29개 데이터셋·5개 task에 걸친 대규모 진단 연구(14개 MLLM), 그리고 그 결과를 압축한 1,000문항짜리 표준 벤치마크 OCRBench.
2.1 다섯 가지 task
OCR 능력을 다섯 축으로 분해함.
| Task | 내용 | 대표 데이터셋 |
|---|---|---|
| Text Recognition | 단어 이미지 → 글자 그대로 읽기 (정자/왜곡/가림/예술체/손글씨/중국어/숫자열) | IIIT5K, IC15, IAM, ReCTS 등 |
| Scene Text-Centric VQA | 자연 풍경 속 글자에 대한 질문 답하기 | STVQA, TextVQA, ESTVQA |
| Document-Oriented VQA | 문서·차트·인포그래픽에 대한 질문 답하기 | DocVQA, ChartQA, InfoVQA |
| KIE | 영수증·양식에서 키-값 추출 | SROIE, FUNSD, POIE |
| HMER | 손글씨 수식 → LaTeX | HME100K |
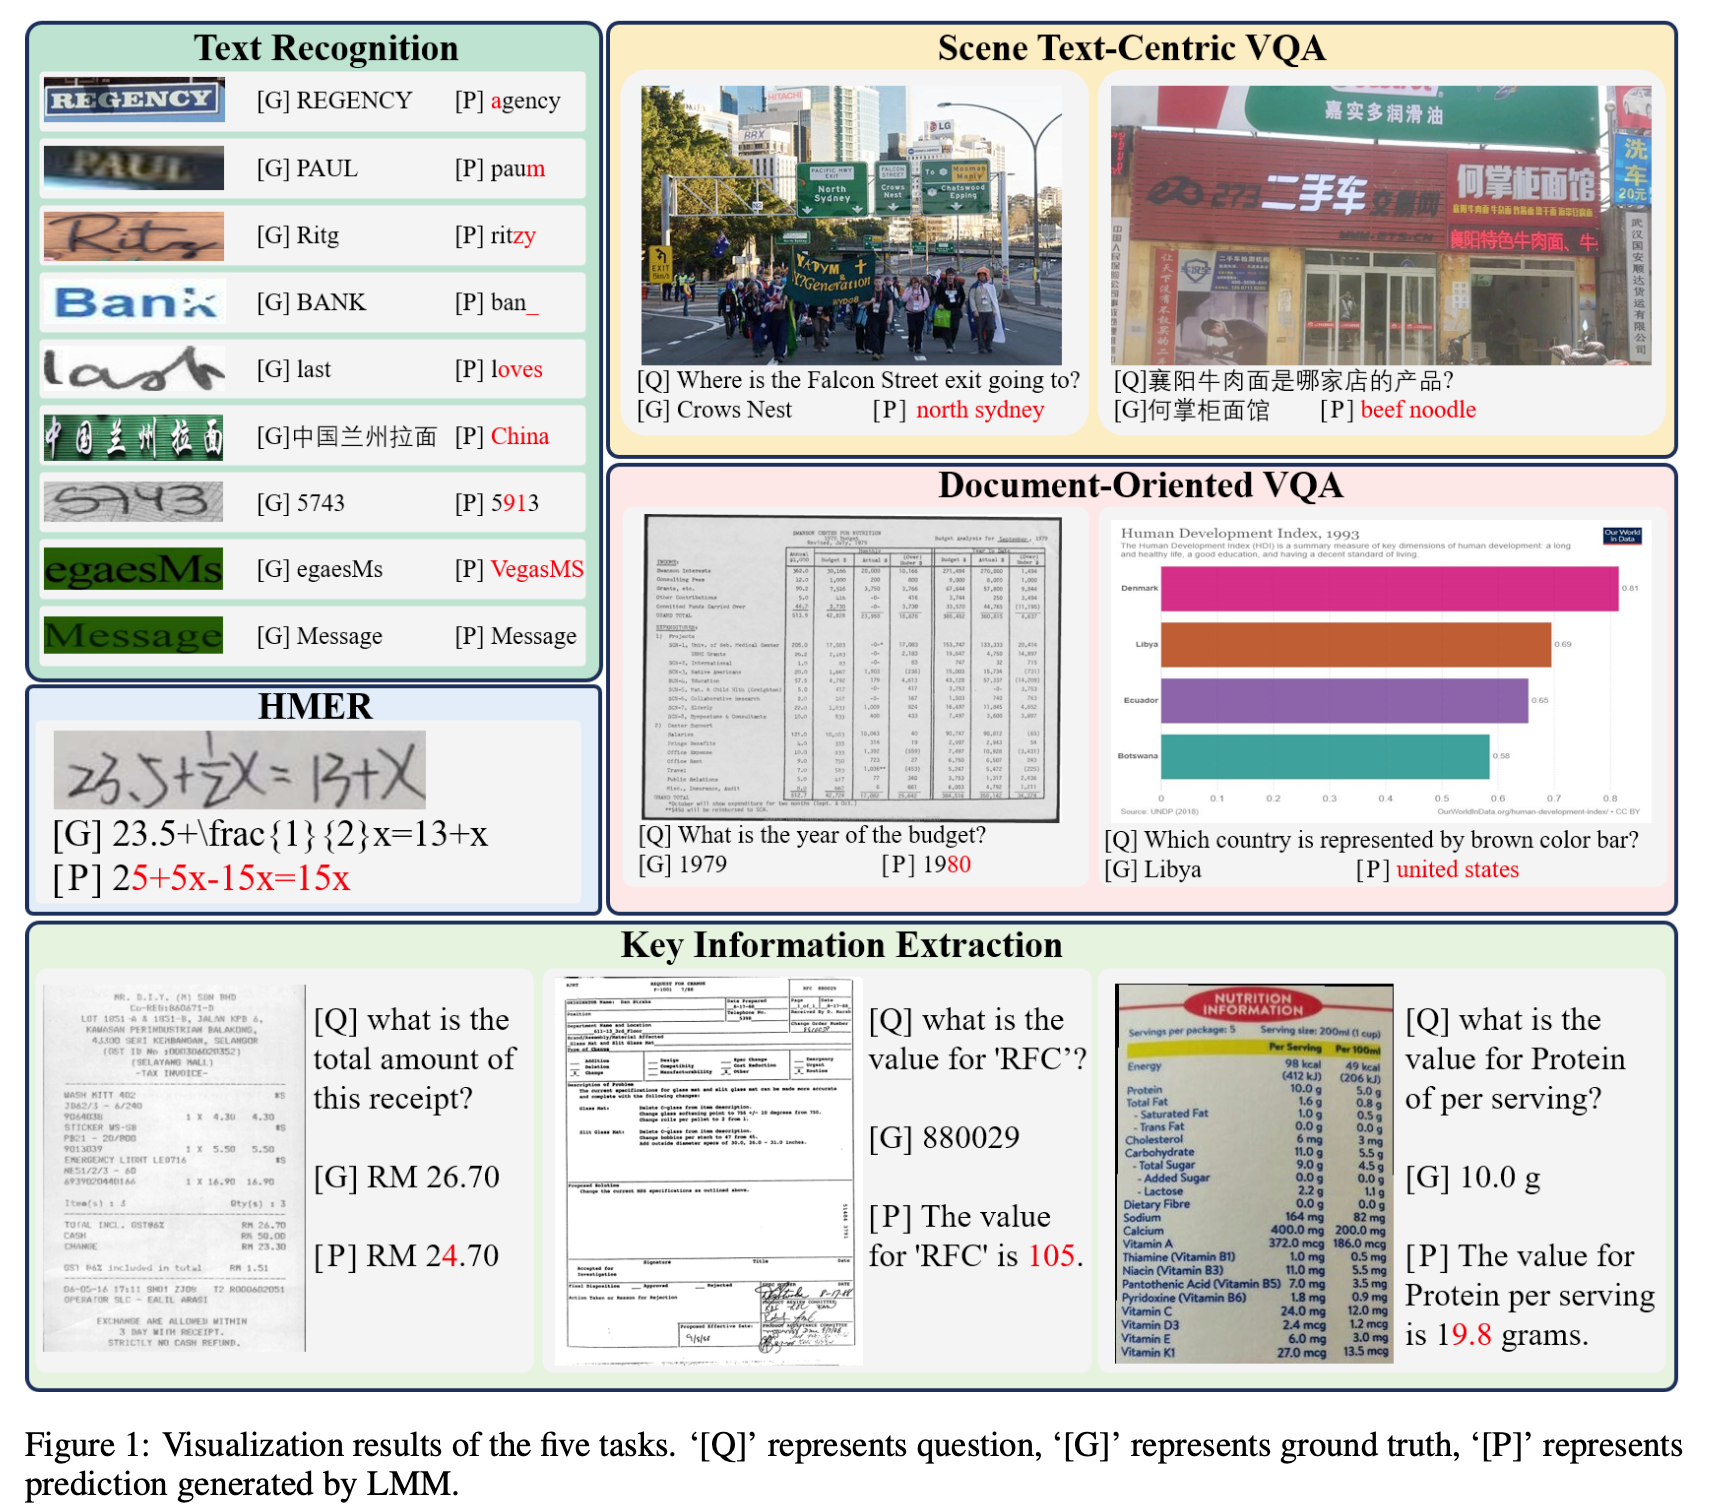 Figure 1: 다섯 task의 시각화 예시. [Q]는 질문, [G]는 정답(ground truth), [P]는 MLLM의 예측.
2.2 평가 프로토콜: containment 채점
MLLM 답변엔 설명이 붙으니, “정답(GT) 문자열이 출력 안에 포함돼 있는가”라는 단순 통일 기준을 씀. 짧은 답이 우연히 포함되는 false positive를 줄이려고 정답 4글자 미만 문항은 걸러냄. zero-shot 생성형 모델을 데이터셋 종류와 무관하게 한 잣대로 재겠다는 실용적 선택임.
2.3 진단 도구 설계: ST vs NST
진단의 핵심 장치는 ST/NST 쌍 비교임. 같은 단어로 두 세트를 만듦 — ST(Semantic Text)는 IIIT5K 사전의 정상 단어 3,000장, NST(Non-Semantic Text)는 같은 단어의 글자 순서를 섞은 것. 모양 난이도는 같고 의미만 제거한 통제 실험임. 이걸로 “MLLM이 글자를 읽는 거냐, 단어를 추측하는 거냐”를 분리해냄.
예를 들어 ST는 PUBLIC(사전에 있는 단어) 이미지, NST는 같은 글자를 섞은 BULPIC 이미지임. 폰트·글자 모양·왜곡은 똑같고 “사전에 있는 단어냐”만 다름. 글자를 한 자씩 읽는 모델이면 PUBLIC이든 BULPIC이든 동일하게 맞히지만, 단어를 추측하는 모델은 ST에선 몇 글자만 보고 “PUBLIC”으로 완성해 맞히다가 NST에선 대응되는 실제 단어가 없어 엉뚱한 단어로 교정하거나 글자를 틀림. ST − NST 정답률 격차가 곧 “읽기 대 추측” 의존도의 지표가 됨.
2.4 OCRBench 본체
29개 셋을 다 돌리는 건 비싸고, 일부 셋은 라벨 오류가 점수를 오염시킴. 그래서 5개 task에서 1,000문항을 추려 수작업으로 검수·교정하고(복수 정답 후보 제공), KIE엔 “이미지 속 텍스트로 직접 답하라”는 프롬프트를 붙여 형식을 통제함. 구성은 Recognition 300 / Scene VQA 200 / Doc VQA 200 / KIE 200 / HMER 100.
3. 실험 결과: 다섯 가지 진단
벤치마크 논문이므로 수치보다 발견이 본체임. 14개 MLLM을 훑은 결론이 다섯 줄로 압축됨.
1) Semantic-Reliance — MLLM은 글자를 “읽는” 게 아니라 “추측”함 글자 순서를 섞자(ST→NST) MLLM 정확도가 평균 57.0% 폭락함. 같은 조건에서 supervised SOTA(PARSeq)는 4.6%만 떨어짐. 전용 OCR 모델은 글자를 한 자씩 인식하고 의미는 보조로 쓰는 반면, MLLM은 의미 사전에서 그럴듯한 단어를 꺼내오는 쪽에 가까움. “Message”는 읽지만 그걸 섞은 “egaesMs”는 “VegasMS”로 읽는 식임. 숫자열(ORAND)에서 일제히 무너지는 것도 같은 이유 — 숫자열엔 추측할 의미가 없음.
2) 손글씨 약함 — supervised SOTA 대비 평균 51.9% 낮음. 글자·숫자 모양의 유사성, 흘림·번짐에 취약함.
3) 다국어 약함 — ESTVQA(EN) vs (CN) 격차가 큼. 다수 모델이 중국어에서 0점대. 중국어 데이터로 학습한 Monkey만 42.6으로 유일하게 버팀. 학습 데이터의 언어 분포가 곧 능력임.
4) Fine-grain Perception — 해상도가 곧 성능 — 224×224에 묶인 모델들은 Doc VQA·KIE에서 일관되게 무너짐. 1344×896을 받는 Monkey는 같은 task에서 확연히 나음. 작은 글자·빽빽한 구조를 보려면 고해상도 입력이 필수라는 진단임.
5) HMER 전멸 — 거의 모든 MLLM이 0점대. GPT4V·Gemini조차 한 자릿수. 어지러운 손글씨 + 복잡한 공간 구조 + LaTeX 간접 표현 + 학습 데이터 부족의 합작임.
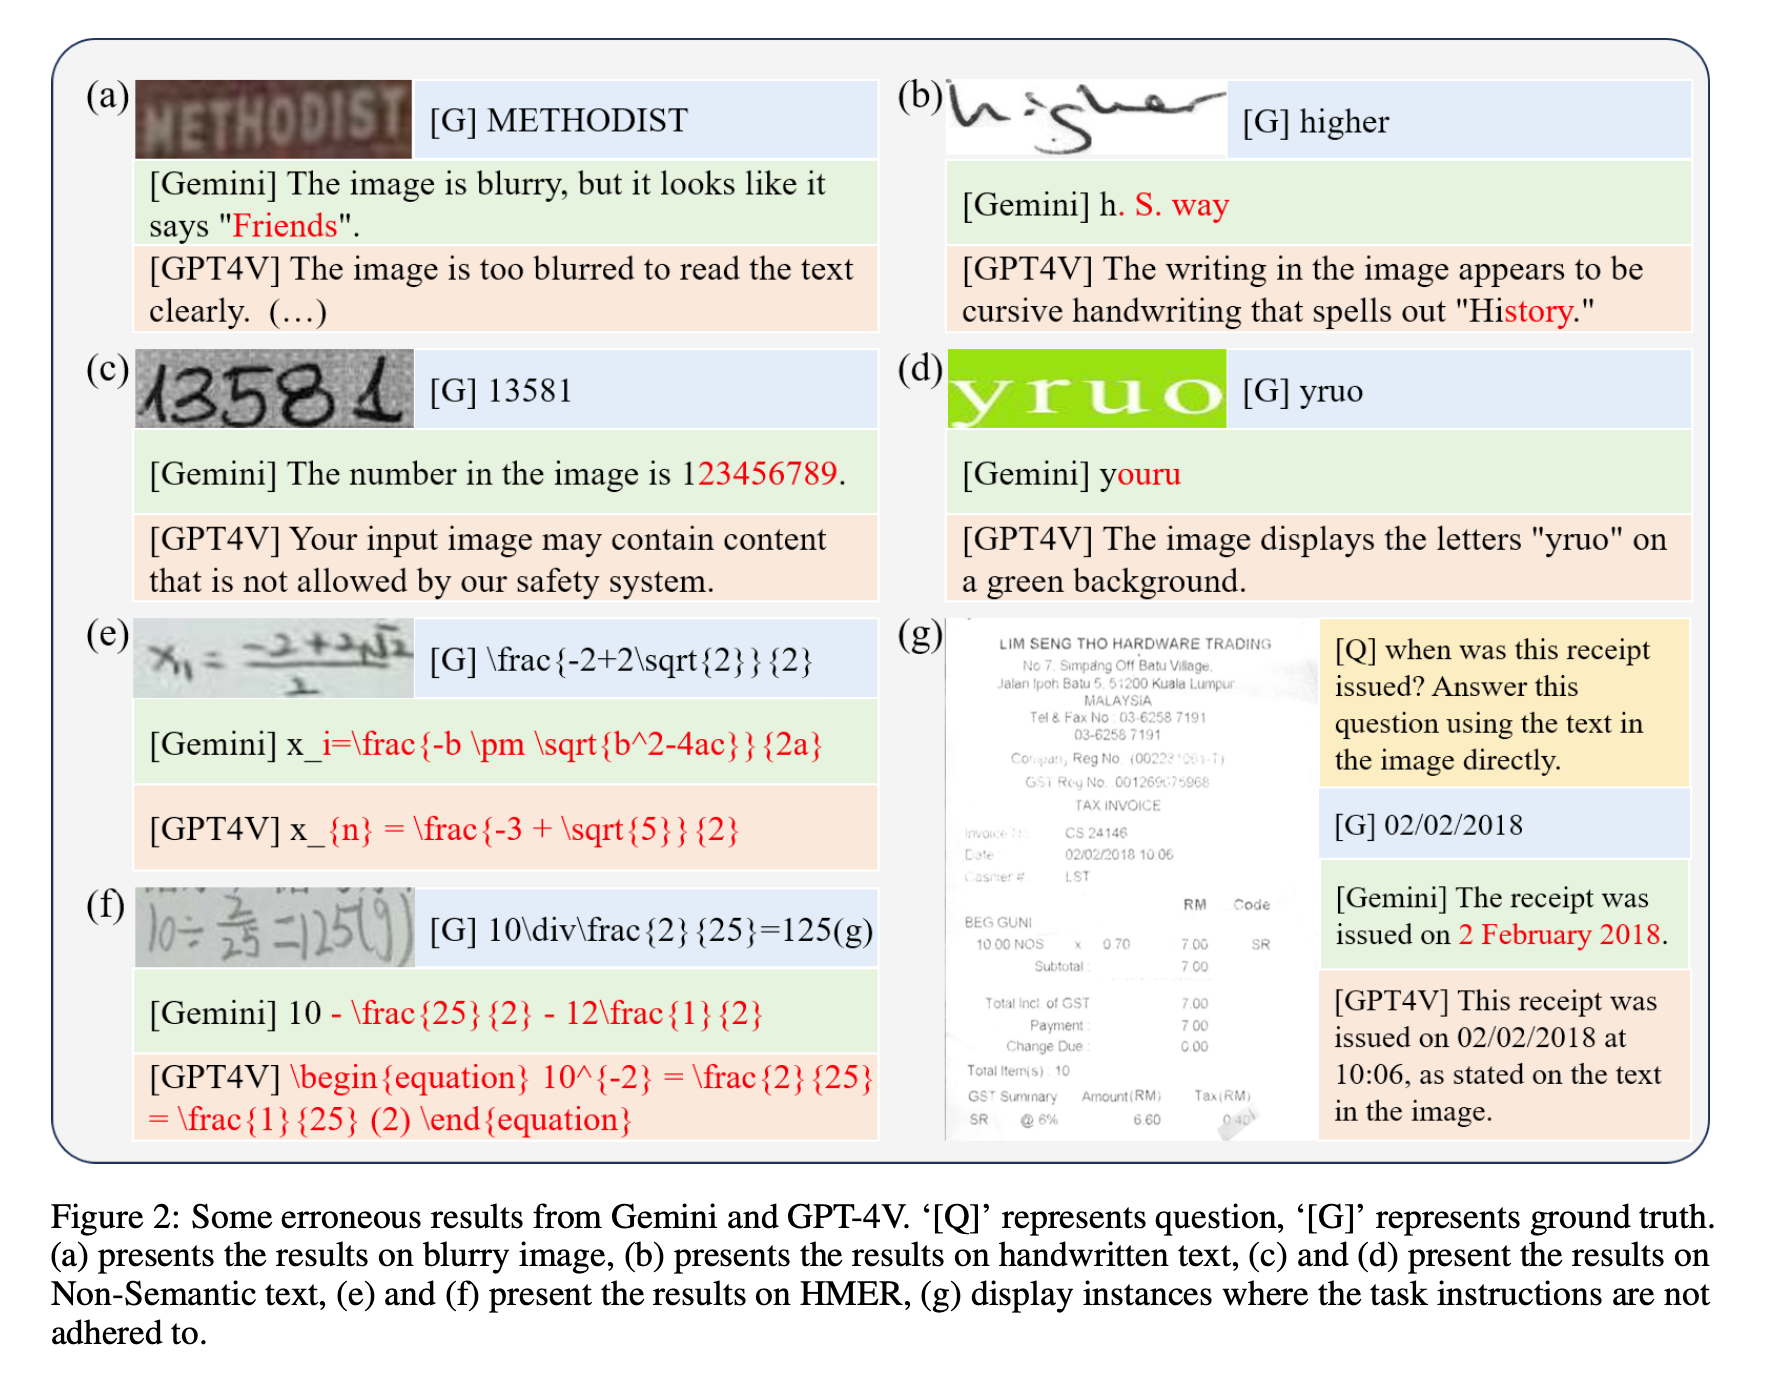 Figure 2: Gemini와 GPT-4V의 오류 사례. (a) 흐릿한 이미지, (b) 손글씨, (c)(d) Non-Semantic text, (e)(f) HMER, (g) 지시(task instruction) 불이행 사례.
OCRBench 리더보드
| 모델 | Recog. | VQA_S | VQA_D | KIE | HMER | 총점(1000) |
|---|---|---|---|---|---|---|
| Gemini | 215 | 174 | 128 | 134 | 8 | 659 |
| GPT4V | 167 | 163 | 146 | 160 | 9 | 645 |
| Monkey | 174 | 161 | 91 | 88 | 0 | 514 |
| mPLUG-Owl2 | 153 | 153 | 41 | 19 | 0 | 366 |
이후 업데이트(v7, 2024.8)에선 MiniCPM-V2.6이 852, InternVL2-76B가 842, 2B짜리 MiniMonkey가 802까지 올라옴. 1년 만에 리더보드 상단이 200점 가까이 뛴 것 자체가, 이 벤치마크가 짚은 약점들이 집중 공략됐다는 증거임.
4. 한계 및 비판
1) containment 채점의 양면성 “GT가 출력에 포함되면 정답”은 단순하고 공정하지만 거칢. 모델이 후보를 여러 개 나열하거나 장황하게 설명하면 우연히 정답이 포함될 수 있고(4글자 필터로 완화될 뿐 제거는 안 됨), 반대로 “02/02/2018”을 “2 February 2018”로 답하면 의미상 맞아도 오답 처리됨 — 논문 스스로 Fig. 2(g)에서 이걸 “지시 불이행”으로 보여주지만, 채점 기준의 경직성 문제이기도 함. 형식 준수와 인식 능력이 한 점수에 섞여 있음.
2) 1,000문항의 대표성 task당 100~300문항임. 수작업 검수로 라벨 품질은 높였지만, 표본이 작아 상위권 모델 간 수십 점 차이는 노이즈 범위일 수 있음. 벤치마크가 유명해질수록 학습 데이터 오염(contamination) 위험도 커지는데, 출처가 전부 공개 데이터셋이라 통제 장치가 없음.
3) 진단이지 처방이 아님 “왜 MLLM이 OCR이 되는가”에 대해 논문 스스로 “결정적으로 설명하기 어렵다”고 인정함. CLIP류 학습 데이터에 OCR성 데이터가 섞여 있을 것이라는 추정, 그리고 visual token이 word embedding 공간에 정렬되며 인식이 가능해진다는 구조적 가설을 제시하는 수준에 그침. ablation은 없음.
4) 커버리지 공백 (저자 인정) 다국어 문서, 다양한 촬영 환경, text detection task가 빠져 있음. 영어·중국어 중심임. PaddleOCR-VL이 109개 언어를 전면에 내세운 것과 대비하면, 이 벤치마크의 다국어 진단은 입구 수준임.
5) 페이지 단위 파싱은 측정 범위 밖 OCRBench는 단어·질문 단위 평가라, MinerU2.5/PaddleOCR-VL이 겨루는 전체 문서 파싱(구조·읽기 순서·Markdown 변환)은 재지 못함. 그래서 파싱 진영은 OmniDocBench·olmOCR-Bench라는 별도 무대로 감. OCRBench는 “읽기 능력”의 벤치이지 “문서 변환 품질”의 벤치가 아님 — 범주를 섞지 말 것.
5. 결론
1) 핵심 기여는 “MLLM OCR의 첫 체계적 진단 + 표준 측정자” 29개 셋·5개 task 연구로 MLLM OCR의 윤곽을 처음 그렸고, 그걸 1,000문항 OCRBench로 압축해 이후 모든 MLLM이 OCR 점수를 한 줄로 비교하는 표준을 만듦. 실제로 거의 모든 후속 모델 카드에 OCRBench 점수가 박히게 됨.
2) 가장 값진 발견은 Semantic-Reliance ST/NST 통제 실험으로 “MLLM은 글자를 읽는 게 아니라 의미로 추측한다”를 정량화함(57.0% vs 4.6%). 이건 앞서 DocOwl2 리뷰에서 다룬 “의미 공간 정렬”의 양면임 — 의미 정렬이 MLLM OCR을 가능하게 하는 메커니즘인 동시에, 의미 없는 텍스트에서 무너지는 약점의 근원임. 같은 동전의 앞뒤를 이 논문이 먼저 보여준 셈임.
3) 후속 계보의 출발점 이 논문의 진단 4번(해상도가 곧 성능)이 곧바로 “고해상도 → 시각 토큰 폭증 → token redundancy”라는 다음 문제를 낳음. 그 문제를 DocOwl2가 압축으로, MinerU2.5/PaddleOCR-VL이 요소 잘라내기로 풀게 됨. 진단(2023, OCRBench) → 효율 처방(2024~2025, 모델들) → 파싱 전용 평가(OmniDocBench)로 이어지는 흐름의 첫 칸에 이 논문이 있음.
배경 개념 정리
Zero-shot 평가 해당 task의 데이터로 fine-tuning하지 않은 모델을 그대로 평가하는 것임. supervised SOTA는 각 데이터셋에 맞춰 학습된 전용 모델이라, 이 논문의 비교는 “범용 모델의 공짜 능력 vs 전용 모델의 최고치”의 대조임.
Containment 채점 vs ANLS vs Exact Match Exact match는 글자 하나라도 다르면 오답, ANLS는 편집거리 기반 부분 점수, containment는 정답 문자열이 출력 어딘가에 있으면 정답. 생성형 MLLM은 설명을 붙여 답하므로 앞 둘은 불리하고, containment가 실용적이지만 위 4-1의 거칢을 감수함.
ST / NST (Semantic / Non-Semantic Text) 같은 단어의 정상 표기와 글자 섞은 표기로 만든 쌍둥이 세트. 시각 난이도를 고정하고 의미만 제거해, “문자 인식”과 “단어 추측”을 분리하는 통제 변인 설계임.
KIE (Key Information Extraction) 영수증·양식 같은 반정형 문서에서 정해진 키(회사명·날짜·총액 등)의 값을 뽑는 task. 단순 읽기보다 “어느 글자가 어느 필드인지”의 구조 이해가 필요해서, 해상도와 레이아웃 이해가 동시에 시험됨.
HMER (Handwritten Mathematical Expression Recognition) 손글씨 수식을 LaTeX로 옮기는 task. 글자 인식 + 2차원 공간 구조(첨자·분수) 해석 + LaTeX 문법 생성이 겹쳐, MLLM에게 가장 어려운 조합임. 이후 파싱 모델들이 수식을 별도 task로 분리해 학습하는 이유이기도 함.