Donut
OCR-free Document Understanding Transformer
Authors: Geewook Kim, Teakgyu Hong, Moonbin Yim, Jeongyeon Nam, Jinyoung Park, Jinyeong Yim, Wonseok Hwang, Sangdoo Yun, Dongyoon Han, Seunghyun Park (NAVER CLOVA, NAVER Search, NAVER AI Lab, Upstage, Tmax, Google, LBox) — arXiv 2111.15664, ECCV 2022.
문서 이해(VDU) 논문이자, 오늘 본 계보에서 “OCR-free 생성형 문서 모델”의 출발점임. 시기상 LayoutLMv3(2022.4)와 거의 같은 2021년 말~2022년 작업인데, 둘은 정반대 답을 냄. LayoutLMv3가 외부 OCR + 인코더로 토큰 라벨·QA 스팬을 뽑는 길을 끝까지 밀었다면, Donut은 OCR을 통째로 버리고 인코더-디코더로 이미지에서 곧장 구조화 출력(JSON)을 생성함. LayoutLMv3 리뷰에서 “OCR-free와 정반대 방향”이라고 했던 그 반대쪽 극이 바로 이 논문임. OCRBench가 진단할 “해상도가 곧 성능 → 토큰 폭증” 문제를 Donut은 이미 (고해상도 입력으로) 정면으로 안고 있고, 이후 DocOwl2·MinerU2.5·PaddleOCR-VL이 표방하는 “OCR-free 생성형 파싱/이해”가 전부 이 논문이 처음 깐 발상 — 읽기(pseudo-OCR)로 사전학습하고, 이해를 생성으로 푼다 — 의 직계 후손임. LLM-VLM 시대의 문서 모델이 결국 Donut 쪽 길로 갔다는 점에서, 그 분기점에 놓인 논문으로 읽으면 흐름이 한 줄로 꿰임.
1. 문제 정의
핵심 문제
문서 이미지(영수증·송장·명함 등)에서 OCR 없이 원하는 정보를 곧장 뽑아내는 것이 핵심 문제임.
VDU(Visual Document Understanding)는 산업의 필수 task(분류·정보추출·VQA)지만, 당시 방법들은 전부 2단계로 풀었음: ① OCR로 글자를 읽고 → ② 그 텍스트로 문서를 이해함. 즉 읽기를 외부 OCR 엔진에 외주(outsource)하고 이해 모델링에만 집중하는 구조임.
기존 연구의 한계
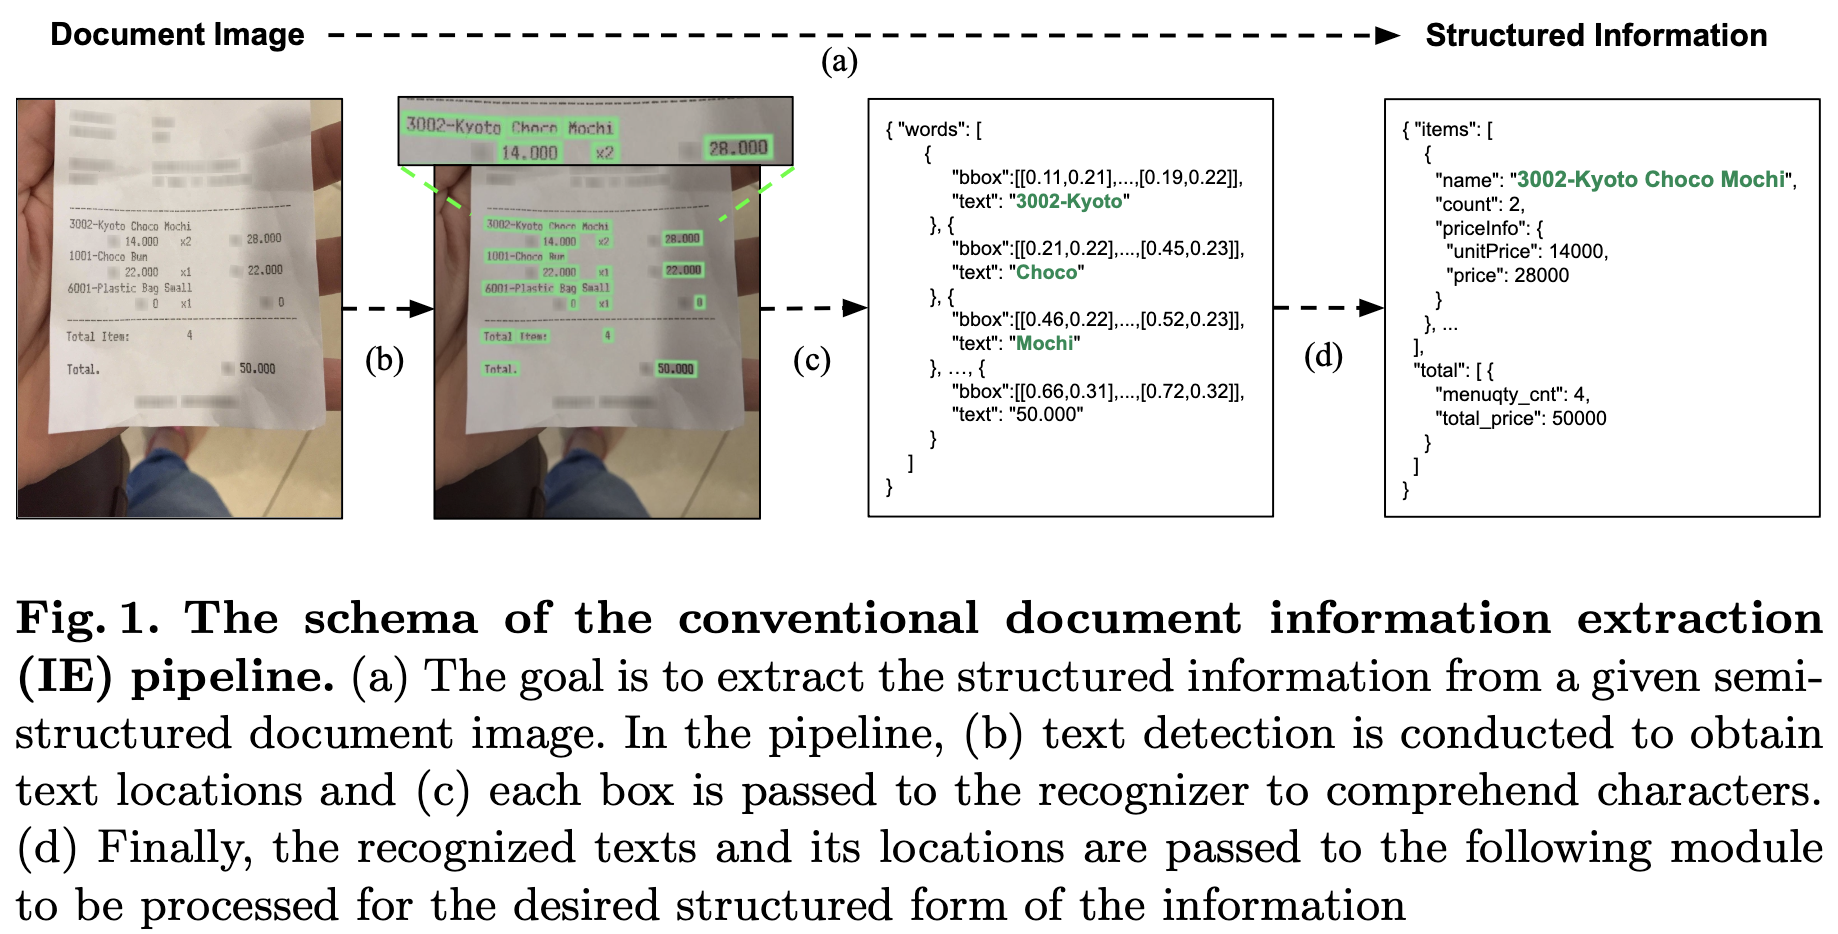
위 그림이 당시 표준이던 2단계 파이프라인임. 문서 이미지에서 (b) 텍스트 위치를 검출하고 (c) 각 박스를 인식기에 넣어 글자를 읽은 뒤, (d) 그 텍스트·위치를 후속 모듈에 넘겨 원하는 구조로 만듦. OCR 의존 접근(OCR + BERT/LayoutLM 계열)이 좋은 성능을 냈지만, 세 가지 치명적 문제를 안고 있음.
1) OCR의 높은 연산 비용 고품질 OCR 결과를 얻으려면 추론 비용이 비쌈. 직접 OCR을 학습시키면 대규모 데이터·학습 비용이 추가로 듦.
2) 언어·도메인 경직성 off-the-shelf OCR은 언어나 문서 종류가 바뀌면 유연하게 대응하지 못해 일반화가 약함. 특히 한국어·중국어처럼 글자 집합이 복잡한 언어에서 OCR 품질이 낮음. 이를 보완하려 post-OCR correction 모듈을 붙이면 시스템 크기·유지비가 커져 실전에 비실용적임.
3) OCR 오류 전파 OCR 단계의 인식 오류가 그대로 후속 이해 단계로 전파돼 전체 성능의 상한(upper-bound)을 깎음. 파이프라인이 길고 부서지기 쉬운 구조의 근본 약점임.
정리하면 OCR을 전처리로 끼우는 것 자체가 비용·경직성·오류전파의 근원인데, 당시 거의 모든 VDU 모델이 이 전제 위에 서 있었던 게 미해결 과제임.
2. 제안 방법: Donut
OCR 모듈을 일절 두지 않고, 비전 인코더 + 텍스트 디코더만으로 이미지 → 구조화 출력(JSON) 을 end-to-end 생성하는 Transformer임. 아키텍처도 사전학습 목적도 단순함(cross-entropy 하나).
2.1 핵심 아이디어
OCR을 떼어내고, 디코더가 이미지를 보며 원하는 출력을 직접 “생성”하게 한다.
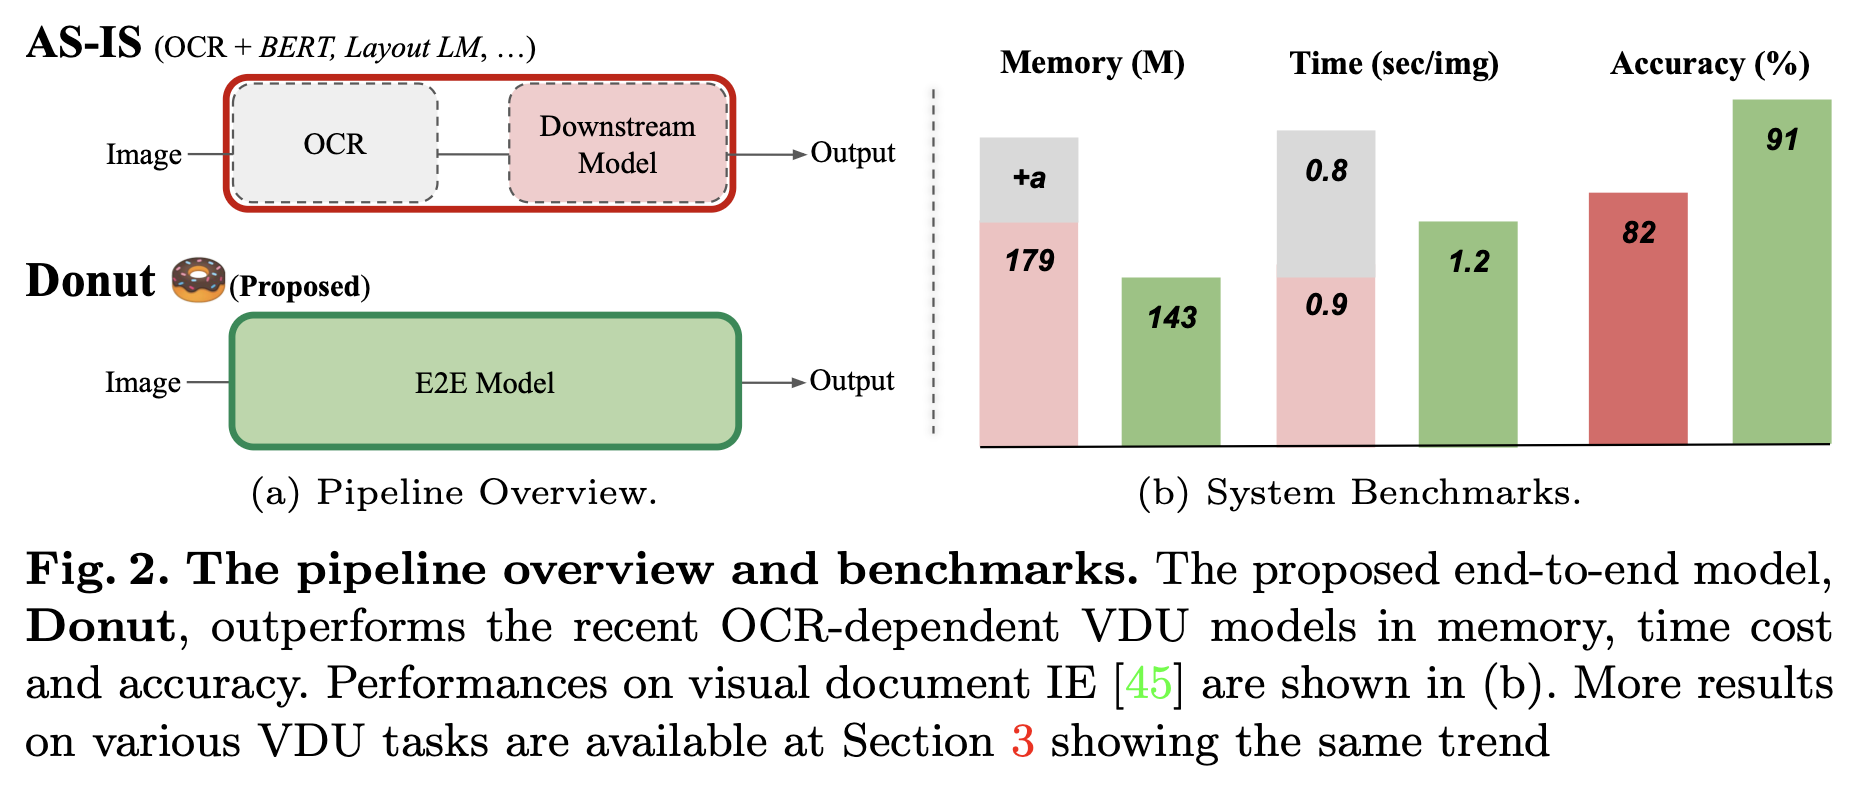
위 그림 (a)가 발상의 핵심임. 기존(AS-IS)은 OCR로 읽고 다운스트림 모델로 이해하는 2단 파이프라인이지만, Donut은 단일 end-to-end 모델로 이미지에서 곧장 출력을 냄. (b) 벤치마크에서 메모리·시간·정확도 모두 OCR 의존 모델을 앞섬.
기존이 “읽기(OCR) → 이해(분류/태깅)”의 분리 구조였다면, Donut은 읽기와 이해를 한 모델의 생성 과정 안으로 합침. 사전학습에서는 디코더가 이미지를 조건으로 모든 글자를 읽도록(다음 토큰 예측) 학습하고 — 저자들은 이를 pseudo-OCR이라 부름 — 미세조정에서는 task별 정답을 JSON으로 생성하도록 가르침. 출력이 라벨·스팬이 아니라 자유 생성 시퀀스라, 분류·추출·VQA를 전부 “JSON 예측”이라는 한 형식으로 통일함.
LayoutLMv3와의 대비가 이 논문의 정체성임. 같은 2022년, LayoutLMv3는 OCR로 뽑은 단어·좌표를 인코더에 넣어 토큰 라벨링/QA 스팬(추출형)으로 풀었고, Donut은 OCR을 없애고 디코더로 JSON을 생성(생성형)함. LayoutLMv3 리뷰에서 “인코더 모델의 task 형식 제약 — 자유 생성 불가”를 한계로 꼽았는데, Donut은 정확히 그 반대편에서 생성형으로 출발함. 이후 DocOwl2(자유 생성 이해), MinerU2.5·PaddleOCR-VL(Markdown 생성 파싱)이 전부 이 생성형·OCR-free 노선을 잇는다는 점에서, Donut은 그 노선의 시조(始祖) 격임.
2.2 아키텍처
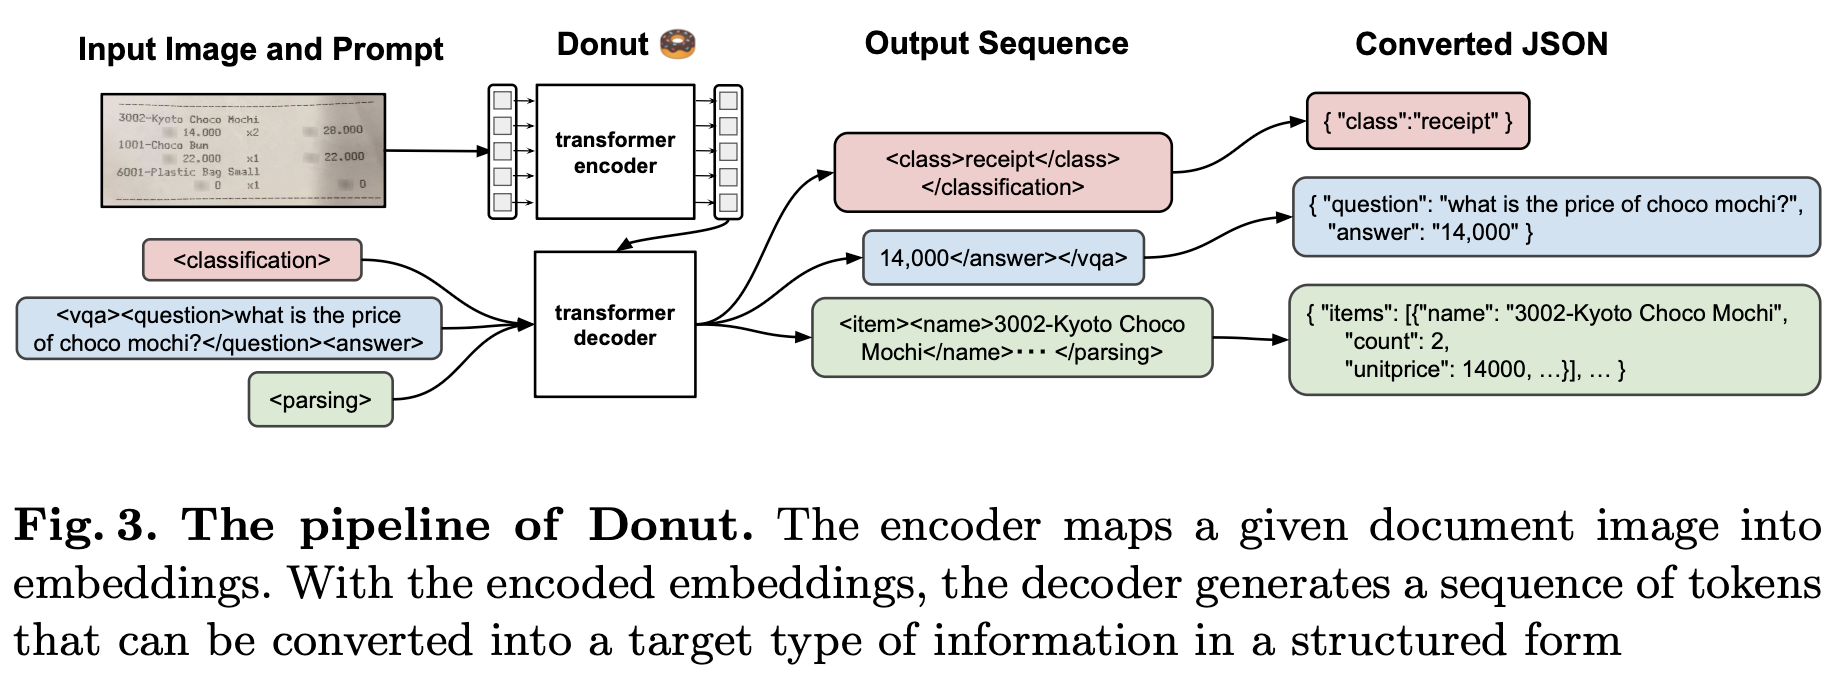
인코더가 문서 이미지를 임베딩으로 매핑하고, 디코더가 task 프롬프트(<classification>·<vqa>·<parsing>)에 따라 토큰 시퀀스를 생성하면 이를 구조화 JSON으로 변환함.
| 구성요소 | 내용 |
|---|---|
| 인코더 | Swin Transformer(예비 실험에서 최고). 입력 이미지 x∈ℝ^{H×W×C}를 비중첩 패치로 분할 → shifted-window self-attention + patch merging → 임베딩 {z_i} 추출. CNN·검출기·OCR 없음 |
| 디코더 | BART(다국어 mBART 가중치로 초기화). {z}를 받아 subword 토큰 시퀀스 생성 |
| 입력/학습 | teacher-forcing로 학습. 테스트 땐 GPT-3식 프롬프트로 생성 시작. task마다 special token 프롬프트 추가(<classification>, <parsing>, <vqa> 등) |
| 출력 변환 | 토큰 시퀀스 ↔ JSON 1:1 가역. [START *]/[END *] 토큰으로 필드 구분. 구조가 깨지면(예: [END name] 누락) 해당 필드는 추출 실패로 간주. 정규식으로 간단 구현 |
2.3 사전학습 — “읽기” 학습
Task: 이미지 속 모든 글자를 읽기 순서(좌상→우하) 로 읽도록, 이미지와 직전 문맥을 조건으로 한 다음 토큰 예측의 cross-entropy를 최소화함. 본질은 문서 이미지 코퍼스 위의 시각 언어모델(visual language model) 학습 = pseudo-OCR.
Visual Corpora:
- IIT-CDIP 1,100만 영어 스캔 문서 + 상용 CLOVA OCR API로 만든 pseudo 텍스트 라벨.
- 영어 외 언어엔 이런 데이터가 부족 → 확장 가능한 합성 생성기 SynthDoG 자체 제작. CJKE Wikipedia로 언어당 0.5M 샘플 생성.
SynthDoG: 배경(ImageNet) + 종이 텍스처(수집 사진) + 텍스트/구절(Wikipedia) + 레이아웃(규칙 기반 그리드 적층) + 렌더링 기법(왜곡·블러·그림자 등 실문서 모방). 단순하지만 다국어·도메인 유연성을 사전학습 단계에서 확보하는 장치 — OCR 엔진 재학습이 필요한 기존 방식과 대비되는 결정적 이점.
2.4 미세조정 — “이해” 학습
읽기를 배운 모델에 task별 이해를 가르침. 모든 다운스트림 task를 JSON 예측으로 해석함. 예: 분류는 [START class][memo][END class] → {"class":"memo"}로 가역. 클래스명 같은 건 special token([memo])으로 치환 가능하면 도입.
3. 실험 결과
3개 응용·6개 데이터셋(공개 벤치 + 사내 실서비스 데이터). 인코더 Swin-B({2,2,14,2}, window 10), 디코더는 속도-정확도 절충으로 BART 앞 4개 층. 2M 합성 + 11M IIT-CDIP로 사전학습(200K step, A100 64장, 배치 196). 입력 해상도 2560×1920, 디코더 max length 1536. Donut 속도는 (느린) P40에서 측정 — OCR 베이스라인은 A100 기준이라 사실상 Donut에 불리한 조건.
3.1 문서 분류 (RVL-CDIP)
| 모델 | OCR | #Params | Time(ms) | Acc(%) |
|---|---|---|---|---|
| BERT | ✓ | 110M+α | 1392 | 89.81 |
| LayoutLM (w/ image) | ✓ | 160M+α | 1426 | 94.42 |
| LayoutLMv2 | ✓ | 200M+α | 1489 | 95.25 |
| Donut | ✗ | 143M | 752 | 95.30 |
외부 자원(OCR) 없이 LayoutLMv2를 더 적은 파라미터·2배 빠른 속도로 능가. OCR 베이스라인은 표의 +α(OCR 프레임워크 80M+)까지 더해야 공정한데, 그것까지 감안하면 격차가 더 벌어짐.
3.2 문서 정보추출 (IE, F1 / TED-Acc)
| 데이터셋 | LayoutLMv2 (OCR) | Donut |
|---|---|---|
| CORD | 78.9 / 82.4 (1.7s) | 84.1 / 90.9 (1.2s) |
| Ticket | 87.2 / 90.1 (1.8s) | 94.1 / 98.7 (0.6s) |
| Business Card (사내) | 52.2 / 83.0 (1.6s) | 57.8 / 84.4 (1.4s) |
| Receipt (사내) | 72.9 / 78.0 (2.6s) | 78.6 / 88.6 (1.9s) |
전 도메인에서 최고 점수 + 더 빠른 추론. F1뿐 아니라 TED 기반 정확도(트리 구조 일치도)에서도 앞서, 키 추출은 물론 중첩 그룹·계층 구조까지 잡아냄을 보임. 데이터 크기·복잡도와 무관하게 안정적(BIO 태깅 기반 SPADE·WYVERN은 들쭉날쭉). 해상도가 크면 정확하지만 느려짐(CORD를 1280×960으로 낮추면 0.7s·91.1).
3.3 문서 VQA (DocVQA, ANLS)
| 모델 | Fine-tuning | OCR | #Params | Time(ms) | ANLS(test) | ANLS(손글씨) |
|---|---|---|---|---|---|---|
| LayoutLMv2 | train | ✓ | 200M+α | 1610 | 78.1 | n/a |
| Donut | train | ✗ | 176M | 782 | 67.5 | 72.1 |
| LayoutLMv2-Large-QG | train+dev+QG | ✓ | 390M+α | 1698 | 86.7 | 67.3 |
OCR 없이 준수한 점수. 특히 손글씨 문서에서 OCR 의존 모델을 역전(72.1 vs 67.3) — OCR이 약한 영역에서 OCR-free의 강점이 드러남. 반대로 큰 이미지의 작은 글자는 해상도 제약으로 놓치는 한계도 정직하게 보임(Fig. 6: 다른 숫자를 추출).
3.4 Further Studies (ablation)
- 사전학습 전략(Fig. 7a): “텍스트 읽기”가 가장 효과적. 이미지 캡셔닝 등은 거의 도움 안 됨. IE엔 합성(SynthDoG)만으로 충분하나, DocVQA는 실제 이미지가 중요(IIT-CDIP와 DocVQA의 분포 유사성 때문).
- 인코더 백본(Fig. 7b): EfficientNetV2·Swin이 우수. 확장성 때문에 Swin 채택.
- 입력 해상도(Fig. 7c): 클수록 성능 급상승, 특히 작은 글자 많은 DocVQA에서 뚜렷. 단 비용 증가. → OCRBench의 “해상도=성능”이 OCR-free 생성 모델에서도 그대로 재현됨.
- 텍스트 위치(Fig. 8): 위치 지도 없이 학습했는데도 디코더 cross-attention이 해당 글자 영역을 정확히 주목 — 읽기 학습이 암묵적 정렬을 만든다는 증거.
- OCR 엔진 의존(Fig. 9): OCR 기반 모델의 속도·정확도가 어떤 OCR 엔진을 쓰느냐에 극단적으로 좌우됨(EasyOCR·Paddle·MSAzure·CLOVA 편차 큼). Donut은 그 변수 자체가 없음.
- 저자원(Fig. 9 우): Donut은 80 샘플(데이터 10%)만으로 LayoutLMv2를 능가. 고해상도(2560×1920)가 극저자원에서 특히 강건.
4. 한계 및 비판
1) 해상도–비용 trade-off (구조적 약점) 작은 글자를 보려면 2560×1920 같은 고해상도가 필요한데, 원본 Transformer의 제곱 attention 비용이 폭증함(RVL-CDIP 사전학습에 A100 64장으로 2 GPU day). 저자도 efficient attention으로 풀 수 있음을 알지만 “단순성”을 위해 쓰지 않았다고 밝힘 — 이게 곧 OCRBench가 진단하고 DocOwl2(압축)·MinerU2.5(요소 잘라내기) 가 공략하는 “고해상도 → 토큰 폭증” 문제임. Donut은 그 문제를 미해결로 남긴 채 떠안고 있음.
2) 자기회귀 생성의 대가 — 느림·구조오류·환각 디코더가 토큰을 한 개씩 생성하므로 긴 출력에서 느리고, [END] 누락 같은 구조 깨짐 시 필드 통째 손실, 그리고 이미지에 없는 값을 그럴듯하게 만들어내는 환각(Fig. 6에서 엉뚱한 숫자 추출, Fig. C에서 50,000→56,000 오생성)이 발생함. 추출형(LayoutLMv3)이 원천적으로 피하는 위험을 생성형은 안고 감.
3) “OCR-free”는 추론 한정 — 학습은 OCR에 기댐 IIT-CDIP의 pseudo 라벨을 상용 CLOVA OCR로 뽑아 사전학습함. 즉 추론 파이프라인에서 OCR이 없을 뿐, 학습 신호의 출처는 여전히 OCR 엔진임. 합성(SynthDoG)으로 일부 줄이지만, 영어 실문서 읽기 능력의 상한은 그 OCR 라벨 품질에 묶임 — “완전한 OCR 독립”은 아님.
4) 합성–실제 분포 격차 SynthDoG는 IE엔 충분했지만 DocVQA엔 실제 이미지가 필요했음. 합성으로 다국어 확장이 쉬워졌다는 장점의 이면에, 자연 문서 특유의 분포(촬영 왜곡·복잡 레이아웃·질의 다양성)는 합성만으론 못 메운다는 한계가 같이 드러남.
5) DocVQA 절대 성능은 뒤짐 헤드라인만 보면 LayoutLMv2-Large-QG(86.7)에 한참 밀림(67.5). 그쪽이 추가 QG 데이터를 쓴 차이지만, 생성형·OCR-free가 빽빽한 텍스트 추론에서 아직 추출형 OCR 모델에 못 미친다는 당시의 현실도 함께 보여줌. 강점(손글씨·속도·다국어·저자원)과 약점(고밀도 텍스트 정밀도)이 명확히 갈림.
6) 고정 max length·고정 해상도 디코더 max length 1536, 입력 2560×1920 고정. 매우 길거나 빽빽한 다페이지 문서는 길이 초과·미세 글자 누락에 취약 — 이후 모델들의 동적 해상도(NaViT)·다페이지 처리와 대비되는 지점.
5. 결론
1) 핵심 기여는 “OCR을 없애고 생성으로 통일” — 최초의 end-to-end OCR-free VDU 이미지에서 곧장 JSON을 생성하는 Transformer 인코더-디코더로, OCR의 비용·경직성·오류전파를 원천 제거함. 분류·IE·VQA를 전부 JSON 예측 하나로 통일하고, 분류·IE에서 OCR 의존 SOTA를 더 적은 파라미터·더 빠른 속도로 능가함. 생성형 문서 모델의 실용적 가능성을 처음 입증한 논문임.
2) 설계 핵심은 “읽기로 사전학습, 이해로 미세조정 + 합성 데이터” pseudo-OCR(읽기)로 시각 언어모델을 만들고, 그 위에 task별 이해를 생성으로 얹는 2단 구조가 본질. ablation이 보여주듯 읽기 사전학습이 핵심이고(캡셔닝은 무의미), SynthDoG가 OCR 엔진 재학습 없이 다국어 확장을 가능케 함. 위치 감독 없이도 cross-attention이 글자 영역을 정확히 주목한다는 점이 읽기 사전학습이 암묵적 정렬까지 만든다는 근거임.
3) 계보에서의 위치 — OCR-free 생성 노선의 분기점 같은 2022년 LayoutLMv3가 OCR+인코더+추출의 길을 완성했다면, Donut은 OCR 제거+디코더+생성의 반대 길을 엶. 당장의 벤치 숫자(특히 DocVQA)는 추출형에 밀렸지만, LLM-VLM 시대의 문서 모델은 결국 Donut 쪽 — OCR-free, 생성형, 구조화 출력(JSON→Markdown) — 으로 수렴함. DocOwl2의 자유 생성 이해도, MinerU2.5·PaddleOCR-VL의 Markdown 파싱도, 그 뿌리에 “읽기로 배우고 이해를 생성한다”는 Donut의 발상이 있음. 다만 Donut이 미뤄둔 숙제 — 해상도↔토큰 비용, 환각, 학습 단계의 OCR 의존 — 가 그대로 다음 세대의 과제 목록이 됨. 문서를 “읽어서 생성하는” 패러다임의 첫 칸으로 읽으면 이후 흐름이 자연스럽게 이어짐.
배경 개념 정리
VDU (Visual Document Understanding) 문서 이미지에서 정보를 이해·추출하는 task 전반. 분류(문서 종류 맞히기), 정보추출(IE, 키-값/구조 뽑기), 문서 VQA(질문 답하기)를 포함. 전통적으로 “OCR로 읽기 → 언어모델로 이해”의 2단계로 풀렸음.
OCR-free / end-to-end 별도 OCR 엔진 없이, 원시 이미지를 입력받아 최종 출력까지 한 모델이 직접 매핑하는 방식. OCR의 비용·언어 경직성·오류전파를 피하지만, 글자 읽기 능력까지 모델이 스스로 학습해야 함. Donut의 “OCR-free”는 추론 시점 기준(사전학습 라벨은 OCR로 만듦)이라는 점에 주의.
Pseudo-OCR 사전학습 이미지 속 모든 글자를 읽기 순서로 예측(다음 토큰)하게 하는 자기지도 사전학습. 디코더가 이미지를 보며 글자를 생성하므로, 외부 OCR 없이 “읽기” 능력을 모델 안에 내재화함. LayoutLMv3의 MLM/MIM(가리고 복원, 인코더형)과 달리, Donut은 자기회귀 생성형 읽기라는 점이 갈림.
Swin Transformer / BART Swin은 shifted-window self-attention과 patch merging으로 계층적 시각 표현을 만드는 비전 Transformer(여기선 인코더). BART는 denoising seq2seq로 사전학습된 인코더-디코더 언어모델(여기선 다국어 mBART로 초기화한 디코더). 둘을 이어 “이미지 인코딩 → 토큰 생성” 구조를 구성.
TED 기반 정확도 (Tree Edit Distance) 예측 JSON과 정답 JSON을 트리로 보고, 트리 편집거리로 구조 일치도를 잰 지표. max(0, 1−TED(pr,gt)/TED(ϕ,gt))로 계산. 필드 단위 F1이 못 잡는 그룹·중첩 계층의 정확성까지 평가해, 단순 읽기와 구조 이해를 함께 측정함.
ANLS (Average Normalized Levenshtein Similarity) DocVQA 표준 지표. 예측 답과 정답의 편집거리 기반 부분 점수라, 생성형 모델의 약간 다른 표기에 관대함. exact match보다 생성형 출력 평가에 적합.
SynthDoG (Synthetic Document Generator) 배경·종이텍스처·텍스트·레이아웃을 규칙적으로 조합하고 렌더링 노이즈를 입혀 가짜 문서 이미지를 무한 생성하는 도구. 언어별 Wikipedia만 있으면 다국어 사전학습 데이터를 만들 수 있어, OCR 엔진 재학습 없이 언어 확장을 가능케 함. LayoutLMv3 등이 의존하던 실문서 코퍼스(IIT-CDIP) 부담을 줄이는 대안.