LayoutLMv3
LayoutLMv3: Pre-training for Document AI with Unified Text and Image Masking
Authors: Yupan Huang, Tengchao Lv, Lei Cui, Yutong Lu, Furu Wei (Sun Yat-sen University, Microsoft Research Asia) — arXiv 2204.08387, ACM MM 2022.
사전학습(pre-training) 논문임. 앞서 본 논문들보다 한 세대 앞선 2022년 작업으로, LLM 기반 VLM이 본격화되기 전의 인코더형 멀티모달 모델 계보(LayoutLM 시리즈)에 속함. 핵심 위치: 오늘날 거의 모든 문서 모델이 당연하게 쓰는 두 가지 — CNN/검출기 없이 이미지를 선형 패치로 임베딩하는 방식, 그리고 텍스트·이미지를 같은 방식(마스킹 복원)으로 사전학습하는 통합 목적함수 — 의 원형을 깐 논문임. DocOwl2의 “패치 토큰”도, ColPali가 기대는 “패치 단위 텍스트-이미지 정렬”도, 그 뿌리에 이 계열의 발상이 있음.
1. 문제 정의
핵심 문제
텍스트와 이미지 두 모달리티를 일관된 방식으로 사전학습해, 문서 AI 전반에 쓰이는 범용 표현을 배우는 것이 핵심 문제임.
문서 AI에서 self-supervised 사전학습은 큰 성과를 냈음. 그런데 대부분의 멀티모달 모델이 텍스트는 BERT의 MLM(마스킹된 단어 복원)으로 학습하면서, 이미지 쪽 목적함수는 제각각임. 이 불일치가 멀티모달 표현 학습을 어렵게 만듦. 텍스트(이산 토큰)와 이미지(조밀한 픽셀 또는 연속 region feature)의 입자 크기가 다르면, 둘을 잇는 cross-modal 정렬이 더 어려워짐.
기존 연구의 한계
이미지를 어떻게 임베딩하고 어떻게 사전학습하느냐에서 갈림.
1) Region feature 방식 (SelfDoc, UDoc, 초기 LayoutLM 등) Faster R-CNN 같은 검출기로 영역(region) feature를 뽑음. 무거운 검출기 연산이 병목이고, region 주석(supervision)이 필요함. SelfDoc류는 마스킹된 region feature를 회귀(regression)로 복원하는데, 연속값이라 작은 사전(vocabulary)에서 이산값을 분류하는 것보다 노이즈가 많고 학습이 어려움.
2) CNN grid feature 방식 (LayoutLMv2, DocFormer 등) 검출기는 없애되 CNN으로 grid feature를 뽑음. 여전히 CNN 연산 비용이 듦. DocFormer는 픽셀을 CNN 디코더로 복원하는데, 문서 레이아웃 같은 고수준 구조보다 노이즈 디테일을 학습하는 경향이 있음.
3) 통합되지 않은 목적함수 정리하면 텍스트는 “이산 토큰 분류”인데 이미지는 “픽셀 복원” 또는 “region 회귀”라, 두 모달의 학습 신호가 비대칭임. 이 비대칭이 cross-modal 정렬 학습을 방해하는 게 미해결 과제임.
2. 제안 방법: LayoutLMv3
세 가지 자기지도 목적함수 — MLM·MIM·WPA — 로 텍스트와 이미지를 대칭적으로 사전학습하는 통합 멀티모달 Transformer임. CNN 없이 동작하는 첫 문서 AI 멀티모달 모델.
2.1 핵심 아이디어
이미지도 텍스트처럼 다룬다 — 패치를 선형 임베딩하고, 텍스트와 똑같이 “마스킹 후 이산 토큰 복원”으로 학습한다.
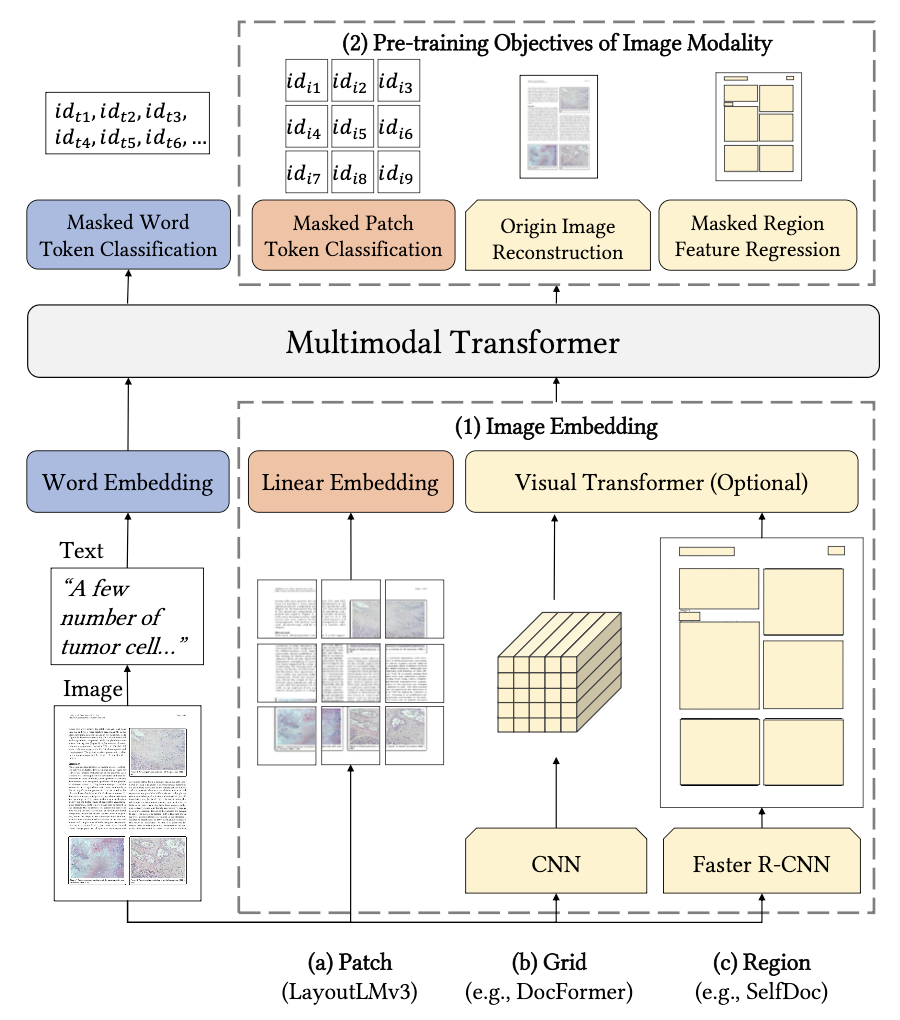
위 그림이 이 논문의 두 갈래 선택을 한눈에 보여줌. 아래쪽은 이미지 임베딩 방식 — LayoutLMv3는 검출기·CNN이 필요한 Region(SelfDoc)·Grid(DocFormer) 대신 가장 가벼운 (a) Patch를 택함. 위쪽은 이미지 모달 목적함수 — region feature 회귀나 픽셀 복원 대신 텍스트의 Masked Word Token Classification과 대칭인 Masked Patch Token Classification(MIM)을 택함.
텍스트를 마스킹해 단어 토큰을 복원하듯(MLM), 이미지를 마스킹해 패치 토큰을 복원함(MIM). 둘 다 “이산 토큰을 분류하는” 같은 형식이라 모달 간 비대칭이 사라짐. 여기에 문서 특유의 성질 — 각 단어가 특정 이미지 패치에 대응한다 — 을 살려, 단어와 그 패치의 정렬을 직접 학습하는 WPA를 더함.
이 발상이 이후 계보로 어떻게 이어지는지가 핵심임. ViT/ViLT에서 따온 “검출기 없는 선형 패치 임베딩”은 DocOwl2·PaddleOCR-VL이 쓰는 NaViT/ViT 패치 입력의 직계 조상임. 그리고 “패치를 텍스트 토큰과 같은 공간에서 다룬다”는 통합 마스킹의 정신은, ColPali에서 “패치와 질의 텍스트를 같은 의미 공간에서 매칭한다”로, DocOwl2에서 “V2T 뒤 정렬된 토큰을 압축한다”로 변주됨. 다만 LayoutLMv3는 생성형 LLM 이전 시대의 인코더 모델이라, 출력이 토큰 라벨·QA 스팬이지 자유 생성 텍스트는 아님.
2.2 아키텍처
텍스트와 이미지 임베딩을 이어붙여(concatenate) 하나의 멀티모달 Transformer에 넣음.
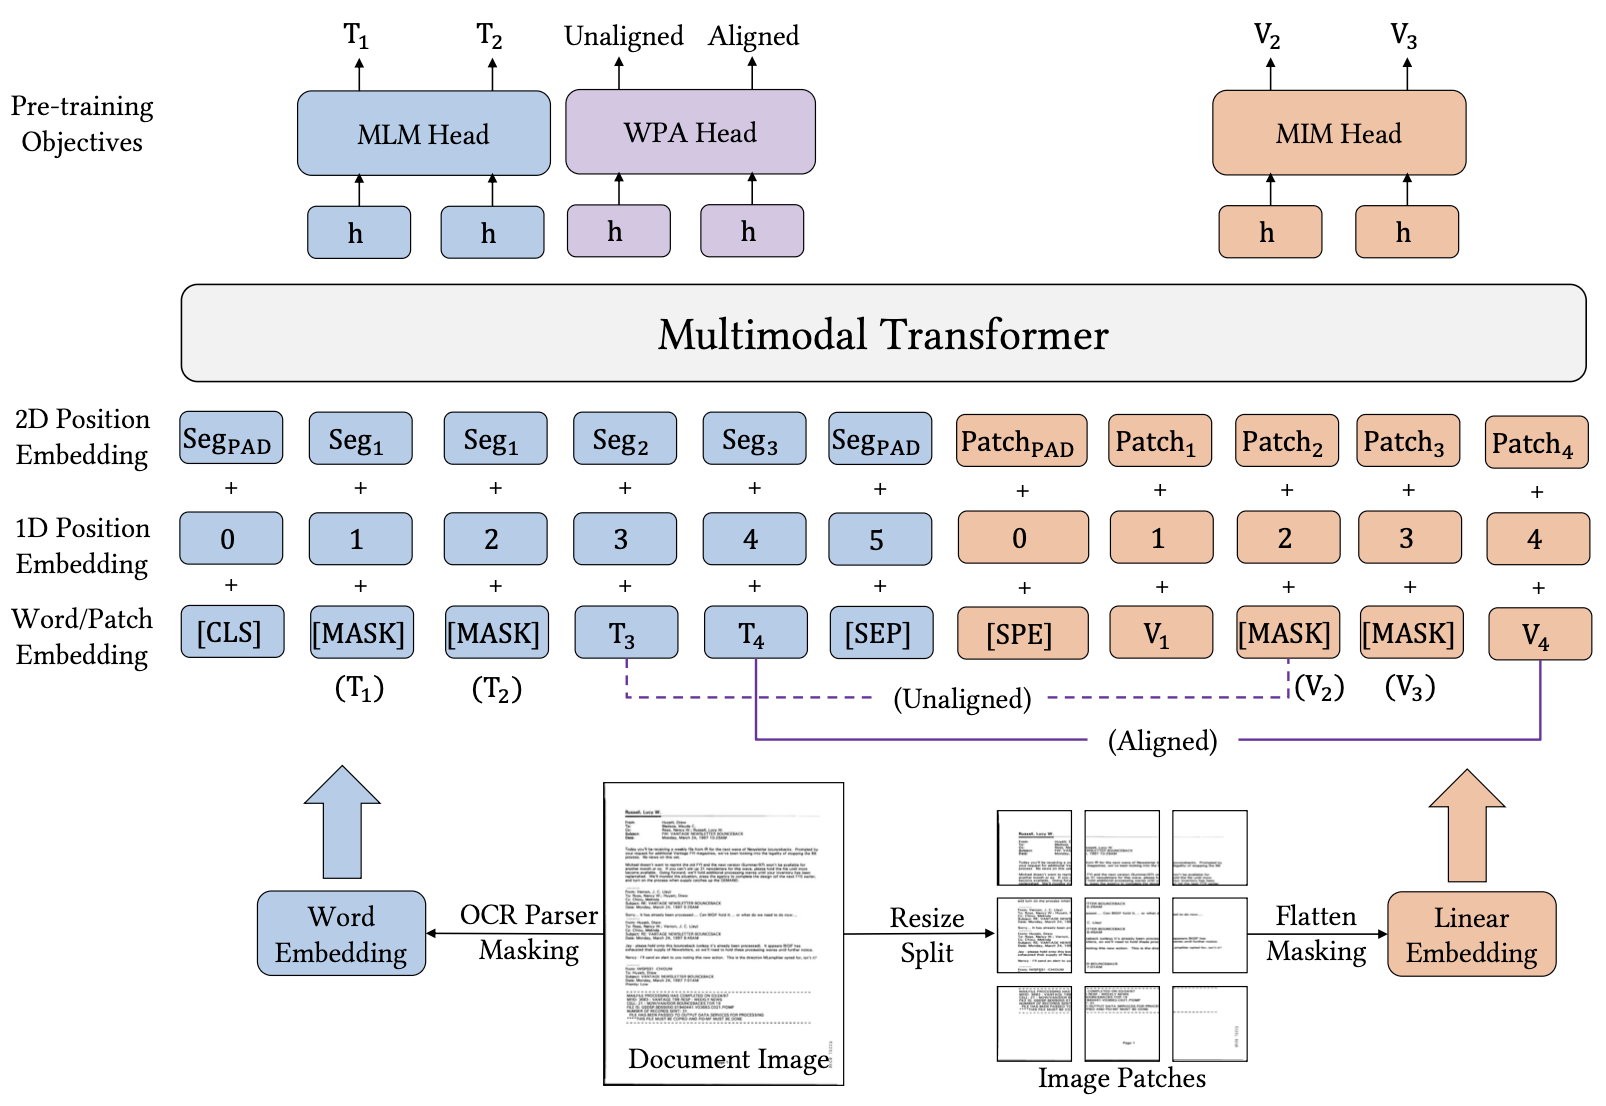
그림 왼쪽은 OCR 파서로 뽑은 단어를 Word Embedding으로, 오른쪽은 리사이즈·분할한 패치를 Linear Embedding으로 넣는 흐름임. 두 시퀀스가 같은 Multimodal Transformer를 통과하고, 위에서 MLM·WPA·MIM 헤드가 각각 마스킹된 단어·단어-패치 정렬·마스킹된 패치를 맞힘. 1D/2D 위치 임베딩이 텍스트와 패치에 공통으로 붙는 것도 보임.
| 구성요소 | 내용 |
|---|---|
| 텍스트 임베딩 | off-the-shelf OCR로 단어·2D 좌표 추출. RoBERTa 가중치로 초기화. 1D 위치 + segment 단위 2D 레이아웃 위치(한 세그먼트 내 단어가 같은 좌표 공유) |
| 이미지 임베딩 | 문서를 H×W로 리사이즈 → P×P 패치로 분할 → 선형 사영(CNN·검출기 없음). 학습 가능한 1D 위치 임베딩 추가 |
| Transformer | 텍스트·이미지 시퀀스를 합쳐 입력. self-attention에 1D/2D 상대위치 bias 추가(LayoutLMv2 방식) |
핵심 차별점: CNN/Faster R-CNN 백본을 완전히 제거함. 16×16 패치 선형 사영은 파라미터 0.6M에 불과해 ResNet-101(44M) 대비 무시 가능한 수준이고, region 주석도 필요 없음.
2.3 세 가지 사전학습 목적함수
전체 손실은 L = L_MLM + L_MIM + L_WPA.
① MLM (Masked Language Modeling) 텍스트 토큰 30%를 span 마스킹(Poisson λ=3)하고 주변 문맥으로 복원함. 레이아웃 정보는 그대로 두어, 모델이 레이아웃-텍스트-이미지 문맥의 대응을 배우게 함.
② MIM (Masked Image Modeling) 이미지 패치 약 40%를 블록 마스킹하고, 마스킹된 패치의 이산 토큰을 복원함. 라벨은 DALL-E/BEiT식 image tokenizer(이산 VAE, vocabulary 8,192)가 픽셀을 이산 토큰으로 바꿔 제공함. 픽셀이 아니라 이산 토큰을 맞히므로 노이즈 디테일이 아닌 고수준 레이아웃 구조를 학습함. MLM과 완전 대칭.
③ WPA (Word-Patch Alignment) MLM·MIM이 각자 마스킹하다 보니 둘 사이 명시적 정렬 학습이 없음. WPA는 한 텍스트 단어에 대응하는 이미지 패치가 마스킹됐는지 아닌지(aligned/unaligned)를 이진 분류로 맞힘. 마스킹된 텍스트 토큰은 손실 계산에서 제외해, 마스킹된 단어-패치 간 가짜 대응 학습을 방지함. MIM의 마스킹 연산을 그대로 재활용해 정렬 쌍을 만듦.
3. 실험 결과
IIT-CDIP 1,100만 문서로 사전학습(RoBERTa로 텍스트 초기화, DiT tokenizer로 이미지 토크나이저 초기화). 텍스트 중심 3개 + 이미지 중심 2개 벤치에서 평가.
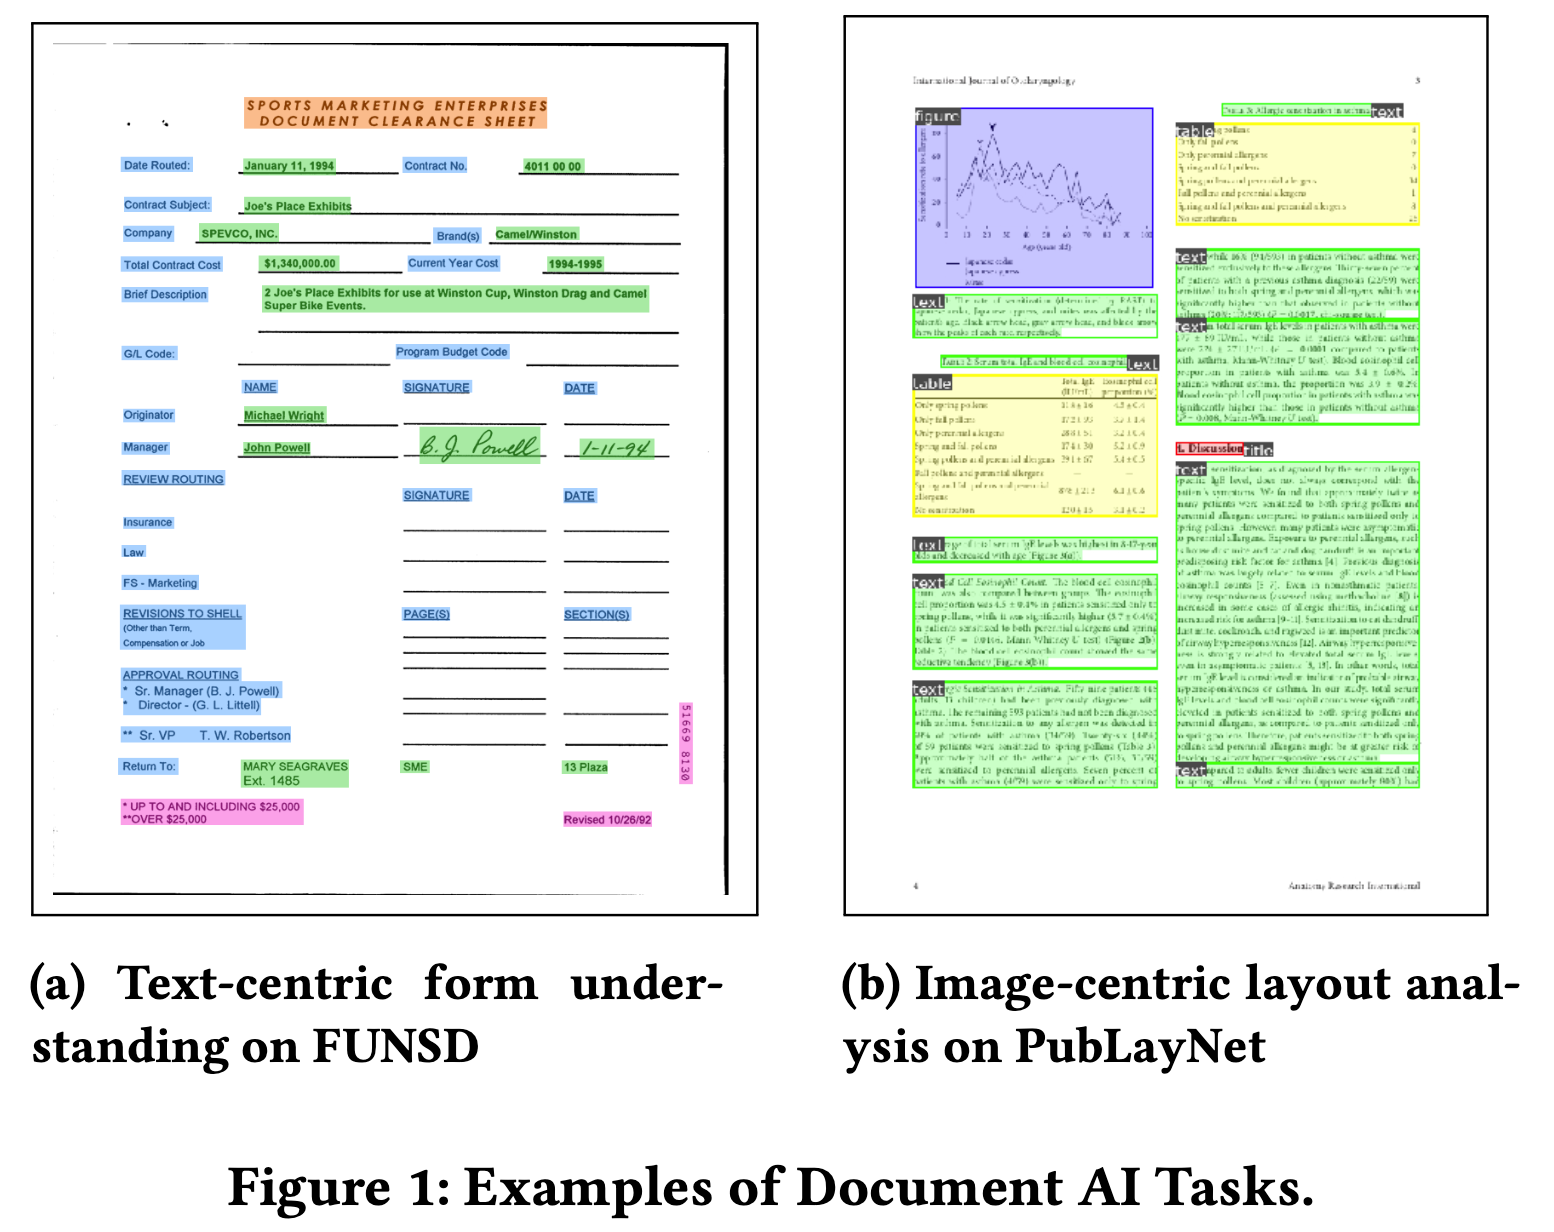
평가 task는 크게 두 갈래임. (a) FUNSD처럼 단어·필드를 읽어 키-값을 묶는 텍스트 중심 task와, (b) PubLayNet처럼 영역을 박스로 검출하는 이미지 중심 task. LayoutLMv3는 둘 다 한 모델로 커버함.
3.1 텍스트 중심 task
| Task | 데이터셋 | 지표 | LayoutLMv3_LARGE | 종전 SOTA |
|---|---|---|---|---|
| 양식 이해 | FUNSD | F1 | 92.08 | 85.14 (StructuralLM) |
| 영수증 KIE | CORD | F1 | 97.46 | 96.99 (DocFormer) |
| 문서 VQA | DocVQA | ANLS | 83.37 | 83.94 (StructuralLM)* |
FUNSD에서 7점 가까이 큰 폭으로 앞섬(단, segment 단위 좌표를 쓴 StructuralLM과는 직접 비교 주의). DocVQA는 추가 QA 데이터·검증셋을 쓴 모델과 동률 수준. base 모델은 ResNeXt101-FPN을 쓰는 LayoutLMv2보다 단순한 선형 임베딩으로 더 적은 파라미터로 동급 이상을 냄(133M vs 200M).
3.2 이미지 중심 task
| Task | 데이터셋 | 지표 | LayoutLMv3 | 비고 |
|---|---|---|---|---|
| 문서 이미지 분류 | RVL-CDIP | Acc | 95.93 | LayoutLMv2 대비 +0.29, 더 단순한 임베딩 |
| 레이아웃 분석 | PubLayNet | mAP | 95.1 | DiT(94.5)·ResNet 백본 전부 상회 |
레이아웃 분석은 텍스트 임베딩 없이 비전 모달만 써서 object detection으로 푸는데도 SOTA임. 특히 ‘Title’ 범주에서 큰 이득 — 제목은 작아서 시각만으로 잡기 어렵지만 텍스트적 특성이 강한데, 사전학습에 언어 모달을 넣은 덕이라고 해석함. 멀티모달 Transformer가 순수 비전 task에서도 통한다는 것을 처음 보인 사례라는 게 저자들의 자평.
3.3 Ablation (목적함수의 기여)
이 논문의 가장 단단한 부분임. base, 100만 데이터로 통제.
| # | 이미지 임베딩 | 목적함수 | FUNSD | CORD | RVL-CDIP | PubLayNet |
|---|---|---|---|---|---|---|
| 1 | 없음 | MLM | 88.64 | 96.27 | 95.33 | N/A |
| 2 | Linear | MLM | 89.39 | 96.11 | 95.00 | 발산 |
| 3 | Linear | MLM+MIM | 89.19 | 96.30 | 95.42 | 94.38 |
| 4 | Linear | MLM+MIM+WPA | 89.78 | 96.49 | 95.53 | 94.43 |
읽는 법: ① 텍스트+레이아웃만으로도(#1) 꽤 좋음 → 언어 모달이 문서 이해의 핵심. ② 그런데 선형 패치를 그냥 붙이기만 하면(#2) 일부 task가 오히려 나빠지고 PubLayNet 학습이 발산함 — 이미지 목적함수 없이는 패치 표현을 못 배움. ③ MIM을 넣자(#3) 발산이 해소되고 비전 task가 살아남 → MIM이 비전 task의 필수 안정장치. ④ WPA를 더하면(#4) 모든 task가 일관되게 개선 → cross-modal 정렬이 표현 학습 전반에 도움.
4. 한계 및 비판
1) OCR 의존 — “OCR-free”가 아님 LayoutLMv3는 입력 단계에서 외부 OCR로 단어와 2D 좌표를 먼저 뽑아야 함. 즉 OCR 파이프라인 위에 얹힌 모델임. 이건 이후 DocOwl2·PaddleOCR-VL이 표방하는 “OCR-free”와 정반대 방향이고, OCRBench 리뷰에서 다룬 “전처리 파이프라인 병목”, ColPali가 통째로 건너뛴 그 단계를 여기선 전제로 깔고 있음. 시대적 한계임.
2) 인코더 모델의 task 형식 제약 출력이 토큰 라벨링(시퀀스 태깅)이나 추출형 QA 스팬임. DocVQA를 “답 위치 분류”로 푸는 식이라, 생성형 LLM처럼 자유로운 답·추론·구조화 출력(Markdown/JSON)은 불가능함. 파싱기(MinerU2.5)나 생성형 이해 모델(DocOwl2)과는 출력 패러다임 자체가 다름.
3) image tokenizer 의존 MIM의 라벨이 외부 이산 VAE(DiT tokenizer, vocab 8,192)에서 나옴. 이 토크나이저 품질이 MIM 신호의 상한을 정하는데, 별도 사전학습 모듈이라 통제 밖이고 파라미터 계산에서도 빠져 있음. “텍스트처럼 이산 토큰 복원”이라는 설계의 이면에 외부 토크나이저 의존이 있음.
4) 고정 해상도·1D 위치 224×224 고정 입력에 패치 196개. 2D 위치 임베딩은 예비 실험에서 이득이 없어 1D만 씀. 빽빽하거나 큰 문서의 미세 글자에는 불리하고, 이 해상도 한계가 곧 OCRBench가 진단한 “해상도가 곧 성능”이라는 다음 과제로 이어짐. 이후 모델들의 동적 해상도(NaViT)와 대비되는 지점.
5) 비교의 미묘함 (저자 인정) FUNSD의 큰 격차는 segment 단위 좌표 덕이 큼(word 단위 쓰는 모델과 직접 비교 불가). DocVQA SOTA들은 추가 QA 데이터를 씀. 표의 헤드라인 숫자를 곧이곧대로 동일 조건 비교로 읽으면 안 됨.
5. 결론
1) 핵심 기여는 “이미지를 텍스트처럼” — 통합 마스킹 + 검출기 제거 텍스트(MLM)와 이미지(MIM)를 같은 “이산 토큰 복원” 형식으로 대칭 학습하고, WPA로 단어-패치 정렬을 명시적으로 배움. 동시에 CNN/Faster R-CNN을 선형 패치 임베딩으로 대체해 파라미터와 region 주석을 동시에 없앰. 텍스트 중심·이미지 중심 task 모두에서 SOTA를 낸 첫 범용 문서 멀티모달 모델임.
2) 설계 핵심은 모달 간 형식 통일 “입자 크기가 다른 두 모달을 같은 학습 신호로 맞춘다”가 본질임. ablation이 보여주듯, 선형 패치만으로는 부족하고(발산) MIM이 비전 표현을 안정화하며 WPA가 정렬을 마무리함. 이 통합 목적함수 설계가 단순함과 성능을 동시에 가져온 비결임.
3) 계보에서의 위치 — 패치 시대의 출발점 오늘 본 네 논문이 당연하게 전제하는 것들의 원형이 여기 있음. 검출기 없는 선형 패치 입력(→ DocOwl2·PaddleOCR-VL의 ViT/NaViT), 패치를 텍스트와 같은 공간에서 다루는 발상(→ ColPali의 패치-질의 정렬, DocOwl2의 의미 공간 정렬), 그리고 OCRBench가 진단할 “OCR/해상도 병목”을 아직 OCR 전제 위에서 안고 있던 단계. 인코더·OCR 의존이라는 시대적 제약은 분명하지만, 문서를 “텍스트처럼 다루는 패치”로 보기 시작한 전환점으로 읽으면 이후 흐름이 한 줄로 꿰임.
배경 개념 정리
MLM / MIM (Masked Language/Image Modeling) 입력의 일부를 가리고 주변 문맥으로 복원하게 하는 자기지도 학습. MLM은 BERT가 텍스트에 도입했고, MIM은 BEiT가 이미지에 적용해 “마스킹된 패치의 이산 토큰”을 맞히게 함. LayoutLMv3는 이 둘을 한 모델에서 대칭으로 돌려 모달 간 학습 신호를 통일함.
이산 image tokenizer (discrete VAE) DALL-E/BEiT 계열에서 쓰는, 이미지 픽셀을 유한한 시각 사전(여기선 8,192개)의 이산 토큰으로 바꾸는 모듈. 픽셀을 직접 복원하면 노이즈 디테일에 끌려가지만, 이산 토큰을 분류로 맞히면 고수준 구조를 학습하게 됨. MIM의 정답 라벨 공급원임.
WPA (Word-Patch Alignment) 문서에서 단어 하나가 특정 이미지 패치에 대응한다는 성질을 이용해, 그 패치가 마스킹됐는지를 이진 분류로 맞히는 목적함수. 텍스트-이미지 cross-modal 정렬을 명시적으로 학습시키는 장치로, MIM의 마스킹을 재활용해 정렬 쌍을 만든다.
Segment 단위 vs word 단위 레이아웃 위치 2D 좌표(bounding box)를 단어마다 따로 주느냐(word), 같은 의미 단위(세그먼트=줄/문단) 내 단어들이 공유하느냐(segment)의 차이. segment 단위는 같은 의미를 가진 단어들을 묶어줘 양식 이해(FUNSD) 같은 task에 유리하지만, 그래서 word 단위 모델과 직접 비교하기 어렵다.
Region / Grid / Patch 이미지 임베딩 문서 이미지를 인코딩하는 세 방식. region은 검출기로 객체 영역을 뽑고(무겁고 주석 필요), grid는 CNN으로 격자 feature를 뽑고(CNN 비용), patch는 이미지를 균일 격자로 잘라 선형 사영함(가장 가볍고 검출기·CNN 불필요). LayoutLMv3가 문서 AI에서 patch 방식을 처음 도입했고, 이후 거의 모든 비전 문서 모델의 표준이 됨.
부록: WPA 문답 (2026-07-05)
WPA를 뜯어보며 걸린 지점들을 문답으로 정리함. 결론부터: 이 목적함수의 강점(주석 0 라벨)과 한계(기하적 정렬에 그침)는 같은 설계 결정 — 좌표를 입력으로 주고 MIM 마스크를 재활용한 것 — 의 양면임.
Q1. “정렬을 명시적으로 학습한다”는데, 정렬 라벨은 어디서 나오나? 주석 비용 없이 성립하는 구조인가? 별도 데이터를 만들지 않음. 라벨이 매 스텝 이미 있는 재료 둘에서 공짜로 생성됨 — ① OCR이 어차피 입력으로 주는 단어 bbox(좌표를 패치 크기로 나누면 단어→패치 매핑이 나오는 순수 기하 연산), ② MIM이 그 스텝에 내린 마스킹 결정. 단어가 사는 패치가 마스킹됐으면 unaligned, 아니면 aligned. MLM으로 가려진 텍스트 토큰은 loss에서 제외함(정체불명 [MASK] 토큰 ↔ 패치의 가짜 대응 학습 방지). 추가 파라미터는 이진 분류기 하나(CE, L에 합산). 단 한 단어가 여러 패치에 걸칠 때의 aligned 판정 기준은 원문에 미명시 — 구현 확인 필요.
Q2. 순환 아닌가 — “이 단어의 패치가 가려졌나”를 맞히려면 단어↔패치 대응을 이미 알아야 하는데, 그 대응이 바로 학습하려는 대상임. 순환처럼 보이지만 아님 — 대응의 씨앗이 입력에 이미 있음. 텍스트 토큰은 2D 레이아웃 임베딩으로 자기 좌표를, 패치는 위치 임베딩으로 자기 자리를 받으므로, 문제가 “의미 대응의 발견”이 아니라 좌표 대조 + 그 자리를 attention으로 읽어오기로 환원됨. 뒤집으면 이게 첫 번째 한계 진단이기도 함: WPA가 가르치는 정렬은 기하적(geometric)이지 의미적(semantic)이 아님 — 좌표라는 커닝페이퍼를 쥐여준 채 그 자리를 확인하는 법을 가르치는 구조라, “TOTAL이라는 글자의 시각적 생김새”를 이해할 필요가 없음. (대비: ColPali의 질의 토큰 “hour” ↔ 페이지 속 “hourly” 글자 패치 매칭은 좌표 없이 성립하는 의미적 정렬 — 층위가 다름.)
Q3. 그럼 CLIP류 이미지-텍스트 정렬과는 뭐가 근본적으로 다른가? 텍스트의 정체가 다름. CLIP의 텍스트는 이미지에 대한 설명(캡션)이라 단어-위치 대응이라는 게 애초에 존재하지 않지만, 여기의 텍스트는 같은 페이지의 OCR 전사(transcription)라 단어 하나하나가 픽셀 위 좌표를 가짐. 모델은 같은 문서를 두 뷰(전사 토큰+bbox / 픽셀 패치)로 동시에 받고, 사전학습 설계의 본체가 “한 뷰를 가리고 다른 뷰로 복원할 길 열어두기”임 — MLM이 단어를 가려도 패치엔 인쇄돼 있고, MIM이 패치를 가려도 토큰은 남음. “단어마다 대응 패치가 존재한다”는 WPA의 전제 자체가 전사이기에 성립함.
Q4. 마스킹 판별은 자명한 문제 아닌가 — 마스킹된 패치는 mask 임베딩으로 교체돼 있어 보면 바로 아는데, 이런 시시한 신호로 뭘 배운다는 건가? 그 자명함이 설계의 핵심임. 답은 이미지 스트림에 훤히 적혀 있는데 읽을 주소를 모르는 구조라, 어려움이 판별이 아니라 조회(lookup)에 있고, gradient 압력이 전부 “단어 → 자기 패치” 라우팅 학습으로 쏠림. 이게 따로 필요한 이유: MLM·MIM만 돌리면 각 모달이 자기 안에서 복원을 해결할 수 있어(가려진 단어는 주변 단어로, 가려진 패치는 주변 패치로) cross-modal attention이 생길 필연이 없음. WPA는 답이 반대편 모달의 특정 위치에만 있는 문제를 심어 그 다리를 강제하는 pretext task임 — task는 버리는 것, 라우팅이 남는 것.
Q5. “정렬”이라면 레이아웃 이해에 기여해야 할 텐데, ablation의 이득은 레이아웃 task(PubLayNet +0.05)가 아니라 텍스트 task(FUNSD +0.59)에 쏠려 있음. 실제로 뭘 배우고 있는 건가? 그 비대칭이 WPA의 성격을 정확히 드러냄 — 배우는 건 전역이 아니라 국소임. 라벨이 “자기 자리 패치 하나”라 페이지 전체 구조(2단 여부, 표 위치, 제목 위계)를 몰라도 만점이 나오고, 강제되는 attention도 핀포인트 조회지 전역 스캔이 아님. 전역 레이아웃 구조 담당은 MIM(PubLayNet 발산을 막은 것도 MIM). 역할 분담으로 정리하면: 좌표 자체 = 2D 위치 임베딩(입력) / 전역 구조 = MIM / 좌표→국소 시각 정보의 연결 = WPA. 국소 시각 단서는 단어 분류에 도움되는 신호라 이득이 텍스트 중심 task에 쏠리는 것과 정합함.
Q6. 그 국소 시각 정보가 downstream에서 실제로 뭘 푸나 — 그리고 푼다는 근거는 충분한가? 동기는 “텍스트만 보면 동일한 토큰인데, 그 자리의 픽셀을 봐야 갈리는” 경우들임 — ① 동형 토큰의 역할 구분(영수증에 “Total”이 셋: 진짜 합계 라벨은 굵은 글씨·구분선 아래·큰 폰트), ② OCR 전사가 지워버린 시각 속성(굵기·기울임·크기·취소선 — OCR은 글자와 좌표만 줌), ③ 인쇄 vs 손글씨 기입(양식의 예시 텍스트 vs 기입값), ④ 괘선·체크박스처럼 좌표가 말해주지 않는 소속. 단 이건 동기 목록이지 성과 목록이 아님 — 실증은 FUNSD +0.59·CORD +0.19 수준이고, 224×224 해상도에서 볼드 여부가 패치에 남아 있는지도 정당한 의문임. 이 문제들을 본격적으로 푼 건 이후의 고해상도·생성형 모델들임.
Q7. 그래서 KIE에서 WPA의 지분은 정확히 어디까지인가 — 라벨↔값을 묶는 관계 추론까지 WPA 덕으로 읽어도 되나? 안 됨, 사슬을 분해해야 함. 국소 시각 정보의 역할은 동점(세 개의 “Total”)을 깨는 tie-breaker로서 토큰 표현을 분화시키는 것까지고, 이웃 관계 추론(라벨↔값 묶기)은 self-attention + 2D 위치 임베딩이 원래 하던 일임(ablation #1: 이미지 없이도 FUNSD 88.64가 그 증거). 정확한 인과 사슬: 국소 시각 주입(WPA가 통로 제공) → 동형 토큰 표현 분화 → 그 분화된 표현 위에서 관계 추론이 헛짚지 않음. 즉 WPA는 관계 추론의 주체가 아니라 재료 품질을 올리는 전제 조건이고, 그 지분의 실측이 +0.19~0.59라는 것까지가 전체 그림임.