Beyond Human Annotation
Beyond Human Annotation: Recent Advances in Data Generation Methods for Document Intelligence
Authors: Dehao Ying, Fengchang Yu, Haihua Chen, Changjiang Jiang, Yurong Li, Wei Lu (Wuhan University, University of North Texas) — arXiv 2601.12318, 2026년 1월.
서베이(survey) 논문임. 모델이 아니라 그 모델들이 먹는 학습 데이터를 어떻게 만드느냐를 다룸. 문서 AI(DI) 전반의 데이터 생성 기법을 기법이 아니라 “데이터·라벨 가용성”이라는 자원(resource) 축으로 처음 재편한 분류 체계임. 앞서 본 논문들(LayoutLMv3·ColPali·DocOwl·Donut·DiT·UDOP 등)이 죄다 이 지도 안에 좌표로 박힘. 본체는 방법론 자체가 아니라 “언제 무엇을 쓸지”의 분류임.
1. 문제 정의
핵심 문제
문서 AI의 대규모·고품질 학습 데이터를 수작업 주석 없이(non-manual) 어떻게 확보할 것인가, 그리고 그 무수한 방법들을 어떤 틀로 정리해 의사결정에 쓸 것인가가 핵심 문제임.
DI는 저수준 지각(레이아웃 분석)부터 고수준 인지(DocVQA)까지 걸친 분야로, 두 흐름 — ① Transformer 기반 전용 파운데이션 모델(LayoutLM·DiT·Donut·UDOP), ② 범용 LLM의 DI 적용 — 모두 방대한 고품질 데이터에 의존함. 그런데 DI 데이터는 일반 CV·NLP보다 요구가 까다로움: (1) 본질적 멀티모달(시각·텍스트·레이아웃의 상호작용에서 의미 발생), (2) 세밀한 task별 주석(word 단위 bbox, KIE 라벨, DocVQA 삼중쌍), (3) 다양성 요구(타입·레이아웃·언어·품질). 수작업 주석은 비용·시간·도메인 전문가 의존·롱테일/프라이버시 미커버로 병목임. 그 결과 데이터 생성 연구가 급증(Scopus 2021–2025가 2016–2020 대비 약 3배).
기존 서베이의 한계
이 논문이 자신을 정당화하는 지점이며, 4가지로 정리함.
| # | 한계 | 내용 |
|---|---|---|
| 1 | 도메인 특정성 | DI 전체를 다룬 종합 서베이 부재. 단일 모달(텍스트 증강)·단일 task(분류)에 파편화 → 문서의 멀티모달 본질을 못 담고 기법 이전을 막음 |
| 2 | 분류 근거 | 기존 종합 서베이는 대부분 기법별 정리. 이론상 깔끔하나 “라벨 없는 스캔 더미를 어떻게 쓰지?” 같은 자원 제약형 의사결정엔 무용 — 같은 자원 상황의 해법이 기술 챕터마다 흩어짐 |
| 3 | 범위 완전성 | “데이터 생성”을 거의 항상 “지도학습용 labeled 샘플 생성”으로 좁게 봄. 자동 주석·자기지도 신호 구성을 통째로 누락 |
| 4 | 평가 깊이 | 생성 데이터 품질의 체계적 다층 평가 틀 부재. 다운스트림 성능 = 데이터 품질로 단순 등치 |
정리하면 자원 중심·task 무관(task-agnostic) 분류 + “데이터 생성”의 확장 정의 + 다층 평가 틀이 통째로 비어 있던 게 미해결 과제임.
2. 제안 방법: 자원 중심 분류 체계 (Taxonomy)
데이터 생성을 “supervisory signal 생산”으로 재정의하고, “데이터·라벨의 가용성”을 축으로 모든 방법을 4 패러다임으로 가르는 통합 결정 지도임. 이후 본문을 task가 아니라 이 자원 패러다임 순으로 짜서 정보 사일로를 깨고 기술 이전을 촉진하는 게 설계 의도임.
2.1 핵심 아이디어
“무슨 기법이냐”가 아니라 “내가 지금 데이터·라벨을 얼마나 가졌느냐”로 방법을 고른다.
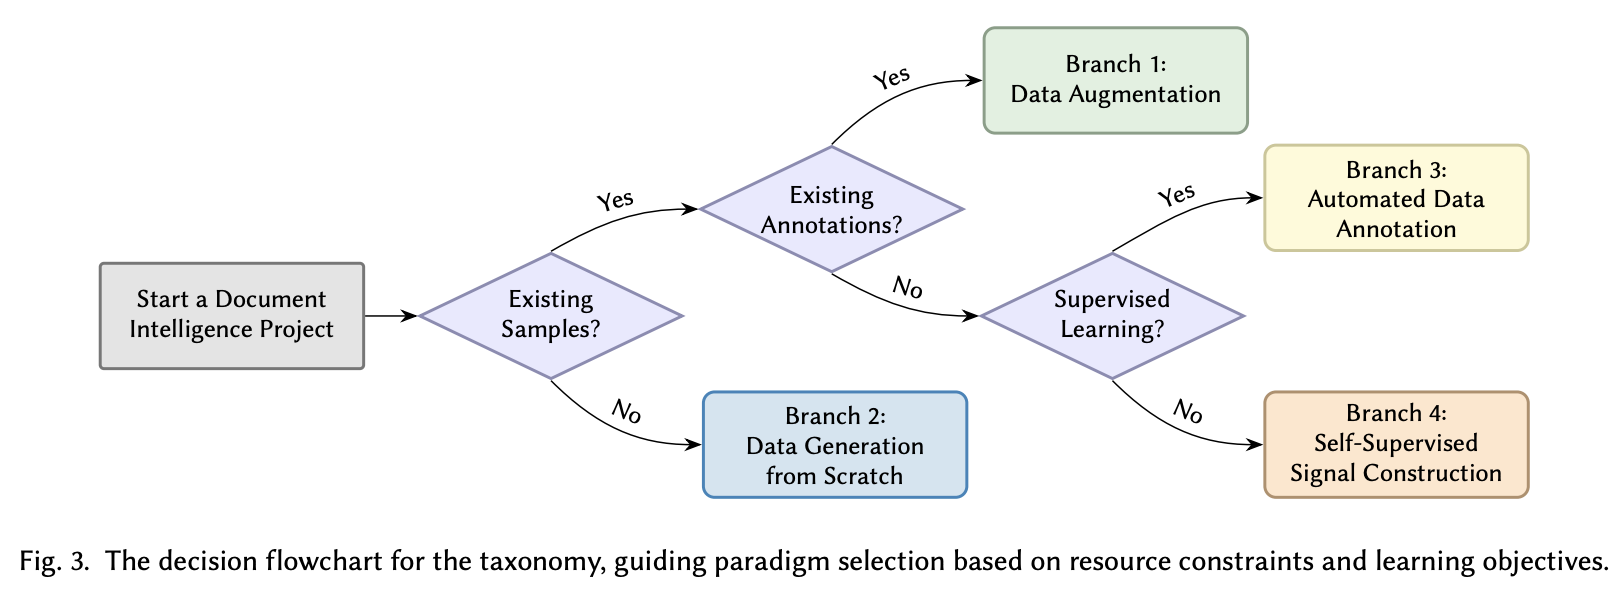
문서 공간 X, 라벨 공간 Y에 대해 초기 자원 집합 R에서 학습셋 D를 얻는 과정으로 형식화함. 기법별 분류와 달리, 세 결정 차원을 따라 흐름도(Fig. 3)를 타고 내려가 패러다임을 고름:
- 데이터 가용성 — 원본 문서(x∈X)가 있는가?
- 라벨 가용성 — 정답 주석(y∈Y)이 있는가?
- 목표 학습 패러다임 — 지도학습용 입출력 쌍을 짤 것인가, 자기지도용 pretext task를 짤 것인가?
이 발상이 왜 실용적인지가 핵심임. 현장 질문은 늘 “이 자원으로 뭘 할 수 있나”인데, 기법별 서베이는 그 답을 흩어놓음. 자원 축으로 묶으면 OCR에서 쓰던 기법을 KIE로 옮기는 식의 교차 이전(cross-task transfer) 이 자연스럽게 보임. 다만 벤치마크는 본질상 task별이라, 방법론은 자원 축으로 / 정량 평가는 task 축으로 직교 설계함.
2.2 네 패러다임
| 패러다임 | 자원 조건 (Data / Label / Goal) | 메커니즘 |
|---|---|---|
| ① 데이터 증강 | ✓ / ✓ / 지도 | 라벨 보존 변환 T로 (x′,y)=T(x,y) 생성. 의미·라벨 불변, 강건성·일반화↑ |
| ② 무에서 생성 | × / × / 지도 | R=∅의 cold-start. 템플릿·노이즈에서 (x,y)를 시각+구조 라벨 동시 합성 |
| ③ 자동 데이터 주석 | ✓ / × / 지도 | 라벨 없는 R={x}에 y=F(x) 근사. 주석을 “창작”에서 “검증”으로 전환 |
| ④ 자기지도 신호 구성 | ✓ / × / 자기지도 | 라벨 대신 내재 supervision 채굴. (x,ỹ)=P(x)로 pretext task, 표현 학습이 목표 |
앞 3개는 “라벨 데이터셋 D={(x,y)} 구성”이라는 같은 목표를 공유하고 출발 자원만 다름. ④만 학습 목표가 갈라짐(다운스트림 라벨이 아니라 표현 학습).
3. 방법론 ① 데이터 증강 (Data Augmentation)
증강의 진화를 증강 목적에 따라 4 layer로 계층화함(Fig. 4). 라벨이 보존되는 변환만 다룸.
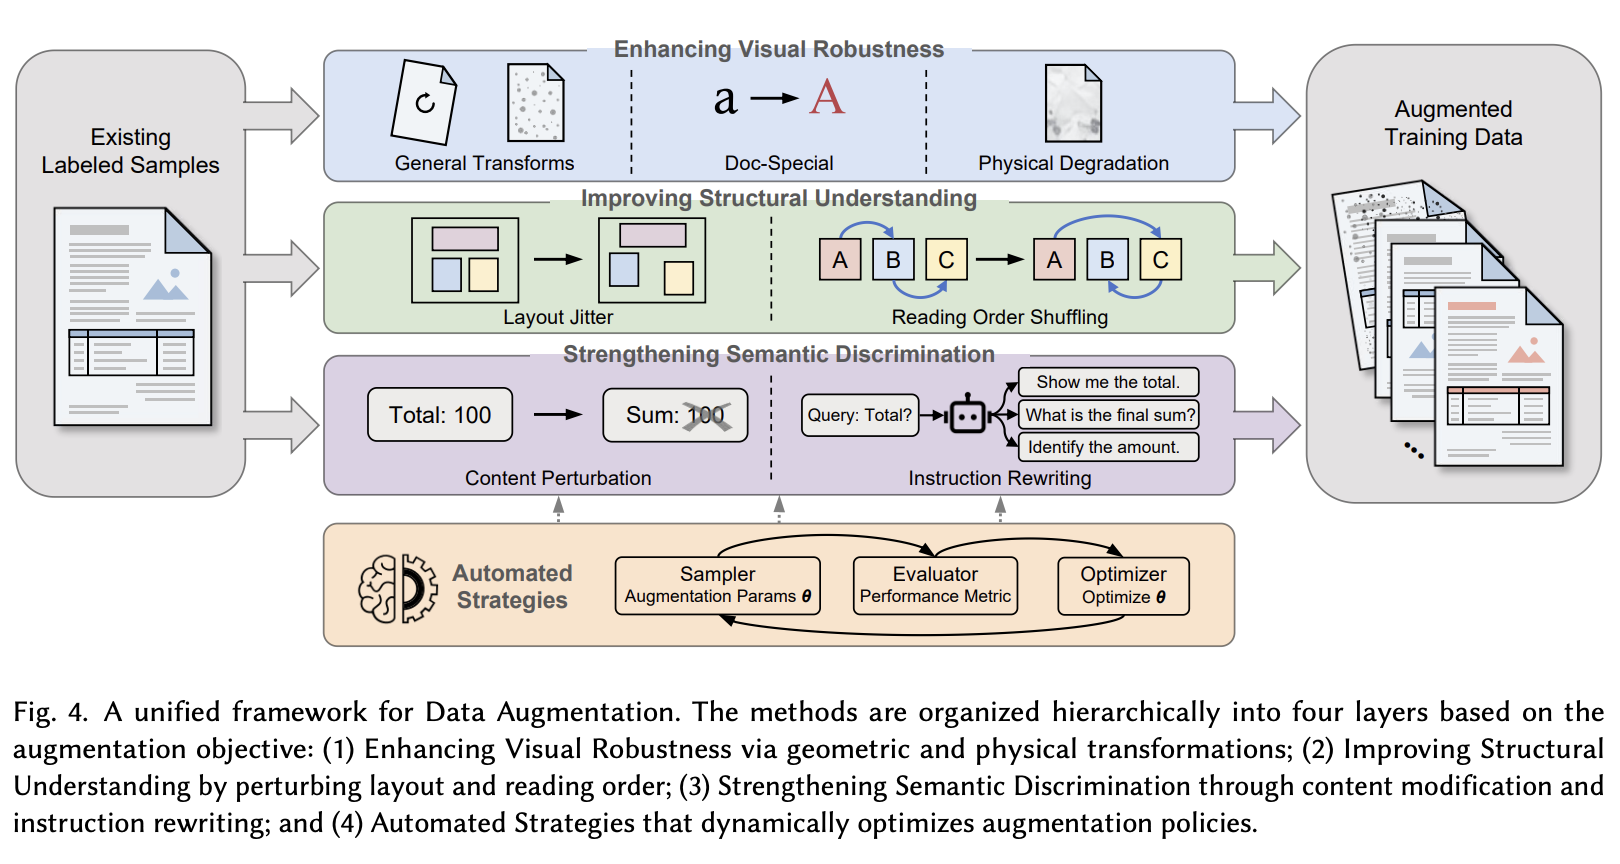
| Layer | 보는 관점 | 대표 기법 | 핵심 |
|---|---|---|---|
| 시각 강건성 | 문서=시각 객체 | 기하/광학 변환(회전·블러), 문서특화(폰트 무작위화·획 굵기), 물리적 열화(Augraphy: 잉크 번짐·스캐너 artifact·주름) | OOD 시각 변화에 취약한 모델 보강. 스캔/촬영 도메인 갭 메우기 |
| 구조 이해 | 문서=구조 객체 | 요소 셔플(읽기순서 교란), 토큰 간 거리 스케일링, bbox 좌표에 가우시안 노이즈(LOCR) | 레이아웃·읽기순서라는 “문법”에 노이즈 → 조직 논리 학습. KIE·읽기순서 같은 레이아웃 민감 task |
| 의미 변별 | 문서=의미체 | 동의어 치환·토큰 삭제(OCR 오류 모사), 의미적으로 틀린 가짜 요소(MixTex로 언어 prior 의존 완화), LLM 기반 지시/답변 재작성 | 언어 변이 강건성·편향 완화·복잡 지시 학습 |
| 자동 증강 | 정책 자체를 학습 | 데이터 통계 기반 휴리스틱(TabRecSet), 정책 탐색(FgAA: Bayesian opt로 획 단위 파라미터 탐색, validation 성능이 옵티마이저를 닫힌 루프로 이끎) | 고정 규칙의 전이성 한계 극복 |
핵심 차별점: 증강을 고정 전처리가 아니라 최적화 가능한 모듈로 보는 관점(정책 탐색)이 대두. 향후엔 LLM이 “이 인보이스를 비 맞은 것처럼” 같은 고수준 지시에서 효과를 생성하는 통제 가능 증강으로 진화 전망.
4. 방법론 ② 무에서 생성 (Data Generation from Scratch)
cold-start(샘플도 라벨도 없음)를 푸는 두 갈래. 본질은 통제성/정밀도 ↔ 사실성/다양성의 trade-off(Fig. 5).
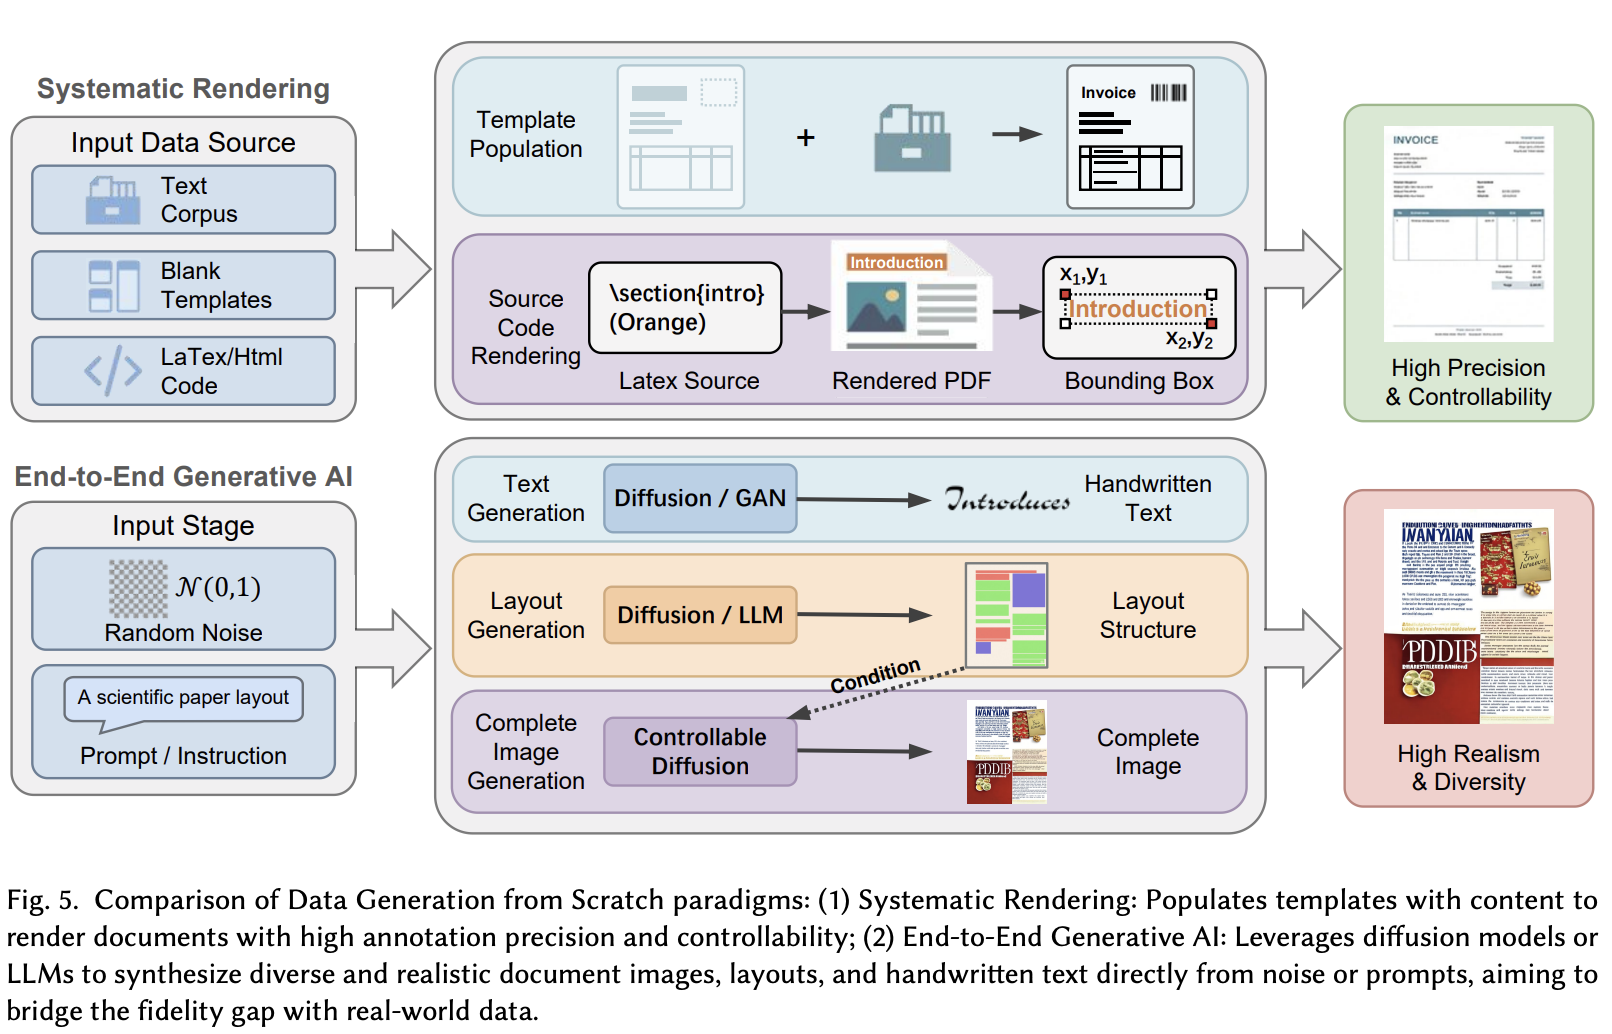
4.1 체계적 렌더링 (템플릿·규칙·렌더링)
“템플릿이 구조 정의 → 프로그램이 내용 채움 → 렌더 엔진이 시각 출력” 파이프라인. 시각+완벽 정렬 주석을 한 패키지로 생산하므로 대규모 합성 데이터셋의 초석.
- 기초 컴포넌트: 텍스트 라인(코퍼스×다폰트 렌더), 표(HTML/CSS·Pandoc 렌더 + LLM/실문서 내용), 차트(Matplotlib 렌더 + 템플릿으로 QA 동기 생성), 수식(.tex→이미지+Markdown 주석).
- 완성 문서: 반구조(인보이스·티켓·ID는 blank 템플릿에 인쇄), 복잡 구조(논문·웹은 소스코드 활용 — DLAgen은 LATEX 소스에 색을 칠해 렌더 출력에서 역매핑해 zero-error 픽셀 마스크 생성; HTML은 DOM에서 계층 주석 직접 추출), 범용(평문에 레이아웃·시각속성 부여 — SynthDoG가 임의 텍스트를 동적 레이아웃으로 문서화, HW-SQUAD는 SQuAD를 손글씨 VQA로 변환).
4.2 End-to-End 생성형 AI
실데이터의 잠재 분포를 직접 학습해 노이즈/조건에서 시각·레이아웃·내용을 한 번에 생성. 다양성·사실성·스타일이 강점.
- 손글씨 생성: GAN(초기 주류, Transformer 결합으로 순차성 포착) → diffusion(품질·통제성에서 GAN 추월, few/zero-shot, 단어→문단 확장, 한자·티베트어 등). VAE·RNN·순수 Transformer도 탐색.
- 레이아웃 생성: GAN/VAE/AR Transformer(이산 시퀀스) → diffusion(반복 denoising으로 구조적 일관성↑, 지배적) → LLM(in-context로 레이아웃 시퀀스, 자연어 지시 이해, 급진적으로 HTML/CSS 코드 생성 task로 재정의 — 초록만으로 포스터 레이아웃까지).
- 완성 이미지 합성: AR(DocSynth가 범주·위치·텍스트 통합 시퀀스) → VAE(CanvasVAE가 SVG·PDF 벡터 문서 직접 생성) → 통제 가능 diffusion(DIG: ControlNet으로 Stable Diffusion을 레이아웃 조건화 → 구조 통제 + 포토리얼리즘).
| 구분 | 장점 | 한계 |
|---|---|---|
| 체계적 렌더링 | 고통제·완벽 주석·고효율·강한 논리 일관성 | 다양성 제한, 사실성 도전적, 규칙 설계 복잡 |
| 생성형 AI | 고다양성·고사실성(스타일/질감)·규칙 불필요 | 통제성 제한, 환각, 높은 학습 비용 |
미해결: Fidelity Gap(실데이터와 구별 불가까지), 장문/멀티모달 일관성, LLM 생성의 사실성·환각.
5. 방법론 ③ 자동 데이터 주석 (Automated Data Annotation)
라벨 없는 풍부한 샘플에 y=F(x)를 근사. 주석을 “창작→검증”으로 바꿈. 지능의 출처에 따라 3단계 진화(Fig. 6).
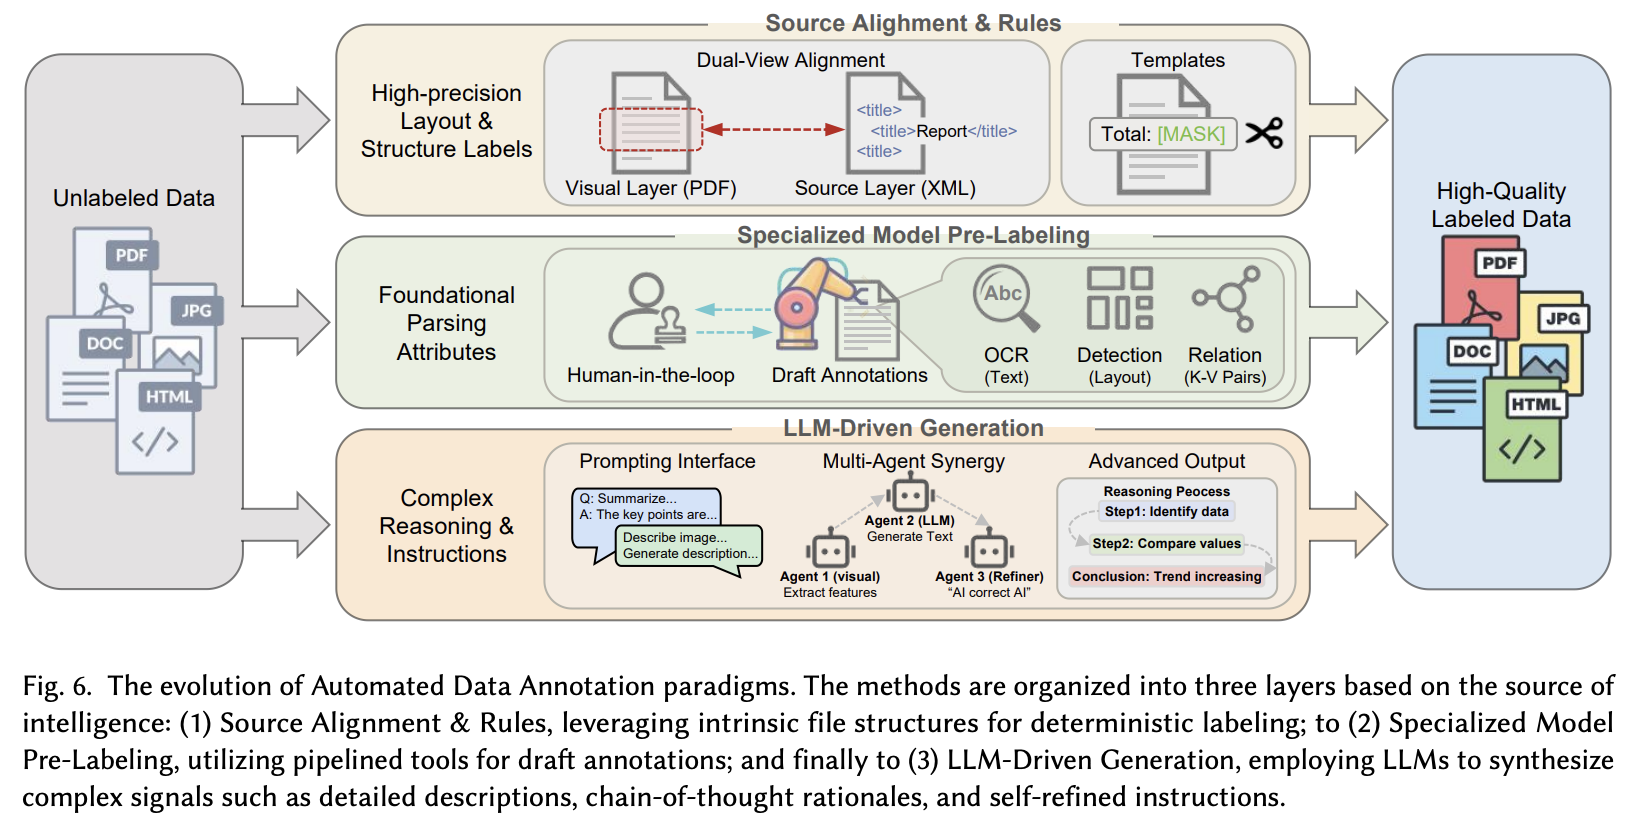
5.1 외부 소스 & 휴리스틱 (결정적·고해석성)
- 내재 구조 표현 활용: 디지털 출생 문서의 이중 표현(시각층 ↔ 기계가독 소스층 HTML/XML/LATEX)을 정렬해 거의 0비용 주석. PubLayNet이 태그-PDF 영역 문자열 매칭, 색코드 식별자로 구조→bbox 매핑, 표는 셀 구조까지 회수.
- 레이아웃 패턴 & task 논리: 윤곽 검출·skeletonization 같은 고전 이미지 처리, 들여쓰기로 텍스트 라인 분류, template 기반 QA 합성(구조 정보를 정해진 언어 패턴에 슬롯), 최근엔 주석 형식 변환(기존 KIE bbox를 instruction-response/VQA로 재활용해 레거시 데이터 가치 해방).
5.2 자동 도구 & 전문 모델 (pre-labeling, 현 주류)
- 기초 파싱 주석: off-the-shelf OCR로 전사, MT로 다국어. 레이아웃은 ① 파싱 기반(PDFMiner·GROBID), ② 비전 기반(YOLOv7·Mask-RCNN 약라벨), ③ 멀티모달 파이프라인(LayoutLMv3·UniMERNet 통합 → 레이아웃·수식·표 종합 주석). ← 여기서 LayoutLMv3가 “모델”이 아니라 “주석 도구”로 재등장.
- 고수준 의미 주석: LayoutLMv3로 K-V 쌍, 텍스트 분류기로 엔티티 약라벨, BiblioPage가 OCR↔도서관 메타데이터 매칭. 간단 QA는 end-to-end(ChartQA가 T5로 답·질문 순차 생성) 또는 반자동(명사구 추출→생성 모델로 질문 합성).
5.3 LLM 기반 생성 (최전선)
- task 지향 주석: 대규모 QA 쌍, 멀티턴 대화(좌표 grounding 유무), 논리 오류 negative 합성, “AI 제안-인간 답변” 하이브리드. 서술 주석은 단발→다단계 정제(“AI가 AI 교정” MiniGPT-4, 비전 전문가+LLM 계층 서술 Monkey).
- 추론 과정 & 지시 주석: 텍스트 rationale, 공간 인지 CoT(텍스트 추론 + bbox 증거 교직), 발판형 생성(OmniParser V2: 중간 구조점 먼저→상세화). 지시는 LLaVA 발판 → template 재구성 → CoT 복잡화 → 자기정제 루프(TextSquare: 모델이 스스로 묻고 답하고 평가).
| 단계 | 장점 | 한계 |
|---|---|---|
| 외부소스·휴리스틱 | 고정밀·고해석성 | 소스/고정규칙 의존, 일반화 약함 |
| 자동도구·전문모델 | 효율↑·성숙·널리 쓰임 | 체계적 편향, 여전히 인간 검토 필요 |
| LLM | 인지 task용 복잡 주석 가능 | LLM 의존·환각·높은 검증 비용 |
미해결: 복잡 생성 출력의 높은 검증 비용 + teacher 모델 편향 증폭. 자동 검증·신뢰도 보정이 차기 과제.
6. 방법론 ④ 자기지도 신호 구성 (Self-Supervised Signal Construction)
“라벨 없는 풍부한 데이터”에서 내재 supervision을 채굴해 파운데이션 모델을 학습. 여기선 “라벨 없음”을 넓게 봐 OCR 텍스트·HTML DOM·LATEX 소스를 “공짜 라벨” 로 씀. 3 패러다임(Fig. 7).
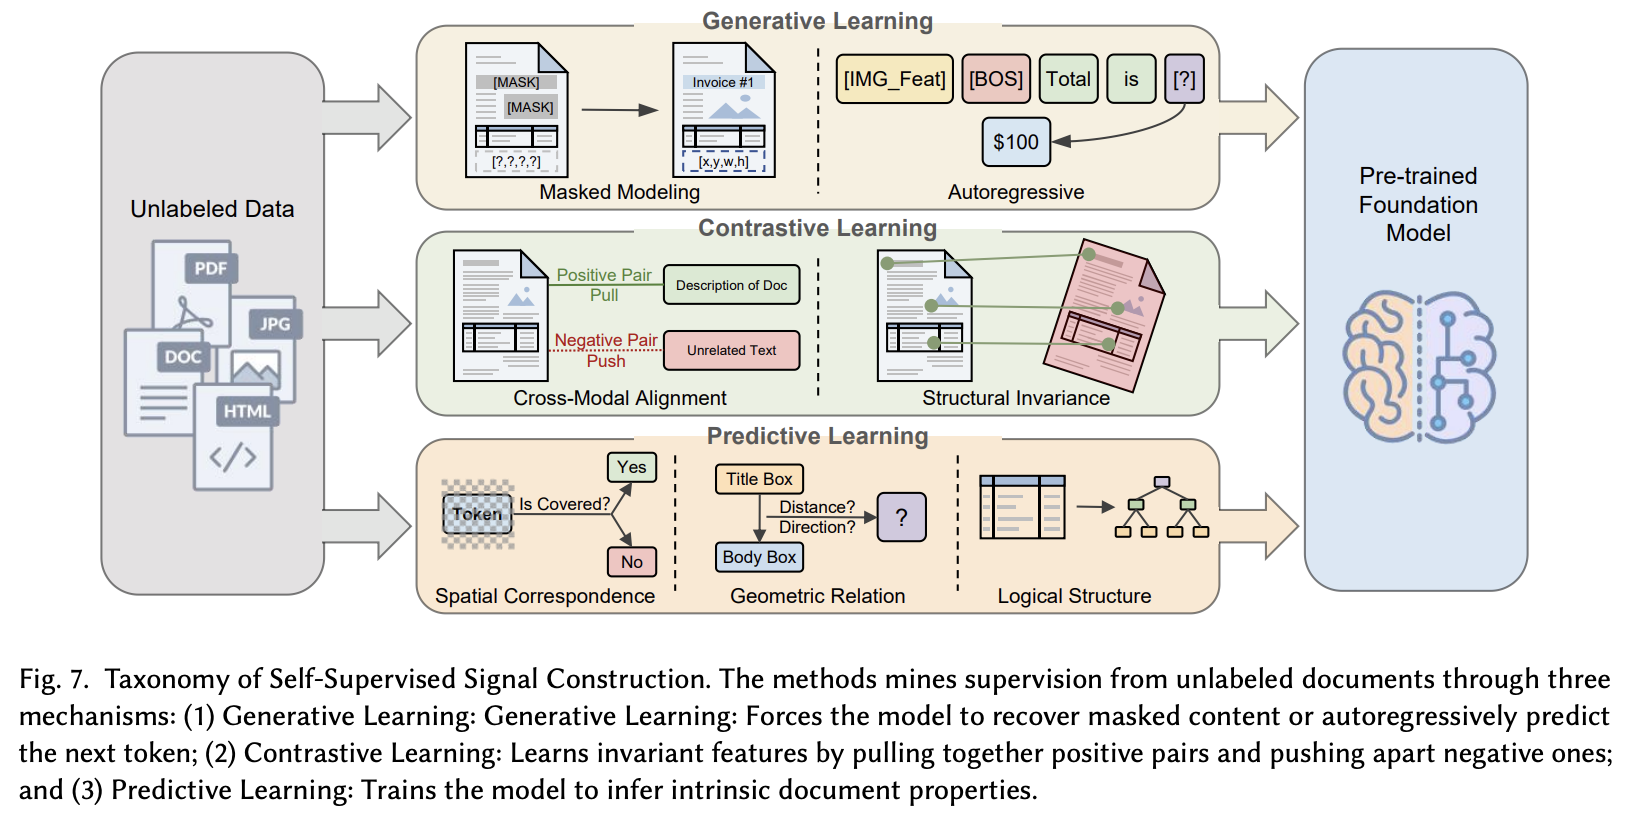
6.1 생성 학습 (Generative — “부분에서 전체 복원”)
- 마스킹 모델링: LayoutLM이 MVLM(2D 레이아웃+텍스트 문맥으로 마스킹 토큰 예측) 개척 → DiT가 BEiT식 MIM(이산 시각 토큰), DocumentNet은 픽셀 복원, BLT는 레이아웃 속성 마스킹(MAP). 이후 결합 멀티모달 마스킹으로 이동 — LayoutLMv3가 텍스트 토큰·이미지 패치를 동질 입력으로 한 Transformer에서 무차별 마스킹해 cross-modal 정렬 강제(← 앞서 본 그 논문의 핵심이 여기 한 칸).
- 자기회귀 모델링: ① 기호 시퀀스 언어모델링(시각·텍스트를 1D 인터리브 시퀀스로 pre-encode 후 next-token; 현대 MLLM의 기초 목적), ② 지각 task를 image-to-sequence로 재구성 — Donut의 pseudo-OCR(이미지→전체 텍스트 자기회귀 생성으로 OCR 능력 암묵 학습)이 가장 영향력 큼.
6.2 대조 학습 (Contrastive — 샘플 쌍에서 불변성)
목표가 구체→추상으로 진화: 국소 시각 일관성(같은 bbox 내 픽셀) → cross-modal 정렬(LayoutLMv2의 TIM이 문서 단위, LayoutXLM이 다국어로 확장) → 미시 객체 단위(DoCo가 객체별 시각/멀티모달 feature를 positive로) → 가장 추상적인 구조 불변성(DocReL이 같은 문서의 두 증강을 positive로 시각 교란 불변 구조 표현; 필체 스타일 disentangle).
여기가 B3 리뷰와 닿는 지점임. B3가 다룬 “in-batch negative의 질을 배치 구성으로 끌어올린다”는 바로 이 대조 학습 진영의 학습 효율 레버였음. 이 서베이는 대조 학습을 “데이터 생성(=positive/negative 쌍 구성)”의 한 갈래로 포섭해, B3 같은 배치 마이닝도 결국 자기지도 신호 구성의 한 변주로 자리매김함.
6.3 예측 학습 (Predictive — 내재 속성 “추론”)
생성이 raw 입력을 “복원”한다면 예측은 고수준 속성을 “추론”함. 추상도별 3종:
- 공간 대응: 텍스트 토큰의 대응 이미지 영역이 가려졌는지 예측 — LayoutLMv2의 TIA, LayoutLMv3의 WPA(← LayoutLMv3의 세 번째 목적함수가 정확히 여기). SeRum은 query↔segmentation 마스크.
- 기하 속성·관계: 텍스트↔bbox 좌표 양방향 매핑, 두 텍스트 요소 간 상대 거리·방향 계산.
- 논리·계층 관계(최상위): MarkupLM이 DOM 노드 부모-자식 관계 예측, image-to-Markdown(가시 텍스트 전사를 넘어 암묵 논리 구조 추론해 Markdown 생성 — DocOwl1.5가 문서·표·차트로 통일).
| 패러다임 | 장점 | 한계 |
|---|---|---|
| 생성 | 토큰/패치마다 풍부한 신호·강한 생성력 | [MASK] 토큰의 pre-train↔finetune gap |
| 대조 | 추상 표현·증강 강건·disentangle | 고품질 쌍 구성 의존·mode collapse |
| 예측 | 명시적 구조 prior 주입·고해석성 | 저비용 라벨(OCR/DOM) 의존·도메인 특화 task 설계 |
미해결: pre-train-finetune gap 완화, 막대한 연산 비용, world knowledge 통합하는 멀티모달 정렬 pretext 설계.
7. 실험 결과 — 평가 틀 + Task-패러다임 매핑
서베이의 두 번째 기여. 직접 실험이 아니라 “생성 데이터가 좋은지 어떻게 아느냐”의 다층 평가 틀과 문헌 정량 종합임.
7.1 평가 틀 (내재 + 외재)
- 내재(Intrinsic) — 다운스트림 없이 데이터 품질 직접 측정.
- 거시(dataset): 분포 정합 IS/FID/KID, fidelity↔diversity 분리용 Precision-Recall·Density-Coverage, 다양성 TTR·Self-BLEU, 레이아웃 DocSim.
- 미시(sample): ① 계산 기반(PSNR·SSIM·LPIPS, BLEU·BERTScore, CLIP Score, 레이아웃 Doc-EMD·LTSim, 트리 TEDS), ② 학습 기반 perceptual(가독성 점수, 저신뢰 필터, Uni-Layout이 인간 선호로 미감 판정), ③ LLM-as-evaluator(사실성·일관성 채점, 지시 solvability/clarity/hallucination 등급, 닫힌 루프 자기정제).
- 외재(Extrinsic) — 다운스트림 성능 증분. baseline 대비 increment가 주지표, test set 분리(template 누수 방지), OOD 강건성(RoDLA의 mRD), 데이터 효율·스케일링 법칙.
7.2 Task-패러다임 매핑 (Fig. 8 히트맵 — “Perception–Reasoning Shift”)
문헌을 통계 내 어느 패러다임이 어느 task에 쓰이는지 비율로 매핑. 핵심 발견:
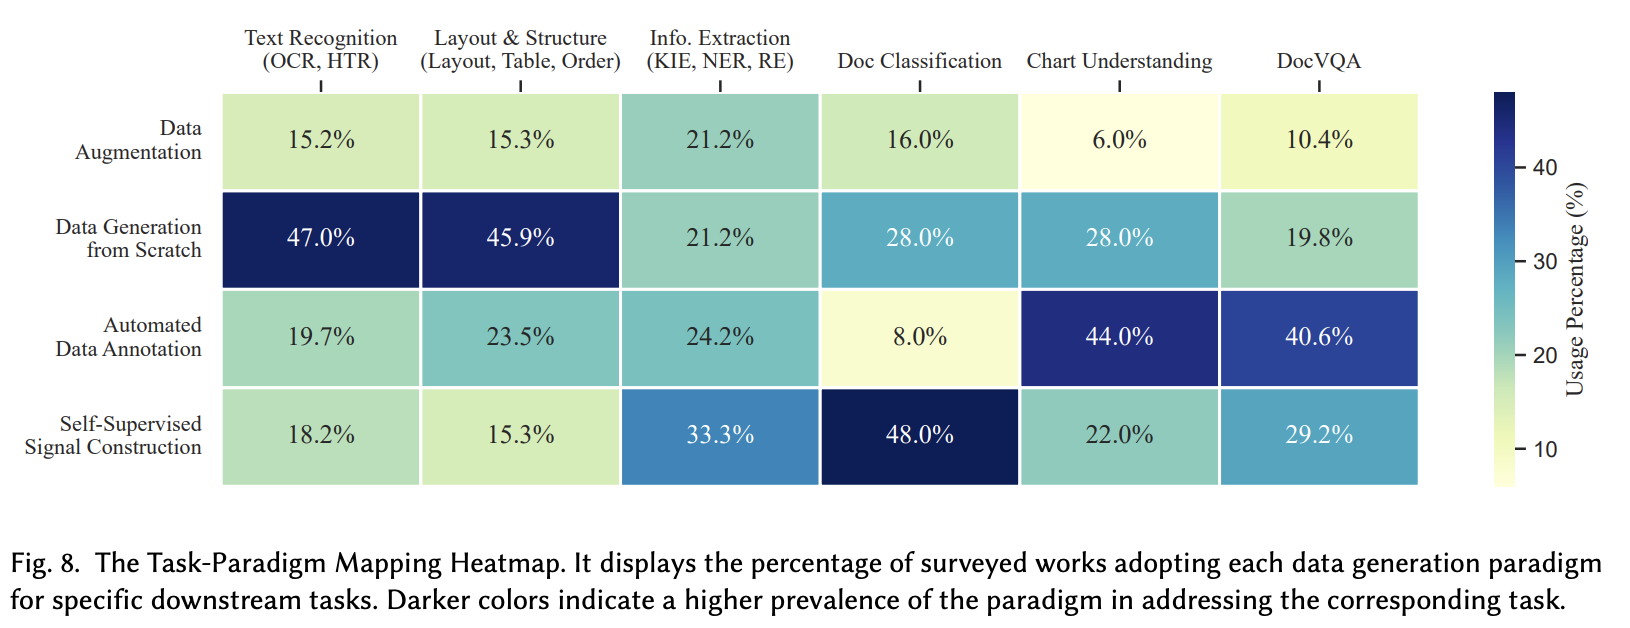
| Task | 지배 패러다임 | 비율 |
|---|---|---|
| 텍스트 인식(OCR/HTR) | 무에서 생성 | 47.0% |
| 레이아웃·구조 | 무에서 생성 | 45.9% |
| 정보 추출(KIE/NER/RE) | 자기지도 | 33.3% |
| 문서 분류 | 자기지도 | 48.0% |
| 차트 이해 | 자동 주석 | 44.0% |
| DocVQA | 자동 주석 | 40.6% |
읽는 법: 지각(perception) task는 픽셀 완벽 GT가 필요해 “무에서 생성” 이 지배하고, 고수준 추론(reasoning) task는 LLM이 복잡 QA를 만드는 “자동 주석” 으로 이동함. 자기지도는 전반에 고르게 깔린 “범용 의미 인프라”. 정량 증분은 ablation/baseline 비교로 검증된 것만 채택(절대 성능이 아니라 increment 중심).
앞서 본 모델들이 이 표에 increment로 박힘: UDOP(RVL-CDIP +0.9, DocVQA ANLS +4.7), LayoutLMv3(RVL-CDIP MIM+MLM), DiT, Donut(OCR-free baseline), LayoutXLM(XFUND F1 +8.11), DocOwl1.5(ChartQA), Pix2Struct(스크린샷 파싱), MarkupLM(WebSRC) 등. 즉 개별 논문들의 기여가 “어느 자원 패러다임의 사례인가”로 재좌표화됨.
8. 한계 및 비판
1) 자원 축 분류의 경계 모호성 실제 현대 파이프라인은 4 패러다임을 혼합(저자도 “전략적 하이브리드화”로 권함)함. “데이터/라벨 가용성”이라는 깔끔한 이분이 현장에선 흐려짐 — 자기지도로 만든 백본을 자동 주석의 pre-labeler로 쓰는 식의 순환을 단일 패러다임으로 못 가둠. 분류가 깔끔하다고 현실 적합성이 보장되진 않음.
2) 정량 종합의 비교 불가능성 (저자 인정) 정량 종합 표들이 논문마다 실험 셋업이 달라 절대 성능 비교가 불가해 “increment만 본다”고 못박음. 그러나 increment조차 baseline 강도·데이터 규모가 제각각이라, 표의 수치(예: K2Q ANLS 53→90)를 패러다임 우열로 직독하면 위험. 서베이가 메타 분석의 한계를 솔직히 안고 있음.
3) 평가 틀의 실행 가능성 미검증 “첫 종합 다층 평가 틀”을 제시하지만, 이 틀로 실제 데이터셋을 채점한 저자 자신의 실증은 없음. 기존 지표들의 카탈로그·분류에 가깝고, 어느 조합이 어느 상황에 최적인지의 처방은 약함. 저자도 스스로 dataset shortcut·인간 인지 정합·복잡 출력 평가의 미해결을 나열함.
4) “데이터 생성 = 만능 엔진” 서사의 낙관 결론부가 generative AI를 “범용 cross-paradigm 엔진”, 자기지도를 “범용 인프라”로 격상하고 co-evolutionary ecosystem을 그리지만, 본인도 Model Collapse / Data Entropy를 존재적 위협으로 인정함. negentropy filter(자동 감사)를 처방하나 그 실현 가능성은 미검증 — 자기개선 루프의 낙관과 붕괴 경고가 한 장에 공존함.
5) 시의성 vs 깊이의 trade-off 2026년 1월 기준 최신 LLM/MLLM 기법까지 폭넓게 담은 대신, 개별 기법의 메커니즘 깊이는 얕음(한 기법당 한두 문장 + 인용). 특정 방법을 깊게 보려면 결국 원논문을 봐야 함 — 지도(map)이지 매뉴얼이 아님.
6) VRD 한정 스코프 순수 평문·자연 장면 텍스트(간판 등)를 명시적으로 제외함. 합리적 경계지만, scene text↔문서의 경계가 흐린 영역(영수증 촬영·손글씨 등)에서 일부 기법이 누락될 여지가 있음.
9. 결론
1) 핵심 기여는 “기법이 아니라 자원으로 데이터 생성을 재편한 첫 종합 지도” “데이터·라벨의 가용성”이라는 단일 축으로 데이터 증강·무에서 생성·자동 주석·자기지도 4 패러다임을 가르고, “데이터 생성”의 정의를 labeled 샘플 생성 너머 자동 주석·자기지도 신호 구성까지 확장함. 동시에 내재(품질)+외재(유용성) 다층 평가 틀과 task-패러다임 히트맵으로 분야를 체계화함.
2) 설계 핵심은 “자원 축 방법론 × task 축 평가의 직교 설계” 의사결정은 자원 흐름도(Fig. 3)로, 검증은 task별 벤치로 분리해, “내 자원으로 뭘 할까”와 “그게 실제로 듣나”를 따로 답하게 함. 거기서 Perception–Reasoning Shift(지각=무에서 생성, 추론=자동 주석, 자기지도=범용 인프라)라는 한 줄 요약을 뽑아냄.
3) 계보에서의 위치 — 개별 논문들을 한 장에 좌표화한 메타 프레임 지금까지 본 모델들이 전부 이 지도 안에 박혀 있음: LayoutLMv3의 MIM·MLM·WPA는 자기지도(생성·예측)의 사례이자 주석 도구로 이중 등장하고, Donut의 pseudo-OCR·DiT의 MIM·UDOP의 joint reconstruction·LayoutLMv2/XLM의 TIM·MarkupLM의 DOM 예측·DocOwl1.5의 image-to-Markdown·ColPali·Pix2Struct가 전부 자원 패러다임의 좌표로 재배치됨. B3가 다룬 배치 마이닝조차 대조 학습(=쌍 구성)의 한 변주로 포섭됨. 즉 이 서베이는 “각 논문이 어떤 supervision을 어디서 어떻게 캤는가”를 자원 축 한 장으로 꿰는 상위 프레임으로 읽으면, 그동안 본 논문들이 한 줄에 정렬됨 — 모델 진보의 이면에 있던 데이터 생산 차원을 전면에 세운 지도임.
배경 개념 정리
Supervisory signal (감독 신호) 생산으로서의 데이터 생성 이 서베이가 “데이터 생성”을 재정의한 틀. 단순히 (x,y) 샘플을 만드는 것을 넘어, 라벨이든 pretext task든 모델 학습을 이끄는 모든 비수작업 신호를 생산하는 행위로 봄. 이 확장 덕에 자동 주석·자기지도까지 한 우산에 들어옴.
자원 중심(resource-centric) vs 기법 중심(technique-centric) 분류 기존 서베이가 “GAN/diffusion/template” 같은 기법으로 가른 데 반해, 이 논문은 “지금 데이터·라벨이 있나/없나”로 가름. 같은 자원 상황의 해법이 한곳에 모여 교차 이전이 보이고, 현장 의사결정(“이 자원으로 뭘?”)에 직접 답함.
네 패러다임 한 줄 요약 ① 데이터 증강(둘 다 있음, 변환으로 늘림) ② 무에서 생성(둘 다 없음, 합성으로 채움) ③ 자동 주석(샘플만 있음, 라벨 근사) ④ 자기지도(샘플만 있음, 라벨 대신 pretext task). ①②③은 지도학습용 라벨셋이 목표, ④만 표현 학습이 목표.
Fidelity Gap & Model Collapse fidelity gap은 합성 데이터가 실데이터와 시각·내용에서 구별 가능한 격차. model collapse는 생성 모델의 미세 환각·편향이 자기개선 루프(모델→데이터→모델)를 돌며 누적·증폭돼 시스템이 퇴화하는 현상. 서베이는 이를 막을 negentropy filter(자동 감사로 학습 스트림 정화)를 미래 과제로 둠.
내재(intrinsic) vs 외재(extrinsic) 평가 내재는 다운스트림 없이 데이터 품질 자체를 잼(FID·다양성·TEDS·LLM 심판 등) — “고품질인가”. 외재는 다운스트림 모델 성능 증분으로 잼 — “유용한가”. 둘은 보완 관계로, 고품질이 곧 유용은 아님(shortcut·modality redundancy로 점수만 높을 수 있음).
Perception–Reasoning Shift task-패러다임 히트맵(Fig. 8)에서 읽힌 경향. 픽셀 완벽 GT가 필요한 지각 task(OCR·레이아웃)는 “무에서 생성”이, LLM으로 복잡 QA를 만드는 추론 task(차트·DocVQA)는 “자동 주석”이 지배하고, 자기지도는 전반에 깔린 범용 인프라라는 한 줄 진단.