PaddleOCR-VL
PaddleOCR-VL: Boosting Multilingual Document Parsing via a 0.9B Ultra-Compact Vision-Language Model
Authors: Cheng Cui, Ting Sun, Suyin Liang, Tingquan Gao, et al. (PaddlePaddle Team, Baidu Inc.)
1. 문제 정의
핵심 문제
현대 문서의 본질적 복잡성을 효율적으로 파싱하는 것이 핵심 문제임.
문서 파싱은 이미지·PDF를 구조를 유지한 Markdown/JSON으로 변환하는 작업으로, 단순 텍스트 OCR과 다름. 실제 문서 한 페이지에는 다음이 한꺼번에 섞여 있기 때문임.
- 빽빽한 본문 텍스트
- 복잡한 표·차트
- 수식
- 다국어
- 손글씨
- 다단·혼합형 레이아웃
따라서 요구되는 능력은 글자 인식만이 아님. 본문/표 구분, 수식·차트 별도 인식, 요소 간 읽기 순서 복원까지 필요함. 이 결과물 품질이 RAG·LLM 데이터 파이프라인 전체 성능을 좌우함. 파싱 단계에서 표가 깨지거나 순서가 뒤엉키면 그 노이즈가 검색·생성까지 전파되기 때문임.
기존 연구의 한계
문서 파싱은 두 갈래로 발전해 왔으며, 각각 명확한 약점이 존재함.
1) 파이프라인 방식
전문 모듈을 직렬로 연결함 (레이아웃 검출 → 텍스트 인식 → 표·수식 전용 모델 → 후처리).
| 항목 | 내용 |
|---|---|
| 장점 | 각 모듈의 개별 성능 우수 |
| 한계 | 통합 복잡, 앞 단계 오류가 뒤로 누적됨(cascade error) |
2) End-to-end VLM 방식
페이지 전체를 멀티모달 모델에 넣고 통째로 출력함.
| 항목 | 내용 |
|---|---|
| 장점 | 워크플로 단순 |
| 한계 | reading order 오류·hallucination, 긴 시퀀스 autoregressive 출력으로 latency·메모리 비용 큼 |
3) 미해결 trade-off
정리하면 정확하면 무겁고(대형 VLM), 가벼우면 부정확함(소형 모델·파이프라인). 특히 end-to-end VLM은 페이지를 통째로 처리하느라 자원 제약 환경에 배포하기 어려움. “정확도 ↔ 효율” trade-off를 깨지 못한 것이 핵심 미해결 과제임.
2. 제안 방법: PaddleOCR-VL
논문은 이 trade-off를 역할 분리로 해소하는 2단계 문서 파서 PaddleOCR-VL을 제안함. 109개 언어를 지원하며 오픈소스로 공개됨.
전체 흐름은 다음과 같음.
- 문서 이미지 → 레이아웃 분석(PP-DocLayoutV2) → 요소 잘라내기 → 요소 인식(PaddleOCR-VL-0.9B) → 후처리 → Markdown/JSON
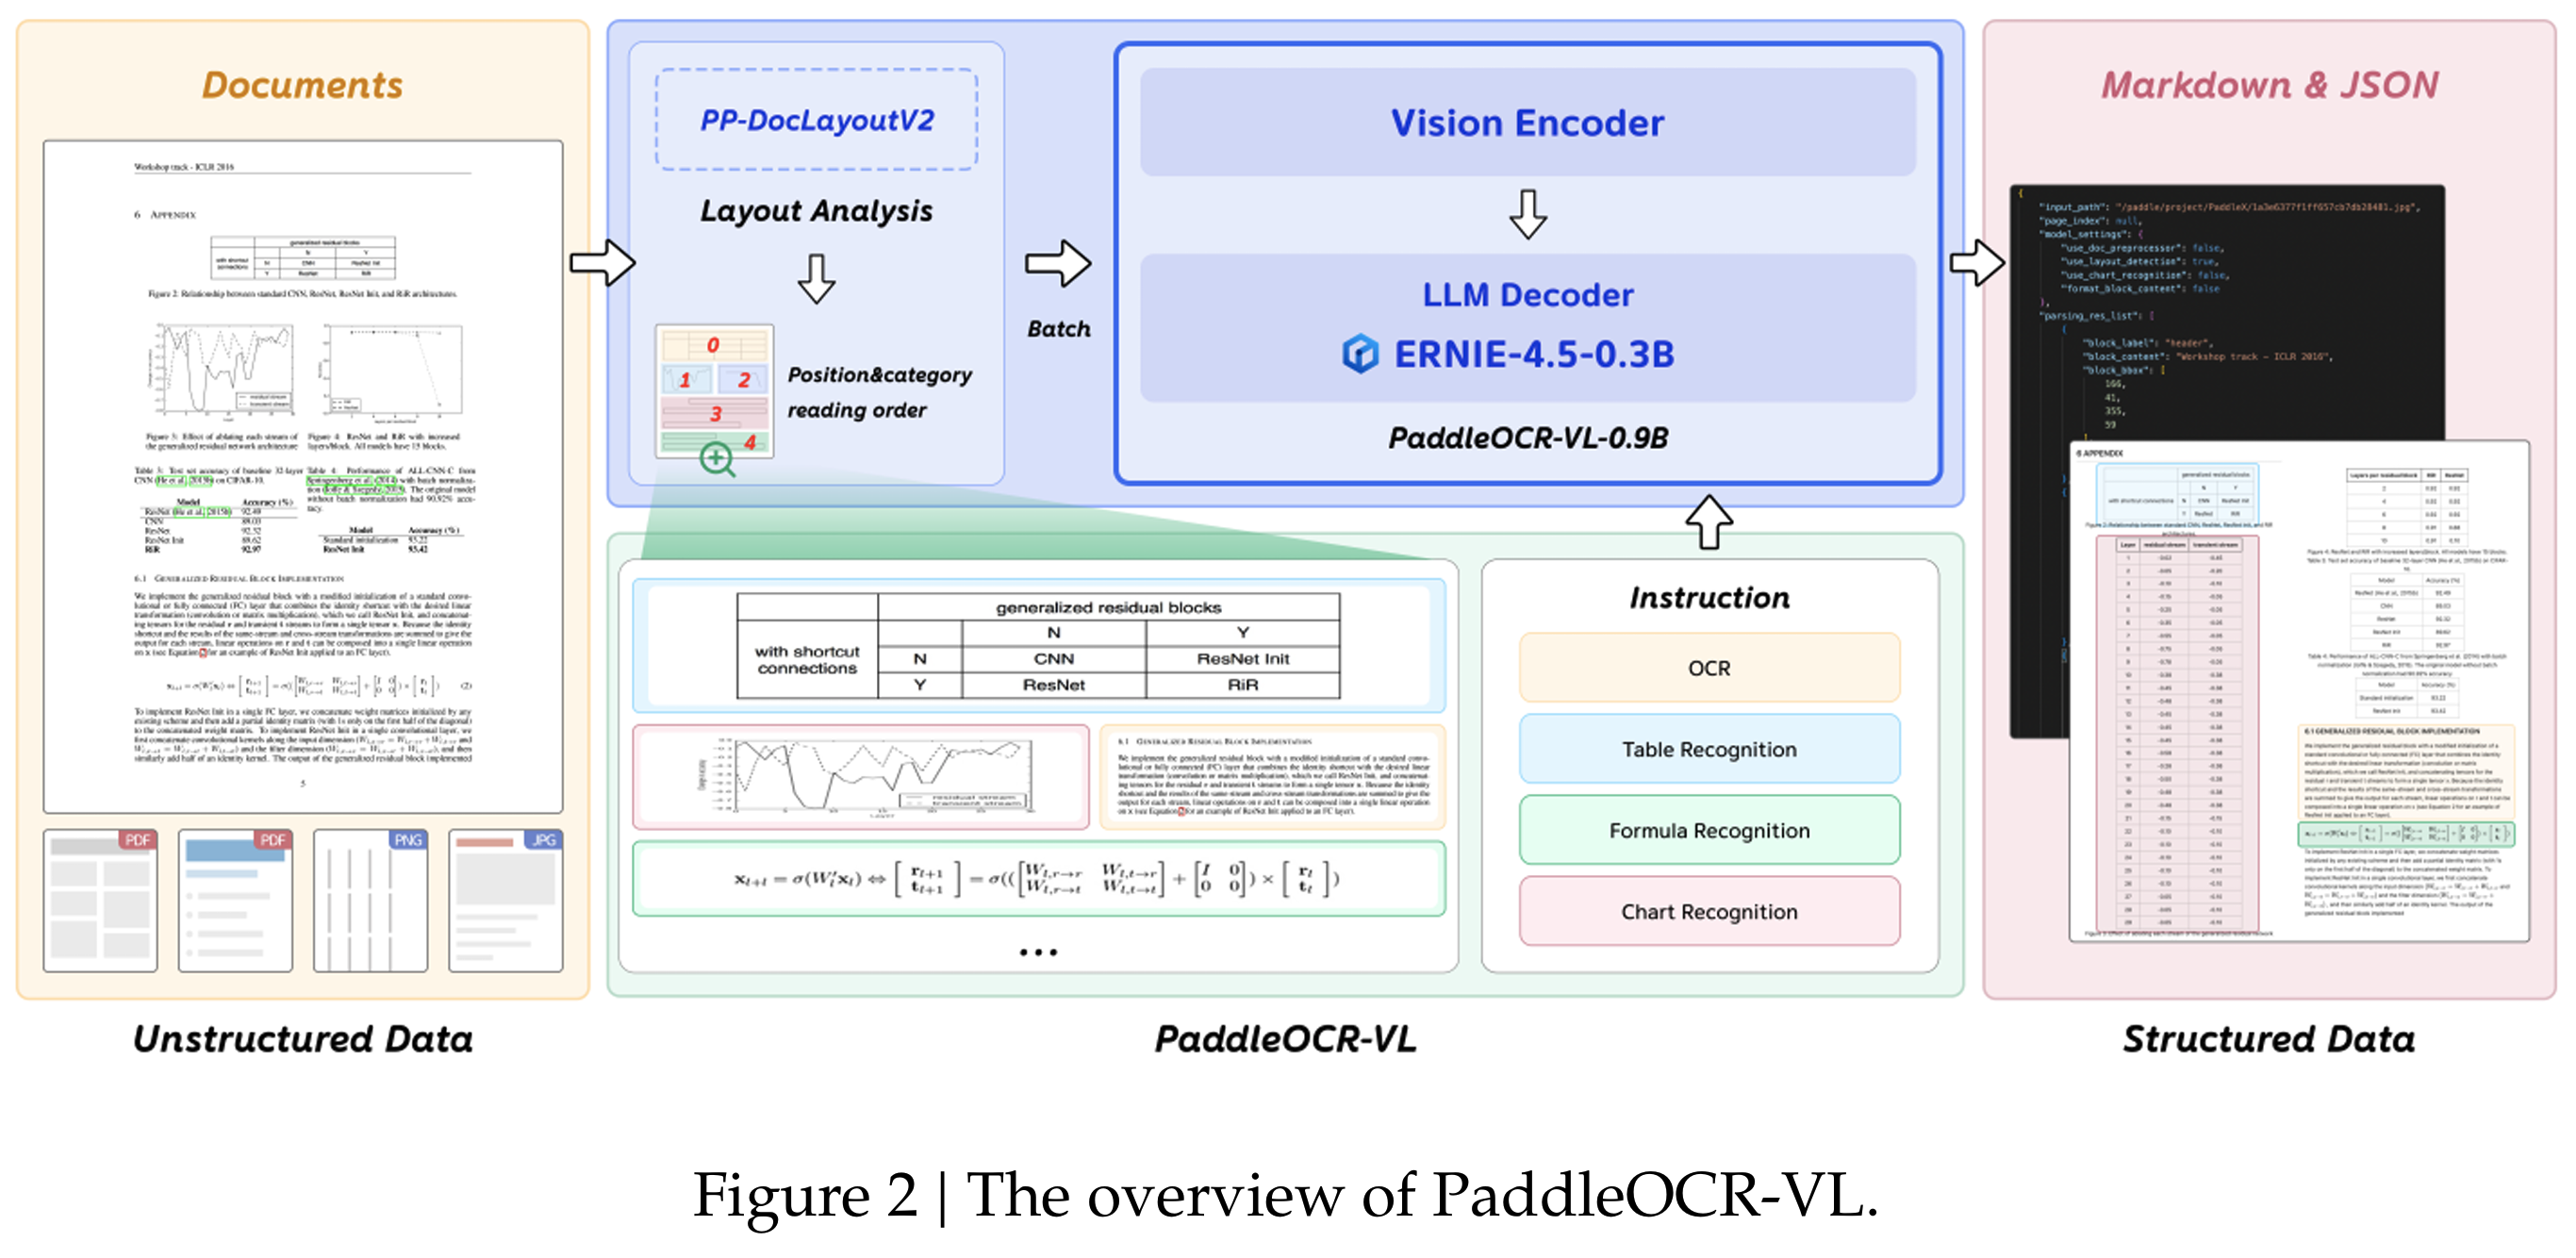 PaddleOCR-VL 전체 개요: 비정형 문서 → 레이아웃 분석 → 요소 인식 → 구조화된 Markdown/JSON
2.1 핵심 아이디어
레이아웃(요소 위치 + 읽기 순서)은 작은 전용 detector가 먼저 잡고, 인식은 잘라낸 요소 조각만 0.9B VLM이 담당함.
페이지를 통째로 VLM에 던지지 않고 잘게 나눔으로써, end-to-end VLM이 떠안던 긴 시퀀스·hallucination·순서 오류를 구조적으로 회피함. 덕분에 인식 모델을 0.9B까지 줄이고도 정확도를 유지함.
그 0.9B VLM이 작은 크기로 높은 인식력을 내는 비결이 NaViT 스타일 비전 인코더와 ERNIE-4.5-0.3B 언어모델 두 가지 선택임.
2.2 아키텍처
1) 레이아웃 분석 — PP-DocLayoutV2
전용 경량 모델이 요소 위치와 읽기 순서를 먼저 결정함. 두 네트워크가 직렬로 연결된 구조임.
- RT-DETR 기반 검출/분류로 bounding box·클래스 추출
- 6-layer transformer pointer network가 순서 예측. 요소 쌍 상대 순서를 N×N 행렬로 만들고(Relation-DETR의 geometric bias), win-accumulation 디코딩으로 reading order 복원
핵심은 읽기 순서를 autoregressive 생성이 아니라 pairwise 분류 문제로 전환한 점임. end-to-end VLM의 순서 흔들림을 회피함.
2) 요소 인식 — PaddleOCR-VL-0.9B
1단계에서 잘라낸 조각만 VLM에 입력함. LLaVA 스타일 구조임.
| 구성요소 | 내용 |
|---|---|
| 비전 인코더 | NaViT 스타일 동적 해상도 (Keye-VL 가중치 초기화) |
| 프로젝터 | 2-layer MLP (GELU), merge size 2 |
| 언어모델 | ERNIE-4.5-0.3B + 3D-RoPE |
2.3 핵심 기술 ① NaViT-style dynamic resolution
1) 기존 방식의 문제
대부분의 ViT는 입력을 224×224, 448×448 같은 고정 해상도 정사각형으로 리사이즈해 받음. 문서에선 치명적임. 가로로 긴 표, 세로로 긴 단(column), 깨알 같은 각주를 정사각형에 욱여넣으면 종횡비가 깨지고 글자가 뭉개짐. 타일링(tiling) 우회책은 타일 경계에서 문맥이 끊기고 토큰 수가 폭증함.
2) NaViT의 아이디어 (Patch n’ Pack, 2023)
이미지를 리사이즈하지 않고 native 해상도/종횡비 그대로 패치로 쪼갠 뒤, 여러 이미지의 패치를 NLP의 example packing처럼 한 시퀀스에 묶어(pack) 처리함. 묶인 샘플 간 attention 누수는 마스킹으로 차단하고, 위치 정보는 factorized positional embedding으로 표현함.
3) 효과
- 왜곡 없음: 가로 표는 가로로, 세로 글은 세로로 그대로 입력됨 → dense text·세로쓰기 hallucination 감소, 인식력 상승
- 유연한 해상도: 작은 요소는 적은 토큰, 큰 요소는 많은 토큰 → 정확도/비용을 입력에 맞춰 동적 조절
요소 단위로 잘라 넣는 PaddleOCR-VL 파이프라인과 궁합이 좋음. 잘린 조각마다 크기·종횡비가 제각각인데 리사이즈 없이 바로 먹일 수 있기 때문임. (구현은 멀티모달 모델 Keye-VL의 비전 가중치로 초기화함.)
2.4 핵심 기술 ② ERNIE-4.5-0.3B
1) 모델 개요
- ERNIE 4.5는 Baidu가 2025년 7월 Apache 2.0으로 공개한 패밀리로, 0.3B dense부터 424B MoE까지 구성됨
- 여기 쓰인 0.3B는 약 3.6억 파라미터의 dense(비-MoE) 텍스트 모델. 순수 dense라 구조가 단순하고 서빙 예측이 쉬움
- PaddlePaddle 생태계 + ERNIEKit(SFT·LoRA·DPO)로 학습 → 자사 모델·툴킷이라 통합 비용 낮음
2) 선택 논리와 trade-off
autoregressive 디코딩에서 latency는 디코더 크기에 직결됨. 따라서 인식 task에 충분한 최소 크기의 LM을 골라 속도를 확보한 것임. 비전 인코더에 표현력을 싣고 LM은 가볍게 가져가는 “vision-heavy / language-light” 균형임.
단, 0.3B LM의 언어적 추론·문맥 보정 능력은 제한적임. 이 모델의 강점은 “이해”보다 “정확한 전사(transcription)”에 가깝다는 점을 감안해야 함.
2.5 데이터 파이프라인
모델만큼 데이터 구축이 이 논문의 실제 무기임. 3천만+ 샘플.
| 단계 | 내용 |
|---|---|
| 자동 라벨링 | PP-StructureV3로 pseudo-label 생성 → ERNIE-4.5-VL·Qwen2.5-VL로 정제 → hallucination 필터링 |
| Hard case mining | eval engine으로 유형별(텍스트 23·표 20·수식 4·차트 11종) 약점 식별 → XeLaTeX·웹 브라우저로 비슷한 난이도 샘플 합성 |
| 학습 | 2-stage. Stage 1 29M 정렬(1ep), Stage 2 정제 2.7M instruction FT(2ep). task = OCR / 표(OTSL) / 수식(LaTeX) / 차트(Markdown) |
3. 실험 결과
3.1 Page-level (전체 문서 파싱)
OmniDocBench v1.5 Overall 기준 (높을수록 좋음).
| 모델 | 파라미터 | Overall |
|---|---|---|
| PaddleOCR-VL | 0.9B | 92.56 |
| MinerU2.5 | 1.2B | 90.67 |
| MonkeyOCR-pro-3B | 3.7B | 88.85 |
| Gemini-2.5 Pro | - | 88.03 |
| Qwen2.5-VL-72B | 72B | 87.02 |
| PP-StructureV3 (자사 구버전) | - | 86.73 |
- OmniDocBench v1.0: 평균 overall edit distance 0.115로 최저
- olmOCR-Bench: 80.0으로 1위(dots.ocr 79.1, MinerU2.5 77.5). machine-verifiable unit test 기반이라 soft metric 편향이 적음
- 다국어 텍스트: 비라틴 문자에서 Qwen2.5-VL-72B 대비 격차 큼 (예: Telugu 0.011 vs 0.758)
page-level 표의 경쟁사 점수는 OmniDocBench·olmOCR 측이 직접 채점함(“reported by … unless Ours”). 따라서 page-level 결과는 비교적 신뢰 가능함.
3.2 Element-level (요소별 인식)
- 텍스트·표·수식·차트 대부분 카테고리에서 1위
- 단, 평가셋 상당수가 in-house라 해석에 주의 필요 (4장 참조)
4. 한계 및 비판
1) in-house 벤치 의존
element-level 핵심 표 상당수가 자체 구축셋임(In-house-OCR 10.7만, In-house-Formula 3.4만, In-house-Chart). 특히 차트는 public을 아예 안 씀(“공개셋 품질이 나쁘다”는 이유). 자기 데이터 분포에 유리하므로 element-level SOTA 주장은 page-level만큼 신뢰하지 말 것. Rare Char 0.001 같은 수치는 비현실적으로 낮아 누수/난이도 편향 의심 신호임.
2) 자기 채점 구간
page-level 표에서 자기 모델·MinerU2.5는 직접 측정함. 동일 전처리/정규화 조건 보장이 불투명 → 자기 측정 항목은 할인해서 볼 것.
3) 순환 데이터 위험
자사 생태계 모델(PP-StructureV3 → ERNIE-4.5-VL)로 라벨링한 데이터로 학습함. in-house 평가셋과 분포가 겹치면 점수가 부풀 수 있음.
4) cascade 위험 잔존
2단계 구조라 layout detection이 틀리면 그 조각의 인식이 통째로 망가짐. “파이프라인의 누적오류”를 비판하며 출발했지만 그 약점을 절반은 상속함.
5) ablation 부재
NaViT vs 고정해상도, ERNIE-0.3B 선택, 데이터 파이프라인 단계별 기여도 등 분해 실험이 거의 없음. 학술 논문이라기보다 technical report로 읽는 게 맞음.
5. 결론
1) 작은 VLM으로 문서 파싱 SOTA 가능
핵심 기여는 “큰 VLM이 아니라 0.9B 작은 VLM으로도 SOTA”라는 점, 그리고 그걸 가능케 한 레이아웃 분리 + 요소 단위 인식 설계임.
2) 설계 핵심은 역할 분리
레이아웃은 경량 detector가, 인식은 요소 단위 VLM이 담당함. end-to-end의 긴 시퀀스·순서 오류를 구조적으로 회피함.
3) 결과 신뢰도는 층위별로 다름
- page-level: 제3자 채점 → 신뢰 가능
- element-level: in-house 의존 큼 → 자기 데이터로 재검증 필요
“0.9B가 72B를 이겼다”는 헤드라인은, 적어도 page-level에서는 사실임.