mPLUG-DocOwl2
mPLUG-DocOwl2: High-resolution Compressing for OCR-free Multi-page Document Understanding
Authors: Anwen Hu, Haiyang Xu, Liang Zhang, Jiabo Ye, Ming Yan, et al. (Alibaba Group, Renmin University of China) — arXiv 2409.03420, 2024년 9월.
참고: 앞서 본 MinerU2.5·PaddleOCR-VL(2025)보다 약 1년 앞선 작업임. 그리고 task 자체가 다름. MinerU2.5/PaddleOCR-VL이 문서 → Markdown/JSON으로 바꾸는 파싱기라면, DocOwl2는 페이지를 보고 질문에 답하는 이해(VQA) 모델임. 그래서 OmniDocBench 같은 파싱 벤치로 직접 비교되지 않음. 다만 셋 다 똑같은 적 — 고해상도 문서가 만드는 시각 토큰 폭증(= token redundancy) — 을 겨눔. DocOwl2는 이걸 “요소 잘라내기”가 아니라 압축으로 푸는 제3의 계보임.
1. 문제 정의
핵심 문제
고해상도 multi-page 문서를 OCR 없이(OCR-free) 이해하되, 그 비용을 감당 가능하게 만드는 것이 핵심 문제임.
MLLM은 문서 이미지의 지원 해상도를 올려서 OCR-free 이해 성능을 끌어올려 왔음. 그런데 그 대가로 한 페이지에 수천 개의 시각 토큰이 생김. 예컨대 InternVL2는 단일 페이지 DocVQA에서 평균 약 3,000개의 시각 토큰을 씀. 이 긴 토큰열이 추론 시간을 늘리고 GPU 메모리를 잡아먹어서, 여러 페이지(또는 영상 프레임)를 한 번에 넣는 시나리오를 사실상 막음.
저자들의 출발 직관은 NLP의 context compression임. 문단·문서를 소수의 요약 벡터로 압축해도 의미 대부분이 보존되듯, 문서 이미지의 시각 토큰도 레이아웃과 텍스트 정보를 유지한 채 더 압축할 수 있다는 가설임.
기존 연구의 한계
고해상도 문서를 다루는 주류는 crop 방식임. 고해상도 이미지를 저해상도 sub-image 여러 장으로 잘라 저해상도 인코더로 각각 처리하고, LLM이 그 관계를 이해함. crop 수를 늘리면 OCR-free 성능은 오르지만 시각 토큰이 한 페이지에만 1k를 훌쩍 넘어감(A4 한 장에 보통 >1k). 토큰 압축을 시도한 기존 구조는 정보 보존 ↔ 토큰 효율을 동시에 못 잡음. 크게 두 갈래임.
(a) crop별 독립 압축 (TokenPacker, DocOwl1.5 등) 각 sub-image를 따로 압축함. sub-image 한 장의 토큰은 줄지만, 전부 이어붙이면 결국 긴 시퀀스가 됨. 압축이 페이지 전체 길이를 못 줄임.
(b) learnable/selected query 가이드 압축 (Resampler, Q-former, TextMonkey 등) 학습된 쿼리나 선별 토큰을 압축 가이드로 써서 해상도와 무관하게 토큰 수를 고정함. 하지만 전체 레이아웃 정보를 무시함. 문서 압축에선 레이아웃이 중요함 — 같은 레이아웃 영역 안의 텍스트는 의미적으로 응집돼 요약하기 쉽기 때문임. 2단 논문에서 ‘Related Work’의 텍스트를 같은 줄에 있는 ‘Method’의 텍스트와 묶어 요약하면 망가지는 식임.
정리하면 (a)는 토큰을 충분히 못 줄이고, (b)는 줄이되 레이아웃을 잃음. 레이아웃을 아는 채로 토큰을 고정 길이까지 압축하는 게 미해결 과제임.
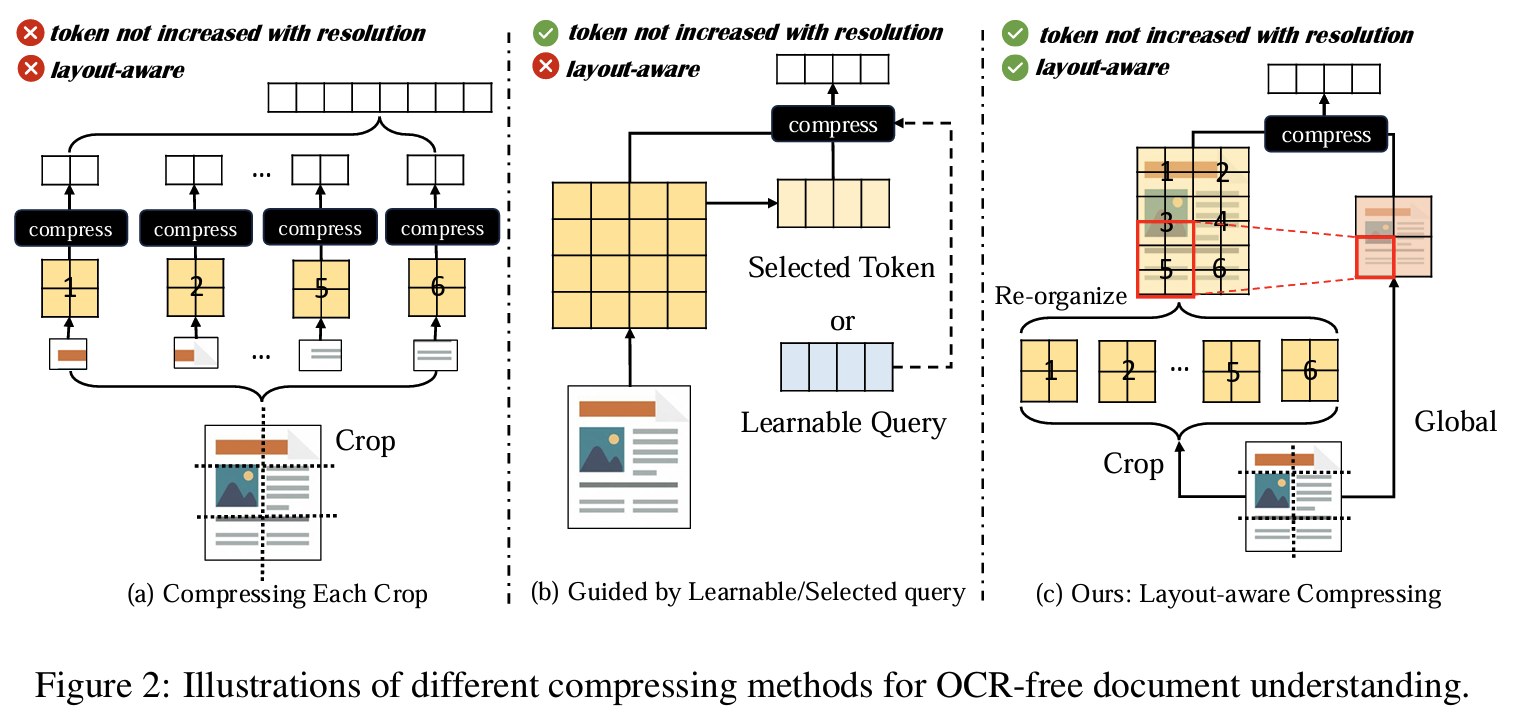 Figure 2: 압축 방식 비교 — (a) crop별 독립 압축, (b) learnable/selected query 가이드, (c) 본 논문의 레이아웃 인지 압축. (a)·(b)는 토큰이 해상도와 함께 늘거나 레이아웃을 잃는 반면, (c)는 둘 다 만족함.
2. 제안 방법: mPLUG-DocOwl2
DocOwl1.5 골격 위에 High-resolution DocCompressor라는 레이아웃 인지 압축 모듈을 얹어, 고해상도 페이지 한 장을 324 토큰으로 압축함. 단일·다중 이미지를 모두 지원하는 3-stage로 학습함.
2.1 핵심 아이디어
저해상도 global 이미지를 “레이아웃을 아는 압축 가이드(query)”로 삼아, 고해상도 sub-image들을 cross-attention으로 요약한다.
global 저해상도 이미지는 페이지 전체 레이아웃을 잘 담음. 그래서 global feature map의 각 토큰을 query로 두고, 그 토큰에 대응하는 원본 영역의 고해상도 토큰들(R×C개)만 key/value로 모아 cross-attention함. 페이지 전체가 아니라 위치가 맞는 조각끼리만 묶어 압축하므로, 정보 손실과 연산이 동시에 줄어듦. 결과적으로 한 페이지의 토큰 수가 global 저해상도 feature map 한 장 크기(= 324)로 고정됨. 해상도·crop 수가 늘어도 토큰 수는 안 늘어남.
같은 token redundancy를 셋이 서로 다르게 풂. DocOwl2(2024)는 “통째로 넣되 압축”, MinerU2.5/PaddleOCR-VL(2025)은 “애초에 내용 요소만 잘라 넣음”. DocOwl2는 페이지를 다 보지만 324 토큰으로 눌러담고, 후배들은 빈 공간을 아예 안 보냄. 또 DocOwl2가 global 저해상도 이미지를 압축 가이드로 쓰는 발상은, MinerU2.5가 다운샘플 thumbnail로 먼저 레이아웃을 잡는 발상과 한 몸임 — 싼 전역 시야로 비싼 세부 처리를 조직한다는 공통 패턴임. 단, DocOwl2는 이걸 파싱 출력이 아니라 LLM 이해를 위한 내부 표현 압축에 씀.
2.2 아키텍처
DocOwl1.5 기반의 LLaVA류 구조에 압축기를 추가함. 각 이미지는 동일 파이프라인으로 독립 인코딩됨.
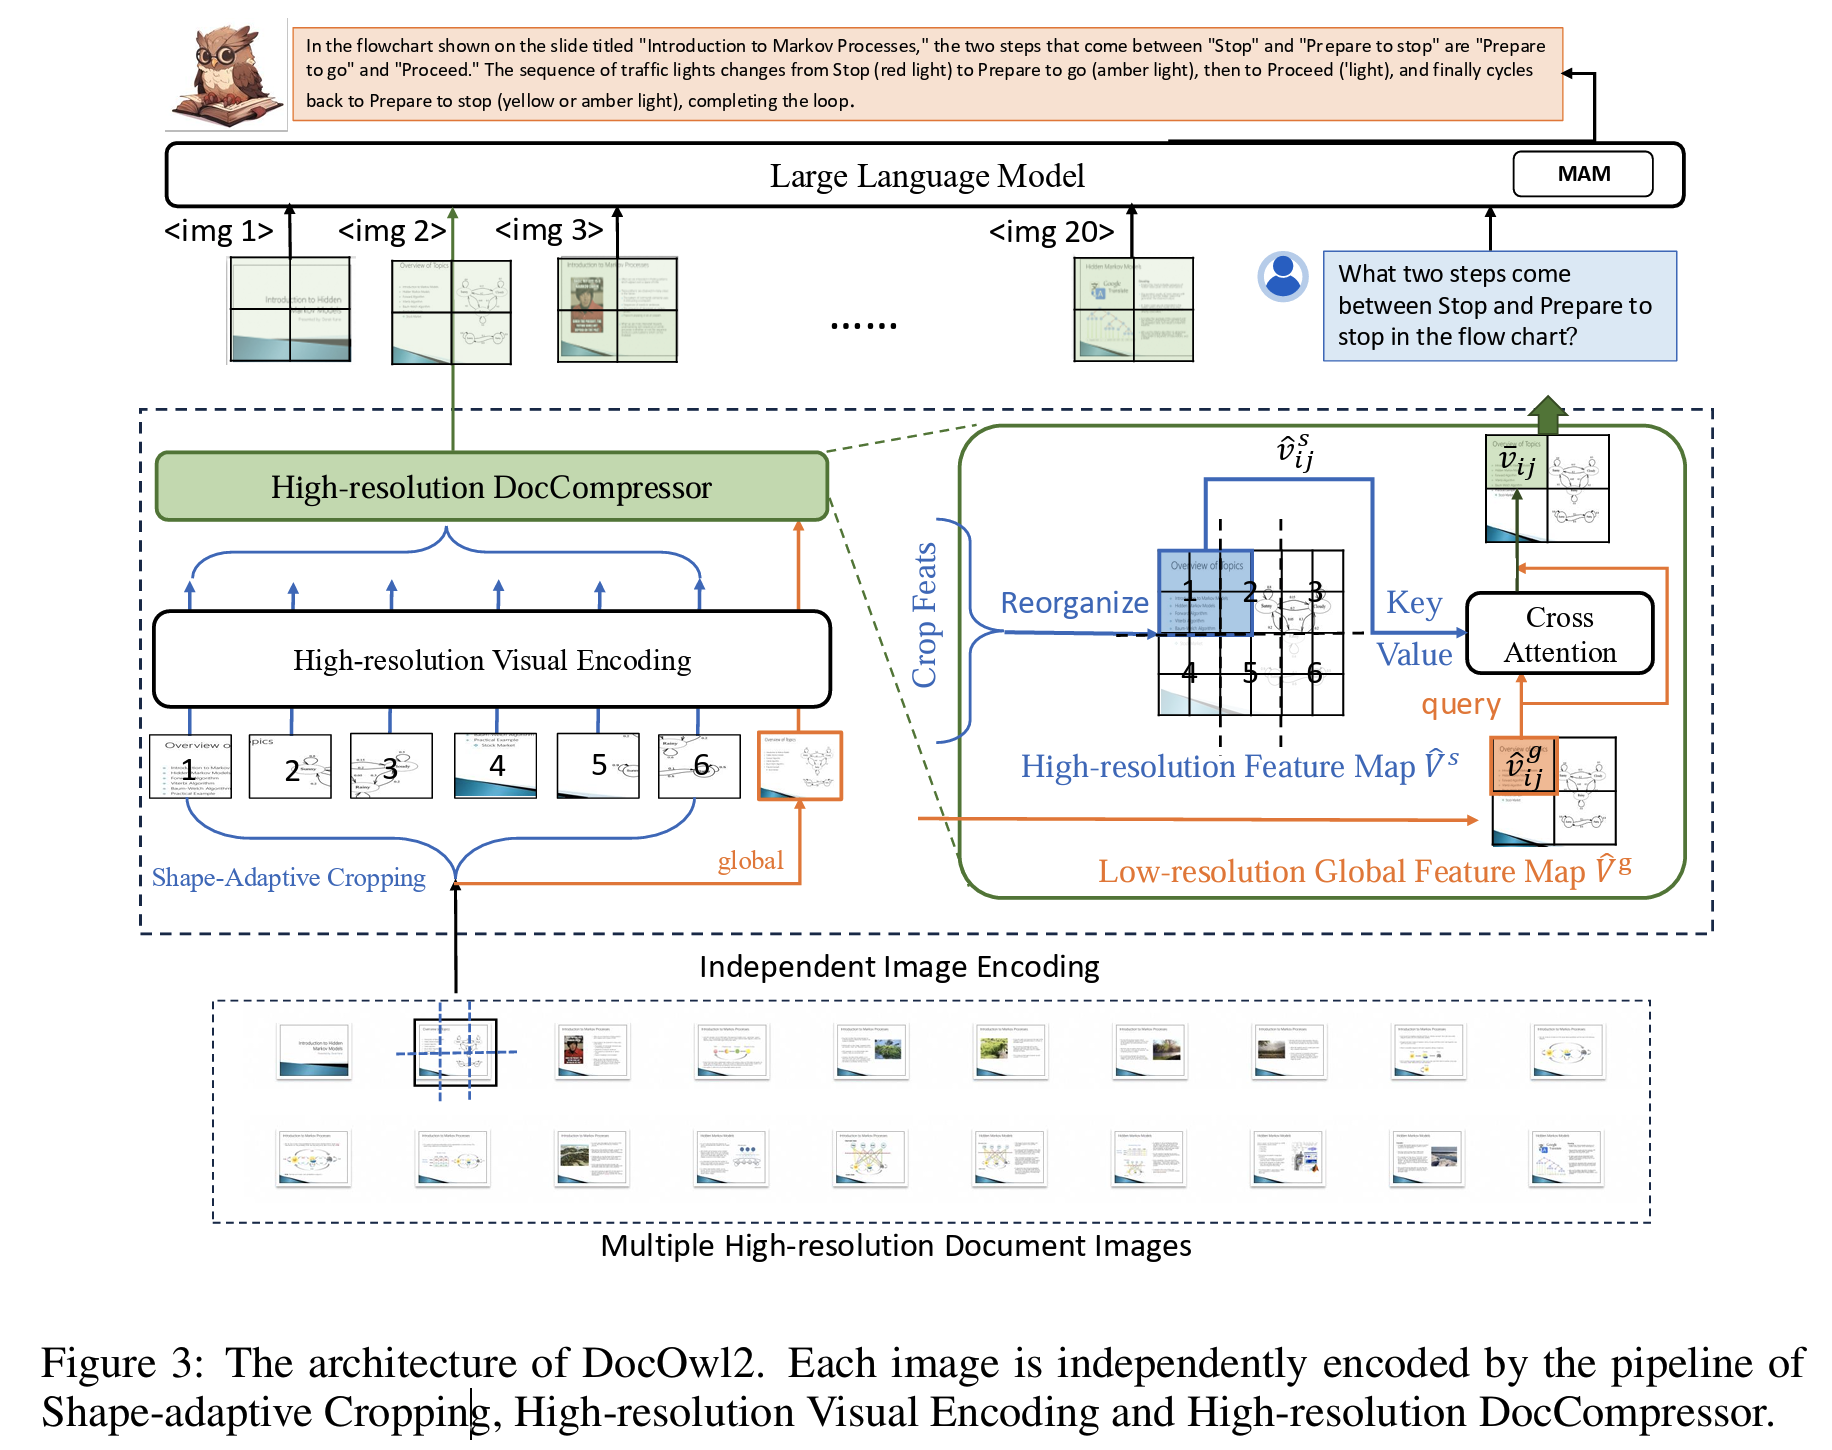 Figure 3: DocOwl2 아키텍처. 각 이미지는 Shape-adaptive Cropping → High-resolution Visual Encoding → High-resolution DocCompressor 파이프라인으로 독립 인코딩됨.
| 구성요소 | 내용 |
|---|---|
| Shape-adaptive Cropping | 파라미터 없는 모듈. 원해상도에 맞춰 R×C개 size-fixed sub-image로 자르고, 레이아웃 보존용 global 이미지도 따로 리사이즈. 둘 다 504×504 |
| 비전 인코더 | 저해상도 ViT/L-14 (mPLUG-Owl2에서 초기화). sub-image와 global을 같은 인코더로 인코딩(별도 고해상도 인코더 불필요) |
| H-Reducer (V2T) | conv로 가로 4개 feature를 묶고 FC로 LLM 차원에 정렬. 여기서 이미 토큰이 1/4로 줄어듦 |
| High-resolution DocCompressor | 2-layer cross-attention. global=query, 재정렬한 sub-image=key/value. H-Reducer 뒤에 배치 |
| 언어모델 | LLaMA 계열. 본체는 freeze, 시각·텍스트 feature를 구분하는 MAM(Modality Adaptive Module)만 학습 |
이미지마다 시각 feature 앞에 순서 토큰 <img x>를 붙여, LLM이 몇 번째 페이지인지 구분하게 함.
2.3 핵심 기술 ① 레이아웃 인지 group cross-attention
압축의 수식적 골자는 단순함. 먼저 sub-image들의 feature map을 원본 위치대로 하나의 완전한 map으로 재정렬함. 그다음 global map의 각 토큰 v^g_ij에 대해, 원본에서 같은 영역을 차지하는 R×C개의 sub-image 토큰만 모아 key/value로 cross-attention함(+residual). 즉 모든 query가 모든 토큰을 보는 게 아니라, 위치 대응이 맞는 그룹 안에서만 attention함.
이 “group attention”이 핵심임. global 토큰과 sub-image 토큰의 위치 대응이라는 신뢰할 수 있는 사전지식을 쓰는 것이고, ablation에서 group < complete(전체 attention)일 때 오히려 성능이 떨어짐을 보임. 위치를 무시하고 다 보게 하면 연산만 늘고 압축이 어려워짐.
2.4 핵심 기술 ② “왜 V2T 모듈 뒤에서 압축하나”
압축기를 ViT 직후가 아니라 H-Reducer(vision-to-text) 뒤에 두는 게 이 논문의 미묘하지만 중요한 선택임. 먼저 용어 정리: ViT는 시각 feature를 시각 공간(visual space)에 뱉음 — 픽셀·외형·국소 패턴을 인코딩한, 아직 “보기만 한” 표현임. H-Reducer는 여기에 conv로 가로 feature를 묶고 FC로 차원을 맞춰, 이 feature를 LLM이 쓰는 텍스트 feature 공간에 정렬(align)함. 정렬 후의 시각 토큰은 사실상 “문서의 어느 텍스트 조각을 인코딩한 텍스트류 토큰”으로 취급할 수 있게 됨.
핵심 논리는 이 정렬을 압축의 전제로 삼는 것임. 정렬이 끝난 토큰을 압축하는 건 곧 텍스트를 요약하는 것과 같다는 주장임. 이 논문 전체가 기대는 NLP의 context compression(문단·문서를 소수 요약 벡터로 눌러도 의미가 보존된다는 결과들)이 성립하려면, 압축 대상이 이미 “의미를 담은 텍스트류 표현”이어야 함. 그래서 V2T 뒤에서 압축하면 cross-attention이 의미 보존형 요약처럼 동작함. 반대로 ViT 직후(정렬 전)에 압축하면 아직 텍스트 의미로 조직되지 않은 raw 시각 feature를 뭉개는 셈이라, 무엇을 남기고 버릴지의 의미적 기준이 없어 visually-situated 텍스트 정보를 더 많이 잃음. 비유하면, 페이지를 픽셀 상태로 욱여넣어 요약하느냐 vs 일단 “글로 읽어낸” 뒤 요약하느냐의 차이임.
ablation(r4 vs r3)이 이 가설을 뒷받침함. V2T 뒤 압축(r3)이 ViT 뒤 압축(r4)보다 세 데이터셋 모두에서 우위임 — DocVQA 76.1 vs 75.7, WTQ 35.1 vs 33.3, ChartQA 69.2 vs 68.7. 격차 자체는 크지 않지만 일관됨. 특히 표 QA인 WTQ에서 격차가 가장 큼 — 표는 텍스트 밀도·구조 의존이 가장 높은 요소라, 텍스트 정렬의 이득이 거기서 가장 또렷이 드러남. 이 선택이 DocOwl2를 일반 시각 feature를 압축하는 Mini-Gemini류와 구분짓는 지점이기도 함 — 같은 “압축”이어도, 무엇을 압축하느냐(raw 시각 vs 텍스트 정렬 후)가 문서에서는 결과를 가른다는 게 저자들의 입장임.
2.6 정보의 두 축: 콘텐츠 vs 레이아웃
DocOwl2의 설계를 한눈에 잡으려면, 문서 정보를 직교하는 두 축으로 나눠 보면 됨. “무슨 글자/내용이냐”와 “어디에 뭐가 있냐”는 서로 파생되는 관계가 아니라 각각 따로 얻어 압축 단계에서 결합됨.
- 콘텐츠 축: 글리프(시각) → V2T → 의미. “무슨 글자/내용이냐”
- 레이아웃 축: global 저해상도 이미지 → 압축기 query. “어디에 뭐가 있냐”
- 압축기가 둘을 합침: 레이아웃 틀(global query) × 의미 세부(sub-image K/V) → group cross-attention → 324 토큰
여기서 주의할 점은 레이아웃이 “의미들을 조합해서 나오는 결과”가 아니라는 것임. global 저해상도 이미지가 페이지의 공간 배치를 미리 잡아 압축의 좌표 틀(query)로 쓰이고, 거기에 의미 있는 세부 토큰(sub-image, key/value)이 채워짐. 비유하면 빈 좌표 격자(레이아웃)를 먼저 깔고, 각 칸에 읽어낸 내용(의미)을 적어넣어 한 장으로 요약하는 구조임 — 격자가 글씨에서 유도되는 게 아니라, 격자가 먼저 있고 글씨가 거기 들어감.
2.7 학습 레시피
3-stage. 단일→다중 이미지로 능력을 확장함.
| 스테이지 | 입력 | 내용 | 대표 데이터 |
|---|---|---|---|
| ① Single-image Pretraining | 단일 | Unified Structure Learning(구조 인지 문서·표·차트·자연이미지 파싱)으로 압축 토큰이 정보를 잘 담게 함 | DocStruct4M (4.0M) |
| ② Multi-image Continue-Pretraining | 다중 | 대칭 두 task — Multi-page Text Parsing(지정 페이지 텍스트 인식)·Multi-page Text Lookup(텍스트가 몇 번째 페이지인지 찾기). 망각 방지로 DocStruct4M 0.5M 혼합 | MP-DocStruct1M (1.1M) |
| ③ Multi-task Finetuning | 단일+다중 | 단일(DocVQA·InfoVQA·ChartQA 등 DocDownstream-1.0, DocReason25K)과 다중(MP-DocVQA·DUDE·NewsVideoQA·MP-DocReason51K·DocGenome12K) 합쳐 instruction tuning | — |
구현은 최대 12 crop, sub/global 모두 504×504, 압축기 2-layer. Single-image 단계에서 ViT·H-Reducer·압축기 학습, 이후 ViT는 freeze, 마지막엔 ViT 빼고 전부 학습.
3. 실험 결과
3.1 단일 페이지 이해 (토큰 효율의 증명)
DocOwl2 8B는 페이지당 324 토큰으로 동작함. <1k 토큰 모델군에서 SOTA고, 같은 압축 목표의 TextMonkey(768)·TokenPacker보다 더 적은 토큰으로 더 나음. >1k 토큰 SOTA 대비 시각 토큰 20% 미만으로 10개 벤치 중 7개에서 80% 이상 성능을 냄.
| 모델 | 크기 | 토큰/이미지 | DocVQA | ChartQA | TextVQA |
|---|---|---|---|---|---|
| InternVL2 | 8B | ~3,133 | 91.6 | 83.3 | 77.4 |
| IXC 2.5 | 7B | ~5,118 | 90.9 | 82.2 | 78.2 |
| DocOwl 1.5 | 8B | ~1,698 | 82.2 | 70.2 | 68.6 |
| TextMonkey | 9B | 768 | 73.0 | 66.9 | 65.9 |
| DocOwl2 | 8B | 324 | 80.7 | 70.0 | 66.7 |
3.2 추론 속도 (First Token Latency)
토큰을 줄인 효과가 latency로 직결됨. DocVQA 기준 First Token Latency가 0.26초로, 토큰이 10배 많은 모델 대비 압도적임.
| 모델 | 토큰 | DocVQA FTL(s) ↓ |
|---|---|---|
| DocOwl2 | 324 | 0.26 |
| DocOwl 1.5 | ~1,806 | 0.58 |
| InternVL2 | ~3,198 | 0.94 |
| IXC 2.5 | ~7,395 | 3.73 |
가장 공정한 비교 대상인 자사 전작 DocOwl1.5 대비, 성능 98%를 유지하면서 토큰 ~20%·FTL 50% 절감임. 압축이 거의 공짜에 가깝다는 주장의 핵심 근거임.
3.3 Multi-page / 영상 이해 (본 무대)
페이지당 324 토큰이라 10장 넘는 페이지도 A100 한 장에 들어감. 더 적은 토큰으로 더 높은 ANLS와 더 낮은 FTL을 동시에 달성함.
| 모델 | 토큰/페이지 | MP-DocVQA | DUDE | NewsVideoQA |
|---|---|---|---|---|
| LongVA-7B | ~2,029 | 60.80 | 38.37 | 50.61 |
| Idefics3-8B | ~838 | 67.15 | 38.65 | 60.16 |
| LLaVA-next-interleave-7B | 729 | 44.87 | 28.03 | 56.66 |
| DocOwl2-8B | 324 | 69.42 | 46.77 | 64.09 |
3.4 Ablation 요지
이 논문은 ablation이 충실함(앞 두 논문의 약점을 여기선 보완).
- 압축 가이드: DocCompressor(global query) > CAbstractor(adaptive mean) > Resampler(learnable query). 레이아웃 인지 가이드의 가치 입증.
- 압축 위치: H-Reducer 뒤 > ViT 뒤. 텍스트 정렬 후 압축이 의미 보존에 유리.
- attention 범위: group(위치 대응) > complete(전체). 위치 사전지식이 효율적 압축의 열쇠.
- 가이드 방식: cross-attention(global query) > 단순 mean pooling.
- 압축기 깊이: 1·2·4 layer 차이 미미 → 압축엔 깊은 망이 불필요.
- 학습 단계: 3단계 각각이 기여. 특히 Multi-image Continue-Pretraining이 10페이지 초과 문서에서 큰 폭 개선.
4. 한계 및 비판
1) task가 파싱이 아니라 이해임 — 비교 축이 다름 DocOwl2의 출력은 구조화 Markdown/JSON이 아니라 질문에 대한 답임. MinerU2.5/PaddleOCR-VL과 같은 줄에 세워 “누가 더 좋은 파서냐”로 보면 범주 오류임. 오히려 DocOwl2는 두 논문이 비판한 end-to-end VLM 진영에 속하되, 그 진영의 효율 문제를 압축으로 완화한 사례로 읽어야 함.
2) 압축은 공짜가 아님 — 고정 324 토큰의 천장 페이지 내용량과 무관하게 토큰이 항상 324로 고정됨. 텍스트가 극단적으로 빽빽한 페이지에선 정보 손실이 불가피함. 실제로 단일 DocVQA에서 DocOwl1.5 82.2 → DocOwl2 80.7로 소폭 하락함. “comparable”이라 표현하지만 손실은 존재함. PaddleOCR-VL의 NaViT가 내용량에 비례해 토큰을 동적 할당하는 것과 대비되는 구조적 약점임.
3) global 가이드 의존의 잠재 위험 압축이 global 저해상도 feature의 레이아웃 파악에 의존함. global 시야가 미세 구조를 놓치면 그 영역 압축이 부실해짐. detector 기반 cascade보다는 덜 치명적이나, “전역 가이드가 곧 압축 품질”이라는 의존은 남아 있음.
4) 자기 전작 대비 비교의 한계 가장 강조되는 비교가 자사 DocOwl1.5와의 대조임(아키텍처·데이터 통제는 됐으니 ablation으로선 타당). 다만 “98% 성능 유지”류 헤드라인은 자기 기준선 대비임을 감안할 것.
5) 모델·벤치의 시대성 2024년 8B 모델에 LLaMA 계열 LLM, 그것도 freeze 상태라 언어 추론·문맥 보정 여력이 제한적임. ANLS 기반 DocVQA/MP-DocVQA 점수대도 이후 모델들에 상당 부분 추월됨. 지금 시점에선 “압축 아키텍처의 아이디어”가 본체이지 절대 점수가 본체는 아님.
5. 결론
1) 핵심 기여는 “레이아웃 인지 압축으로 페이지를 324 토큰에” High-resolution DocCompressor는 global 저해상도 feature를 query로, 재정렬한 고해상도 sub-image를 key/value로 cross-attention해, 고해상도 페이지 한 장을 324 토큰으로 압축함. 해상도·crop 수와 무관하게 토큰이 고정되는 게 결정적임.
2) 설계 핵심은 “싼 전역 시야로 비싼 세부를 조직” global 이미지로 레이아웃을 잡아 압축을 가이드하고, 위치 대응 group attention과 V2T-뒤 압축으로 텍스트 의미를 지킴. MinerU2.5의 다운샘플-thumbnail 레이아웃 패스와 같은 직관의 1년 앞선 버전으로 읽을 수 있음.
3) token redundancy 계보에서의 위치 “A4 한 장에 수천 토큰은 과잉”이라는 문제의식을 정면으로 명문화한 2024년 논문임. 같은 redundancy를 후배들은 “내용 요소만 잘라 넣기”로, DocOwl2는 “통째로 넣되 압축”으로 풂. 세 논문을 같이 읽으면, 고해상도 문서 VLM의 효율 경쟁이 “무엇을 토큰화하지 않을 것인가”라는 한 질문으로 수렴한다는 게 분명히 드러남. DocOwl2는 그 질문에 “압축”으로 답한 초기 이정표임.
배경 개념 정리
OCR-free document understanding 별도 OCR 엔진으로 텍스트를 먼저 뽑지 않고, MLLM이 이미지에서 곧장 텍스트·레이아웃을 이해해 질문에 답하는 방식임. 파이프라인이 단순하지만 고해상도 입력의 토큰 비용이 큰 게 약점이라, 이 논문의 압축이 그 약점을 직접 겨냥함.
Shape-adaptive Cropping 고해상도 이미지를 원해상도 종횡비에 맞춰 R×C개의 고정 크기 sub-image로 자르고, 전체 레이아웃 보존용 global 축소 이미지를 따로 두는 파라미터 없는 전처리임. UReader·DocOwl1.5에서 이어진 방식임.
H-Reducer (vision-to-text 모듈) ViT가 뽑은 시각 feature를 가로 방향 4개씩 conv로 묶어 토큰을 1/4로 줄이고, FC로 LLM의 hidden 차원에 정렬하는 모듈임. 이 시점에서 feature가 “텍스트 공간”에 들어오므로, 이후 압축이 텍스트 요약처럼 동작하게 만드는 전제임.
Cross-attention 압축 vs learnable query (Resampler·Q-former) Resampler·Q-former는 무작위 초기화된 학습 쿼리로 시각 feature를 압축함 — 일반 이미지의 객체 정보엔 통하지만, 빽빽한 문서 텍스트 요약엔 사전지식이 없어 불리함. DocOwl2는 학습 쿼리 대신 global 이미지의 실제 feature를 쿼리로 써서 레이아웃을 사전지식으로 주입함.
MAM (Modality Adaptive Module) LLM 내부에서 시각 토큰과 텍스트 토큰을 구분해 처리하도록 돕는 모듈(mPLUG-Owl2에서 도입). 본체 LLM을 freeze한 채 이 부분만 학습해, 적은 학습 비용으로 멀티모달 정렬을 유지함.
ANLS / First Token Latency(FTL) ANLS(Average Normalized Levenshtein Similarity)는 문서 VQA에서 예측 답과 정답의 문자열 유사도를 정규화해 매기는 표준 지표임. FTL은 입력을 받고 첫 출력 토큰이 나오기까지의 지연으로, 시각 토큰 수에 비례해 커지므로 이 논문의 효율 주장을 보여주는 핵심 수치임.